Описательная статистика: показатели, пример и как читать сводку
Описательная статистика сводит данные к нескольким числам: центр, разброс, форма. Показатели с формулами, расчёт вручную, сводка в SQL, describe() в pandas и Excel, ловушки.
Содержание статьи
Описательная статистика — это набор показателей и графиков, которые сводят данные к нескольким числам: где у значений центр, насколько они разбросаны и какой формы распределение. Минимальная сводка — число наблюдений n, среднее x̄ = Σx / n, стандартное отклонение s = √(Σ(x − x̄)² / (n − 1)), минимум, квартили и максимум; о тех, кого в таблице нет, она ничего не утверждает. Дальше — все показатели с формулами, расчёт на девяти числах, одна и та же сводка в SQL, pandas и Excel на учебной базе и случаи, когда аккуратная сводка описывает данные, которых не существует.
Что такое описательная статистика простыми словами
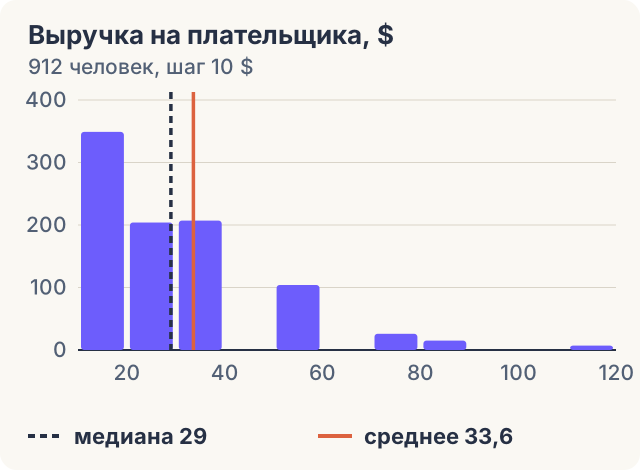
Вам выгрузили оплаты: 912 плательщиков и столько же сумм. Прочитать 912 чисел нельзя, а рассказать о них нужно сегодня. Описательная статистика (descriptive statistics) заменяет столбец короткой сводкой: плательщик принёс в среднем 33,60 доллара, половина — не больше 29, стандартное отклонение — 17,74, суммы лежат между 19 и 117.
Сводка отвечает на три вопроса. Какое значение типично — это центр. Насколько значения отличаются друг от друга — разброс. Симметрично ли они лежат вокруг центра и далеко ли уходят хвосты — форма.
Описательная статистика говорит только о данных, которые лежат в таблице. «912 плательщиков принесли в среднем 33,60 доллара» — факт об этой выгрузке. «У плательщиков такого продукта среднее лежит между 32,4 и 34,7 доллара» — уже статистика вывода (inferential statistics). Она переносит результат с выборки на генеральную совокупность, поэтому у неё есть интервал, допущения и вероятность ошибки. Сначала данные описывают, потом делают выводы.
- Центр: среднее, медиана, мода.
- Разброс: размах, межквартильный размах, дисперсия, стандартное отклонение, коэффициент вариации.
- Положение и форма: перцентили, асимметрия, эксцесс; график — гистограмма.
Какие показатели входят в описательную статистику
Все показатели собраны в таблице ниже: что считает каждый и где он подводит. Общее правило одно: показатели, построенные на суммах (среднее, стандартное отклонение, асимметрия, эксцесс), сдвигаются вслед за хвостом и крайними значениями; построенные на порядке (медиана, квартили, межквартильный размах) к ним устойчивы.
Квартили Q1, Q2 и Q3 — это 25-й, 50-й и 75-й перцентили; вместе с минимумом и максимумом они дают пятичисловую сводку. На ней основан ящик с усами (усы обычно обрезают на 1,5 · IQR от краёв ящика). Асимметрии и эксцессу посвящён отдельный раздел.
x̄ = Σx / n; s = √( Σ(x − x̄)² / (n − 1) ); IQR = Q3 − Q1x̄ — среднее, s — выборочное стандартное отклонение, n — число значений, Q1 и Q3 — первый и третий квартили. Делитель n − 1 — поправка для выборки; с ним считают `describe()`, `STDDEV_SAMP` и Excel. Если таблица и есть вся совокупность, делят на n (`STDDEV_POP`); при n = 912 разница в четвёртом знаке.
| Показатель | Формула | Что показывает | Когда обманывает |
|---|---|---|---|
| Среднее | x̄ = Σx / n | Точку равновесия значений | Хвост и выбросы тянут его к себе |
| Медиана | Середина упорядоченного ряда | Границу нижней половины данных | Общую по медианам групп не получить |
| Мода | Самое частое значение | Типичный вариант у категорий | У непрерывной величины её может не быть |
| Размах | R = max − min | Полную ширину ряда | Зависит от двух крайних точек и растёт с объёмом выборки |
| Межквартильный размах | IQR = Q3 − Q1 | Ширину средней половины данных | Ничего не говорит о хвостах |
| Дисперсия | s² = Σ(x − x̄)² / (n − 1) | Средний квадрат отклонения | Единицы измерения — в квадрате |
| Стандартное отклонение | s = √s² | Типичное отклонение от среднего | На скошенных данных «среднее ± s» уходит в невозможные значения |
| Коэффициент вариации | CV = s / x̄ · 100% | Разброс в процентах от среднего | Теряет смысл при среднем около нуля |
| Перцентили | Pₖ: ниже лежит k% значений | Границы «обычного» и хвосты | Крайние шумят на малых выборках |
| Асимметрия | Среднее от z³ | В какую сторону длиннее хвост | На десятках точек зависит от одного значения |
| Эксцесс | Среднее от z⁴ минус 3 | Насколько тяжелы хвосты | Плюс не отличает один выброс от тяжёлых хвостов, минус — плоское распределение от двух пиков |
Как посчитать показатели вручную: пример на девяти числах
Служба поддержки за девять дней получила 12, 15, 15, 16, 18, 20, 21, 24 и 39 обращений. Ряд уже упорядочен по возрастанию.
Центр. Сумма равна 180, среднее — 180 / 9 = 20. Медиана — пятое значение из девяти, это 18. Мода — 15: единственное число, которое встретилось дважды.
Разброс. Размах: 39 − 12 = 27. Квартили считаем так же, как percentile_cont в SQL, pandas и КВАРТИЛЬ.ВКЛ в Excel: позиция Q1 равна 1 + 0,25 · 8 = 3, третье значение — 15; позиция Q3 равна 1 + 0,75 · 8 = 7, седьмое значение — 21. Межквартильный размах: 21 − 15 = 6. Отклонения от среднего — −8, −5, −5, −4, −2, 0, 1, 4 и 19, сумма их квадратов — 512. Отсюда дисперсия 512 / 8 = 64 и стандартное отклонение 8.
Среднее 20 больше медианы 18 и моды 15: день с 39 обращениями тянет его вверх, и ниже среднего оказались пять дней из девяти. Уберите этот день — среднее упадёт до 17,6, стандартное отклонение с 8 до 3,89, размах с 27 до 12. Медиана сдвинется с 18 до 17, межквартильный размах — с 6 до 5,25. Показатели на суммах и крайних значениях зависят от одной точки, показатели на порядке её почти не замечают.
| Показатель | Расчёт | Значение |
|---|---|---|
| Среднее | 180 / 9 | 20 |
| Медиана | пятое значение из девяти | 18 |
| Мода | 15 встречается дважды | 15 |
| Размах | 39 − 12 | 27 |
| Q1 и Q3 | третье и седьмое значения | 15 и 21 |
| Межквартильный размах | 21 − 15 | 6 |
| Дисперсия | 512 / 8 | 64 |
| Стандартное отклонение | √64 | 8 |
| Коэффициент вариации | 8 / 20 | 40% |
С чего начинать: таблица частот и гистограмма
До сводки полезно посмотреть на сами значения. Для величины с небольшим числом вариантов это таблица частот: сколько раз встретилось каждое значение. Для непрерывной — гистограмма, где значения собраны в равные интервалы.
Сквозной пример — учебная база продукта «Маяк»: регистрации, события и оплаты подписочного сервиса за июнь–август 2026 года. Возьмём выручку на плательщика — сумму всех оплат одного пользователя. Тарифы стоят 19, 29 и 39 долларов в месяц, поэтому вариантов всего девять: 19 — одна оплата младшего тарифа, 38 — две, 58 — две оплаты по 29 и так далее.
38,3% плательщиков заплатили 19 долларов, 60,6% — не больше 29, а суммы 87 и 117 долларов набрали 2,4%. Распределение скошено вправо: много небольших значений и длинный хвост крупных. На гистограмме среднее 33,6 стоит правее медианы 29, и ниже среднего лежат те же 60,6% плательщиков. Пустые интервалы на ней — след трёх цен, а не формы спроса: у величины с девятью вариантами таблица частот точнее.
Оговорка об учебных данных: продление приходит через 30 дней после первой оплаты, и у тех, кто зарегистрировался в августе, продлений ещё нет. Это выручка на дату выгрузки, а не за весь срок жизни клиента.
WITH payer AS (
  SELECT user_id, SUM(amount) AS revenue
  FROM payments
  GROUP BY user_id
)
SELECT revenue, COUNT(*) AS payers,
  ROUND(100.0 * COUNT(*) / SUM(COUNT(*)) OVER (), 1) AS share_pct,
  ROUND(100.0 * SUM(COUNT(*)) OVER (ORDER BY revenue)
        / SUM(COUNT(*)) OVER (), 1) AS cumulative_pct
FROM payer
GROUP BY revenue
ORDER BY revenue;
--  19  349  38.3   38.3
--  29  204  22.4   60.6
--  38  138  15.1   75.8
--  39   69   7.6   83.3
--  57   27   3.0   86.3
--  58   77   8.4   94.7
--  78   26   2.9   97.6
--  87   15   1.6   99.2
-- 117    7   0.8  100.0
Как получить сводку в SQL и что показывает describe() в pandas
В SQL сводку собирают агрегатные функции: COUNT, AVG, STDDEV_SAMP, MIN, MAX и PERCENTILE_CONT для квартилей. Запрос ниже считает её для двух величин: выручки на плательщика и DAU — числа активных пользователей за день. Ряд DAU взят за 1–29 августа: тридцатое число в выгрузке неполное, события обрываются в 12:59.
В pandas то же делает метод describe(). Его строки: count — число непустых значений; mean — среднее; std — стандартное отклонение с делителем n − 1, как STDDEV_SAMP; min и max; 25%, 50% и 75% — квартили с линейной интерполяцией, как PERCENTILE_CONT. Все восемь чисел совпали с запросом.
У выручки среднее 33,60 выше медианы 29, минимум совпал с первым квартилем, а от третьего квартиля до максимума 79 долларов при 19 долларах от минимума до третьего квартиля. Это хвост вправо. У DAU среднее 486,93 и медиана 491 расходятся меньше чем на процент, минимум и максимум отстоят от медианы на 85 и 95 пользователей: заметного хвоста нет.
Чего в describe() нет: моды, размаха, суммы и показателей формы. Пропуски в count не входят, поэтому count меньше числа строк — признак пропусков. Для текстового столбца набор строк другой: count, unique, top и freq. У столбца country в таблице users это 4 558 заполненных значений из 4 613, четыре страны, самая частая — RU, 2 715 раз.
WITH payer AS (
  SELECT user_id, SUM(amount) AS x
  FROM payments
  GROUP BY user_id
),
days AS (
  SELECT CAST(event_time AS date) AS day, COUNT(DISTINCT user_id) AS x
  FROM events
  WHERE event_time >= TIMESTAMP '2026-08-01'
    AND event_time <  TIMESTAMP '2026-08-30'
  GROUP BY CAST(event_time AS date)
)
SELECT 'выручка на плательщика' AS metric, COUNT(*) AS n,
  ROUND(AVG(x), 2) AS mean,
  ROUND(CAST(STDDEV_SAMP(x) AS numeric), 2) AS sd,
  MIN(x) AS min_x,
  PERCENTILE_CONT(0.25) WITHIN GROUP (ORDER BY x) AS q1,
  PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY x) AS median,
  PERCENTILE_CONT(0.75) WITHIN GROUP (ORDER BY x) AS q3,
  MAX(x) AS max_x
FROM payer
UNION ALL
SELECT 'DAU, 1–29 августа', COUNT(*),
  ROUND(AVG(x), 2),
  ROUND(CAST(STDDEV_SAMP(x) AS numeric), 2),
  MIN(x),
  PERCENTILE_CONT(0.25) WITHIN GROUP (ORDER BY x),
  PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY x),
  PERCENTILE_CONT(0.75) WITHIN GROUP (ORDER BY x),
  MAX(x)
FROM days
ORDER BY n DESC;
-- выручка на плательщика  912   33.60  17.74   19   19   29   38  117
-- DAU, 1–29 августа 29 486.93 44.06 406 454 491 505 586import numpy as np
import pandas as pd
# выручка на плательщика: суммы и число плательщиков из таблицы частот
amounts = [19, 29, 38, 39, 57, 58, 78, 87, 117]
payers = [349, 204, 138, 69, 27, 77, 26, 15, 7]
revenue = pd.Series(np.repeat(amounts, payers), name="revenue")
dau = pd.Series(
[428, 406, 443, 419, 485, 499, 446, 457, 441, 444, 454, 494, 503, 498, 491,
459, 505, 467, 531, 502, 519, 482, 495, 484, 529, 568, 556, 586, 530],
name="dau",
)
print(pd.concat([revenue.describe(), dau.describe()], axis=1).round(2))
# revenue dau
# count 912.00 29.00
# mean 33.60 486.93
# std 17.74 44.06
# min 19.00 406.00
# 25% 19.00 454.00
# 50% 29.00 491.00
# 75% 38.00 505.00
# max 117.00 586.00Что выдаёт «Описательная статистика» в Excel
В Excel сводку строит надстройка «Пакет анализа». Включают её так: Файл → Параметры → Надстройки → «Надстройки Excel» → Перейти → флажок «Пакет анализа» (на Mac — Сервис → Надстройки Excel). После этого на вкладке «Данные» появляется кнопка «Анализ данных», а в её списке — инструмент «Описательная статистика». Справка Microsoft описывает его как одномерный статистический отчёт о центральной тенденции и изменчивости входных данных.
В окне инструмента указывают входной интервал и отмечают «Итоговая статистика». Получается столбец из тринадцати строк. В таблице — что стоит за каждой и что выйдет для выручки на плательщика; значения посчитаны теми же формулами в SQL и pandas; Excel покажет их без округления.
Три места, где отчёт Excel легко прочитать неверно. «Интервал» — это размах, к доверительному интервалу он отношения не имеет. «Асимметричность» и «Эксцесс» посчитаны с поправкой на смещение — как функции СКОС и ЭКСЦЕСС и методы skew() и kurt() в pandas; scipy.stats по умолчанию считает иначе. Квартилей в отчёте нет, их добавляют функцией КВАРТИЛЬ.ВКЛ.
Если все значения разные, как у дневного DAU, вместо моды Excel покажет #Н/Д, а MODE() WITHIN GROUP (ORDER BY x) в SQL молча вернёт первое по порядку сортировки значение — 406, хотя моды у такого ряда нет. А флажок уровня надёжности добавляет строку с полушириной доверительного интервала для среднего, у нас 1,15 доллара. Это уже шаг в статистику вывода.
| Строка отчёта | Что это | Значение |
|---|---|---|
| Среднее | Среднее арифметическое | 33,60 |
| Стандартная ошибка | s / √n — точность среднего | 0,59 |
| Медиана | Середина ряда | 29 |
| Мода | Самое частое значение | 19 |
| Стандартное отклонение | s с делителем n − 1 | 17,74 |
| Дисперсия выборки | s² | 314,75 |
| Эксцесс | Избыточный, с поправкой | 3,83 |
| Асимметричность | С поправкой | 1,77 |
| Интервал | Размах | 98 |
| Минимум | 19 | |
| Максимум | 117 | |
| Сумма | 30 639 | |
| Счет | Число значений n | 912 |
WITH payer AS (
  SELECT user_id, SUM(amount) AS x
  FROM payments
  GROUP BY user_id
)
SELECT
  ROUND(AVG(x), 2) AS mean,
  ROUND(CAST(STDDEV_SAMP(x) / SQRT(COUNT(*)) AS numeric), 2) AS std_error,
  PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY x) AS median,
  MODE() WITHIN GROUP (ORDER BY x) AS mode,
  ROUND(CAST(STDDEV_SAMP(x) AS numeric), 2) AS sd,
  ROUND(CAST(VAR_SAMP(x) AS numeric), 2) AS variance,
  MAX(x) - MIN(x) AS range,
  SUM(x) AS total,
  COUNT(*) AS n
FROM payer;
-- 33.60  0.59  29  19  17.74  314.75  98  30639  912
Что такое асимметрия и эксцесс и как их считать
Асимметрия (skewness) показывает, в какую сторону у распределения длиннее хвост. Каждое значение переводят в z-оценку — отклонение от среднего в стандартных отклонениях, — возводят в куб и усредняют. Куб сохраняет знак: у симметричных данных получается ноль, длинный хвост справа даёт плюс, слева — минус. Обратное не гарантировано: ноль возможен и без симметрии, поэтому число сверяют с гистограммой.
Эксцесс (kurtosis) устроен так же, но с четвёртой степенью: он растёт, когда в данных есть значения далеко от среднего. У нормального распределения он равен 3, поэтому из результата обычно вычитают тройку и получают избыточный эксцесс. Ноль — хвосты как у нормального распределения, плюс — тяжелее, минус — легче. Тройку по умолчанию вычитают и scipy.stats.kurtosis, и pandas, и Excel; без вычитания у плательщиков получится 6,80. В справке Excel и старых учебниках эксцесс называют островершинностью; точнее читать его как меру хвостов: высоту пика он не измеряет.
На учебной базе выручка на пользователя вместе с теми, кто не платил (4 613 человек, у 80,2% — ноль), даёт асимметрию 2,83 и эксцесс 9,38. Только плательщики — 1,77 и 3,80. DAU за август — 0,28 и −0,38, почти симметрично.
Две оговорки о расчёте. Первая — поправка на смещение: формула ниже делит на n, а Excel и pandas вводят множители, зависящие от n. На 912 значениях разница в сотых — эксцесс 3,80 и 3,83. На 29 днях она заметнее: −0,38 и −0,21. На девяти числах из примера с обращениями асимметрия равна 1,58 без поправки и 1,91 с ней. Вторая — малые выборки: у 29 значений из нормального распределения стандартная ошибка асимметрии с поправкой около 0,43, и 0,29 у DAU меньше одной такой ошибки. Это грубый ориентир: формула рассчитана на независимые наблюдения, а соседние дни DAU связаны трендом.
В PostgreSQL готовых функций нет, поэтому запрос считает оба показателя через z-оценки. В DuckDB есть skewness() и kurtosis(), но они возвращают значения с поправкой: для плательщиков 1,774 и 3,830.
g₁ = Σ((x − x̄) / σ)³ / n; g₂ = Σ((x − x̄) / σ)⁴ / n − 3σ — стандартное отклонение с делителем n. Так считает scipy.stats по умолчанию; Excel и pandas добавляют поправку на смещение.
WITH per_user AS (
  SELECT u.user_id, COALESCE(SUM(p.amount), 0) AS x
  FROM users u
  LEFT JOIN payments p ON p.user_id = u.user_id
  GROUP BY u.user_id
),
days AS (
  SELECT CAST(event_time AS date) AS day, COUNT(DISTINCT user_id) AS x
  FROM events
  WHERE event_time >= TIMESTAMP '2026-08-01'
    AND event_time <  TIMESTAMP '2026-08-30'
  GROUP BY CAST(event_time AS date)
),
labelled AS (
  SELECT 'выручка на пользователя' AS metric, x FROM per_user
  UNION ALL
  SELECT 'выручка на плательщика', x FROM per_user WHERE x > 0
  UNION ALL
  SELECT 'DAU, 1–29 августа', x FROM days
),
moments AS (
  SELECT metric, AVG(x) AS m, STDDEV_POP(x) AS s
  FROM labelled
  GROUP BY metric
)
SELECT l.metric, COUNT(*) AS n,
  ROUND(CAST(AVG(POWER((l.x - m.m) / m.s, 3)) AS numeric), 2) AS skewness,
  ROUND(CAST(AVG(POWER((l.x - m.m) / m.s, 4)) - 3 AS numeric), 2) AS excess_kurtosis
FROM labelled l
JOIN moments m ON m.metric = l.metric
GROUP BY l.metric
ORDER BY n DESC;
-- выручка на пользователя  4613  2.83   9.38
-- выручка на плательщика    912  1.77   3.80
-- DAU, 1–29 августа 29 0.28 -0.38import numpy as np
import pandas as pd
from scipy import stats
payer = np.repeat([19, 29, 38, 39, 57, 58, 78, 87, 117],
[349, 204, 138, 69, 27, 77, 26, 15, 7])
user = np.concatenate([np.zeros(4613 - 912), payer]) # 3 701 пользователь без оплат
dau = np.array([428, 406, 443, 419, 485, 499, 446, 457, 441, 444, 454, 494, 503, 498, 491,
459, 505, 467, 531, 502, 519, 482, 495, 484, 529, 568, 556, 586, 530])
for name, x in [("на пользователя", user), ("на плательщика", payer), ("DAU", dau)]:
print(f"{name:16}"
f"{stats.skew(x):6.2f}{stats.kurtosis(x):7.2f}" # делитель n
f"{stats.skew(x, bias=False):7.2f}{stats.kurtosis(x, bias=False):7.2f}") # с поправкой
# на пользователя 2.83 9.38 2.83 9.39
# на плательщика 1.77 3.80 1.77 3.83
# DAU 0.28 -0.38 0.29 -0.21
print(round(stats.kurtosis(payer, fisher=False), 2)) # 6.8 — без вычитания тройки
print(round(pd.Series(dau).skew(), 2), round(pd.Series(dau).kurt(), 2)) # 0.29 -0.21, как в ExcelПочему одна сводка на две группы обманывает
Регистрации по дням за 1–29 августа: среднее 65,3, медиана 76, стандартное отклонение 22,6. Сводка аккуратная, но дня с 65 регистрациями в августе не было. В будни их от 72 до 88, в выходные — от 28 до 38, а между 38 и 72 нет ни одного дня из 29. Среднее попало в пустоту между двумя режимами.
Сама сводка на это намекает: первый квартиль 37 далеко от третьего 82, а эксцесс равен −1,29 — так бывает, когда значения собраны в двух удалённых группах. Надёжнее всего смесь видна на гистограмме: столбцы по краям и пустая середина. После разбиения каждая сводка осмысленна: в будни 80,0 при стандартном отклонении 5,2, в выходные 32,9 при 3,3.
То же с выручкой на пользователя. По всем 4 613 зарегистрированным среднее равно 6,64 доллара, медиана — нулю, стандартное отклонение — 15,53. Среднее минус одно стандартное отклонение даёт −8,89 доллара, хотя отрицательной выручки не бывает. И 6,64 доллара не заплатил никто: 80,2% не платили совсем, а минимальная оплата — 19. В одном столбце лежат две группы, и описывать их стоит двумя числами: долей плательщиков (912 из 4 613, или 19,8%) и сводкой по плательщикам.
Правило «в пределах одного стандартного отклонения от среднего лежит около 68% значений» верно для нормального распределения. У выручки на пользователя в этот интервал попадает 87,8% значений, у плательщиков — 83,3%.
Учебная база симулятора SQL-аналитика, 1–29 августа 2026. Левый пик — выходные, правый — будни; среднее 65,3 попадает в пустой интервал 60–69.
WITH daily AS (
  SELECT signup_date AS day, COUNT(*) AS x
  FROM users
  WHERE signup_date >= DATE '2026-08-01' AND signup_date < DATE '2026-08-30'
  GROUP BY signup_date
),
labelled AS (
  SELECT 'все дни' AS day_type, x FROM daily
  UNION ALL
  SELECT CASE WHEN EXTRACT(isodow FROM day) >= 6 THEN 'выходные' ELSE 'будни' END, x
  FROM daily
)
SELECT day_type, COUNT(*) AS days,
  ROUND(AVG(x), 1) AS mean,
  ROUND(CAST(STDDEV_SAMP(x) AS numeric), 1) AS sd,
  MIN(x) AS min_x,
  PERCENTILE_CONT(0.25) WITHIN GROUP (ORDER BY x) AS q1,
  PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY x) AS median,
  PERCENTILE_CONT(0.75) WITHIN GROUP (ORDER BY x) AS q3,
  MAX(x) AS max_x
FROM labelled
GROUP BY day_type
ORDER BY days DESC;
-- все дни   29  65.3  22.6  28  37     76  82    88
-- будни     20  80.0   5.2  72  75.75  80  83.5  88
-- выходные 9 32.9 3.3 28 31 33 35 38WITH per_user AS (
SELECT u.user_id, COALESCE(SUM(p.amount), 0) AS x
FROM users u
LEFT JOIN payments p ON p.user_id = u.user_id
GROUP BY u.user_id
),
labelled AS (
SELECT 'все пользователи' AS grp, x FROM per_user
UNION ALL
SELECT 'только плательщики', x FROM per_user WHERE x > 0
),
summary AS (
SELECT grp, AVG(x) AS m, STDDEV_SAMP(x) AS s
FROM labelled
GROUP BY grp
)
SELECT l.grp, COUNT(*) AS n,
ROUND(CAST(s.m AS numeric), 2) AS mean,
ROUND(CAST(s.s AS numeric), 2) AS sd,
PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY l.x) AS median,
ROUND(CAST(s.m - s.s AS numeric), 2) AS mean_minus_sd,
ROUND(100.0 * SUM(CASE WHEN l.x BETWEEN s.m - s.s AND s.m + s.s THEN 1 ELSE 0 END)
/ COUNT(*), 1) AS within_1sd_pct
FROM labelled l
JOIN summary s ON s.grp = l.grp
GROUP BY l.grp, s.m, s.s
ORDER BY n DESC;
-- все пользователи 4613 6.64 15.53 0 -8.89 87.8
-- только плательщики 912 33.60 17.74 29 15.85 83.3Что делают со сводкой тренд и неполный день
Сводка молча предполагает, что все значения взяты из одного и того же процесса. У ряда с трендом это не так. DAU за все 90 полных дней выгрузки, с 1 июня по 29 августа: среднее 328,5, стандартное отклонение 147,8. Но аудитория росла примерно на 5,5 пользователя в день: в июне в среднем 153,5, в июле 349,7, в августе 486,9. Среднее за 90 дней соответствует уровню первых трёх недель июля: в пределах ±10% от него лежат 7 дней из 90, все между 3 и 19 июля.
Стандартное отклонение 147,8 здесь измеряет рост. Колебания от дня к дню гораздо меньше: вокруг линии тренда отклонение равно 29,1, в пять раз ниже. Для растущей метрики сводку считают по окну, где уровень примерно постоянен, или по отклонениям от тренда. Август тоже не идеален: DAU растёт и внутри него, и большая часть его 44,1 — рост: вокруг прямой отклонение 25,9.
Вторая ловушка ряда — неполный период. Добавим 30 августа, где события обрываются в 12:59 и DAU равен 223. Минимум падает с 406 до 223, размах вырастает со 180 до 363, стандартное отклонение — с 44,1 до 64,8. Асимметрия меняется с 0,28 на −1,87, эксцесс — с −0,38 на 6,22. Медиана при этом сдвигается с 491 до 488, межквартильный размах — с 51 до 56,5. Среднее сдвинулось на 1,8% — с 486,9 до 478,1. Зато одна точка переписала размах и всё, что построено на степенях отклонений: стандартное отклонение, асимметрию и эксцесс.
WITH days AS (
  SELECT CAST(event_time AS date) AS day, COUNT(DISTINCT user_id) AS x
  FROM events
  WHERE event_time < TIMESTAMP '2026-08-30'
  GROUP BY CAST(event_time AS date)
),
labelled AS (
  SELECT 'весь период' AS period, day, x FROM days
  UNION ALL
  SELECT CASE EXTRACT(month FROM day)
           WHEN 6 THEN 'июнь' WHEN 7 THEN 'июль' ELSE 'август' END, day, x
  FROM days
)
SELECT period, COUNT(*) AS days,
  ROUND(AVG(x), 1) AS mean,
  ROUND(CAST(STDDEV_SAMP(x) AS numeric), 1) AS sd,
  MIN(x) AS min_x,
  PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY x) AS median,
  MAX(x) AS max_x
FROM labelled
GROUP BY period
ORDER BY MIN(day), days DESC;
-- весь период  90  328.5  147.8   32  344.5  586
-- июнь         30  153.5   61.3   32  150    249
-- июль         31  349.7   63.2  257  354    480
-- август 29 486.9 44.1 406 491 586WITH days AS (
SELECT CAST(event_time AS date) AS day, COUNT(DISTINCT user_id) AS x
FROM events
WHERE event_time >= TIMESTAMP '2026-08-01'
GROUP BY CAST(event_time AS date)
),
labelled AS (
SELECT '1–29 августа' AS period, x FROM days WHERE day < DATE '2026-08-30'
UNION ALL
SELECT '1–30 августа', x FROM days
)
SELECT period, COUNT(*) AS days,
MIN(x) AS min_x,
MAX(x) - MIN(x) AS range,
ROUND(AVG(x), 1) AS mean,
ROUND(CAST(STDDEV_SAMP(x) AS numeric), 1) AS sd,
PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY x) AS median,
PERCENTILE_CONT(0.75) WITHIN GROUP (ORDER BY x)
- PERCENTILE_CONT(0.25) WITHIN GROUP (ORDER BY x) AS iqr
FROM labelled
GROUP BY period
ORDER BY days;
-- 1–29 августа 29 406 180 486.9 44.1 491 51
-- 1–30 августа 30 223 363 478.1 64.8 488 56.5Могут ли разные данные дать одинаковую сводку: квартет Энскомба
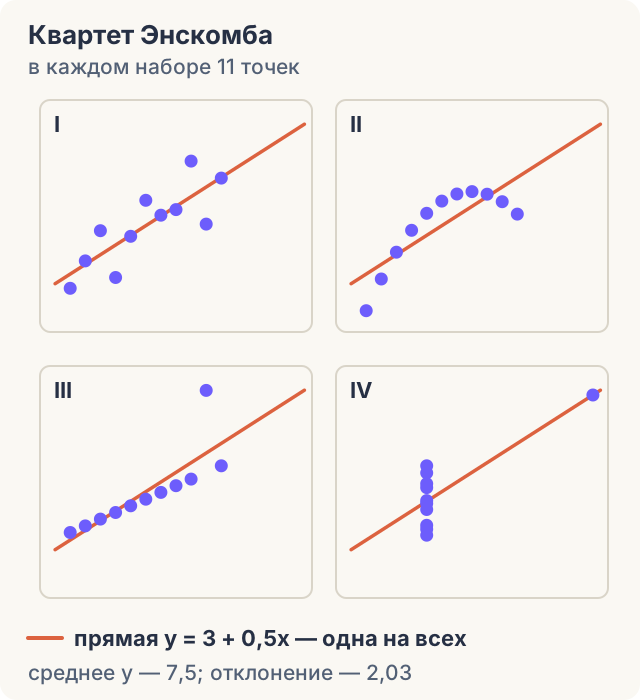
Могут. В 1973 году статистик Фрэнсис Энскомб опубликовал в журнале The American Statistician статью «Graphs in Statistical Analysis» с четырьмя наборами данных по одиннадцать пар чисел. Наборы подобраны так, чтобы показать, зачем до расчётов смотреть на график.
У всех четырёх совпадают среднее x (9) и его дисперсия (11), среднее y (7,50), стандартное отклонение y (2,03), корреляция (0,82) и прямая регрессии y = 3,00 + 0,50x. На графиках при этом четыре разные картины: облако вокруг прямой, дуга, ровная линия с одним выбросом и столбик точек с одной далёкой.
Полезная подробность: одинаковы только показатели, построенные на суммах и квадратах. Медиана y в четырёх наборах равна 7,58, 8,14, 7,11 и 7,04, асимметрия — от −1,13 до 1,59. Сводка с квартилями и формой различие выдала бы, пара «среднее и стандартное отклонение» — нет.
import numpy as np
from scipy import stats

x123 = [10, 8, 13, 9, 11, 14, 6, 4, 12, 7, 5]
quartet = {
    "I":   (x123, [8.04, 6.95, 7.58, 8.81, 8.33, 9.96, 7.24, 4.26, 10.84, 4.82, 5.68]),
    "II":  (x123, [9.14, 8.14, 8.74, 8.77, 9.26, 8.10, 6.13, 3.10, 9.13, 7.26, 4.74]),
    "III": (x123, [7.46, 6.77, 12.74, 7.11, 7.81, 8.84, 6.08, 5.39, 8.15, 6.42, 5.73]),
    "IV":  ([8, 8, 8, 8, 8, 8, 8, 19, 8, 8, 8],
            [6.58, 5.76, 7.71, 8.84, 8.47, 7.04, 5.25, 12.50, 5.56, 7.91, 6.89]),
}

print("набор  среднее    s     r   прямая         медиана  асимметрия")
for name, (x, y) in quartet.items():
    x, y = np.array(x, dtype=float), np.array(y)
    slope, intercept = np.polyfit(x, y, 1)
    print(f"{name:5}{y.mean():8.2f}{y.std(ddof=1):7.2f}{np.corrcoef(x, y)[0, 1]:6.2f}"
          f"   {intercept:.2f} + {slope:.2f}x{np.median(y):9.2f}{stats.skew(y):10.2f}")
# набор  среднее    s     r   прямая         медиана  асимметрия
# I        7.50   2.03  0.82   3.00 + 0.50x     7.58     -0.06
# II       7.50   2.03  0.82   3.00 + 0.50x     8.14     -1.13
# III      7.50   2.03  0.82   3.00 + 0.50x     7.11      1.59
# IV 7.50 2.03 0.82 3.00 + 0.50x 7.04 1.29Частые вопросы
Какие показатели описательной статистики указывать в отчёте? Число наблюдений и пару «центр и разброс». Для распределения, близкого к симметричному, — среднее и стандартное отклонение. Для скошенного — медиану и квартили, а хвост показывают перцентилями P90–P99.
В Excel нет кнопки «Анализ данных» — что делать? Включить надстройку «Пакет анализа» или обойтись без неё: те же числа дают функции СРЗНАЧ, МЕДИАНА, МОДА.ОДН, СТАНДОТКЛОН.В, КВАРТИЛЬ.ВКЛ, СКОС и ЭКСЦЕСС.
Как добавить в describe() другие перцентили и текстовые столбцы? Перцентили задаёт аргумент percentiles: df.describe(percentiles=[0.1, 0.5, 0.9]) выведет 10%, 50% и 90%. Медиану указывайте явно: до pandas 3.0 она добавлялась сама, с версии 3.0 выводятся только перечисленные перцентили. Аргумент include="all" добавит текстовые столбцы со строками unique, top и freq.
Какие асимметрия и эксцесс считаются нормальными? У нормального распределения оба показателя равны нулю, если эксцесс избыточный. Вопросов два. Отличим ли результат от шума — подскажет стандартная ошибка: для асимметрии около √(6 / n), при n = 912 это 0,08, при n = 29 — 0,45. Велика ли скошенность — вопрос размера: на практике до 0,5 по модулю считают слабой, больше 1 — сильной; это соглашение, а не закон.
Как описать новый набор данных за 10 минут
Порядок ниже ловит ошибки из этой статьи: смесь групп, скошенность, тренд и неполный период.
Проверить себя можно в песочнице симулятора SQL-аналитика: она работает на этой же базе, и запросы статьи там выполняются. Пройдите список для числа событий на пользователя (SELECT user_id, COUNT(*) FROM events GROUP BY user_id). Должно получиться 4 613 пользователей, среднее 7,66, стандартное отклонение 3,55, минимум 1, квартили 5, 7 и 10, максимум 22, мода 6. Среднее и медиана близки, асимметрия равна 0,39 — слабый хвост вправо.
- Единица наблюдения и период. Что такое одна строка, полон ли последний день, не размножил ли строки JOIN; то же потом назовите в отчёте.
- Количество. Число строк и непустых значений — расхождение означает пропуски; число уникальных значений ключа — расхождение означает дубли.
- Таблица частот или гистограмма. Один пик или несколько, есть ли хвост и невозможные значения вроде отрицательной суммы.
- Сводка. n, среднее, стандартное отклонение, минимум, Q1, медиана, Q3, максимум.
- Смесь. Пересчитайте сводку по очевидным группам: будни и выходные, платящие и нет, каналы, устройства.
- Время. Постройте ряд по дням; при тренде считайте сводку по окну без роста.
- Среднее против медианы. Если смеси и тренда нет: близки — описывайте средним и стандартным отклонением; разошлись — медианой и квартилями.
Материалы по теме
Математическое ожидание: что это, формула и примеры
Математическое ожидание простыми словами: среднее, к которому результат сходится в долгую. Формула, пример на кубике, расчёт в SQL и Python, свойства и ловушки.
Коэффициент вариации: формула, расчёт и как читать
Коэффициент вариации — стандартное отклонение в процентах от среднего. Формула, пример на пяти числах, расчёт в SQL, Python и Excel, порог 33% для НМЦК и ловушки.
Линейная регрессия простыми словами: уравнение, наклон и R²
Что такое регрессия и линейная регрессия: уравнение y = a + b·x, наклон, свободный член и R². Пример на пяти точках, расчёт в SQL, Python и Excel, остатки, прогноз и ловушки.