Линейная регрессия простыми словами: уравнение, наклон и R²
Что такое регрессия и линейная регрессия: уравнение y = a + b·x, наклон, свободный член и R². Пример на пяти точках, расчёт в SQL, Python и Excel, остатки, прогноз и ловушки.
Содержание статьи
Линейная регрессия — это прямая ŷ = a + b·x, проведённая через облако точек: наклон b показывает, на сколько в среднем меняется y, когда x растёт на единицу. Пример: менеджер продукта смотрит на график за три месяца — DAU вырос с 32 до 530–590 человек, дневная выручка — с нуля до 600 с лишним долларов. «Если дорастим до тысячи активных, сколько будем зарабатывать в день?» Линейная регрессия отвечает одним запросом: 1 118 долларов. Ниже — откуда берётся это число, как читать уравнение и почему именно этот ответ руководителю нести нельзя.
Что такое регрессия простыми словами
Регрессия описывает, как в среднем меняется одна величина, когда меняется другая. Линейная регрессия делает это прямой: через облако точек проводят линию, которая лежит к ним ближе всего, и записывают её уравнением.
В уравнении y — зависимая величина, то, что объясняют: выручка, число заказов. x — независимая, или фактор: аудитория, бюджет, номер дня. Наклон b показывает, на сколько в среднем меняется y, когда x растёт на единицу; его же называют коэффициентом регрессии. Свободный член a — значение линии при x = 0.
Главные слова здесь — «в среднем». Линия не обещает, что каждая точка ляжет на неё: отдельные дни будут выше и ниже. Регрессионным анализом называют всю работу вокруг уравнения: подобрать линию, проверить, насколько она подходит, и посмотреть, где она ошибается. Вариант с одним x называют парной линейной регрессией.
ŷ = a + b·xŷ — значение на линии, a — свободный член, b — наклон. Наблюдение отличается от линии на остаток: y = a + b·x + e.
Как найти уравнение регрессии: пример на пяти точках
Пять недель рекламной кампании. Бюджет по неделям — 10, 20, 30, 40 и 50 тысяч рублей, регистраций — 30, 50, 40, 70 и 60. Средний бюджет равен 30, среднее число регистраций — 50.
Для наклона у каждой недели считают отклонение бюджета и отклонение регистраций от своих средних, перемножают их и складывают: получается 800. Эту сумму делят на сумму квадратов отклонений бюджета — 1 000. Наклон равен 0,8. Линия всегда проходит через точку средних, отсюда свободный член: 50 − 0,8 · 30 = 26.
Уравнение: регистрации = 26 + 0,8 · бюджет. Неделя, в которую потратили на тысячу рублей больше, в среднем приносила на 0,8 регистрации больше. Для бюджета в 35 тысяч линия даёт 26 + 0,8 · 35 = 54 регистрации.
Этот способ называется методом наименьших квадратов: из всех возможных прямых выбирают ту, у которой сумма квадратов вертикальных промахов минимальна. У нашей линии она равна 360. Сдвиньте или поверните прямую — сумма вырастет.
b = Σ(x − x̄)(y − ȳ) / Σ(x − x̄)²; a = ȳ − b·x̄x̄ и ȳ — средние. В примере b = 800 / 1 000 = 0,8 и a = 50 − 0,8 · 30 = 26.
| Бюджет x | Регистрации y | (x − x̄)·(y − ȳ) | (x − x̄)² | Линия 26 + 0,8x | Остаток |
|---|---|---|---|---|---|
| 10 | 30 | 400 | 400 | 34 | −4 |
| 20 | 50 | 0 | 100 | 42 | 8 |
| 30 | 40 | 0 | 0 | 50 | −10 |
| 40 | 70 | 200 | 100 | 58 | 12 |
| 50 | 60 | 200 | 400 | 66 | −6 |
| среднее 30 | среднее 50 | сумма 800 | сумма 1 000 | сумма 0 |
import numpy as np

budget = np.array([10, 20, 30, 40, 50])   # тысяч рублей
signups = np.array([30, 50, 40, 70, 60])

b, a = np.polyfit(budget, signups, 1)     # степень 1 — прямая
r = np.corrcoef(budget, signups)[0, 1]
sse = ((signups - (a + b * budget)) ** 2).sum()

print(round(b, 2), round(a, 2))           # 0.8 26.0
print(round(r, 2), round(r ** 2, 2))      # 0.8 0.64
print(round(sse, 1))                      # 360.0
Как посчитать линейную регрессию в SQL
Теперь рабочие данные. В учебной базе сервиса лежат события пользователей и оплаты в долларах. Соберём таблицу, где одна строка — один день: DAU, то есть число людей хотя бы с одним событием за день, и выручка — сумма оплат. Берём 90 дней с 1 июня по 29 августа 2026 года. 30 августа выгрузка обрывается в 13:00, и неполный день в расчёт не идёт.
В семи днях оплат не было. Это ноль выручки, а не пропуск, поэтому оплаты присоединяются через LEFT JOIN и COALESCE: иначе дни без денег выпадут из расчёта, и линия получится другой.
В PostgreSQL и DuckDB прямую считают агрегатные функции regr_slope, regr_intercept и regr_r2. Рядом полезны regr_count — сколько пар попало в расчёт — и corr. Порядок аргументов у всех один: сначала зависимая величина y, потом x. Функции, кроме regr_count, возвращают число с плавающей точкой, а round с двумя аргументами в PostgreSQL принимает только numeric, отсюда CAST. На одной-единственной точке наклон не определён: PostgreSQL вернёт NULL, DuckDB — NaN.
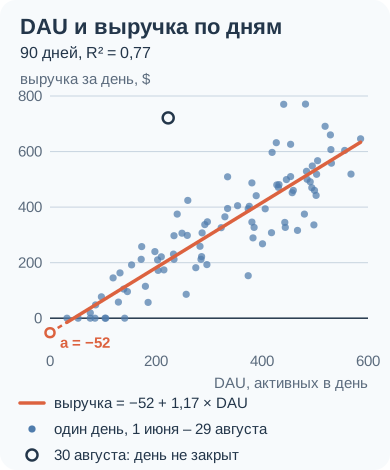
Результат: 90 дней, наклон 1,171, свободный член −52,12, R² = 0,773, коэффициент корреляции 0,879. Уравнение: выручка = −52,12 + 1,171 · DAU.
WITH daily AS (
  SELECT d.day, d.dau, COALESCE(r.revenue, 0) AS revenue
  FROM (SELECT CAST(event_time AS date) AS day, count(DISTINCT user_id) AS dau
        FROM events GROUP BY 1) AS d
  LEFT JOIN (SELECT paid_at AS day, sum(amount) AS revenue
             FROM payments GROUP BY 1) AS r ON r.day = d.day
)
SELECT
  regr_count(revenue, dau) AS days,
  round(CAST(regr_slope(revenue, dau) AS numeric), 3) AS slope,
  round(CAST(regr_intercept(revenue, dau) AS numeric), 2) AS intercept,
  round(CAST(regr_r2(revenue, dau) AS numeric), 3) AS r2,
  round(CAST(corr(revenue, dau) AS numeric), 3) AS r
FROM daily
WHERE day < DATE '2026-08-30';
Как читать наклон, свободный член и R²
Наклон читают в единицах: на сколько единиц y приходится одна единица x. Здесь — день, в котором активных пользователей на одного больше, приносил в среднем на 1,17 доллара больше; сто дополнительных активных — около 117 долларов. Это сравнение разных дней между собой, а не обещание «приведём человека — получим 1,17».
Свободный член −52,12 формально означает выручку при нулевом DAU. Отрицательной выручки не бывает, а дней с DAU меньше 32 в данных нет. Свободный член ставит линию на нужную высоту, и толковать его можно, только если x = 0 лежит внутри наблюдений и имеет смысл.
R², коэффициент детерминации, — доля разброса y, которую описывает линия. 0,773 значит, что 77% различий в дневной выручке линия связывает с различиями в DAU, а 23% остаются необъяснёнными. При одном x это квадрат коэффициента корреляции: 0,879² ≈ 0,773.
Функция linregress из SciPy добавляет стандартную ошибку и p-value. Стандартная ошибка наклона 0,068 показывает, насколько наклон гулял бы от выборки к выборке; 95%-й интервал — от 1,04 до 1,30. P-value 4,4·10⁻³⁰ — вероятность увидеть наклон не ближе к нулю, чем этот, если на самом деле связи нет. Оба числа отвечают только на вопрос, случаен ли наклон. Откуда он взялся, они не говорят: DAU и выручка росли весь квартал, а любые два растущих ряда дадут крошечный p-value. К этому вернёмся в разделе о причинности.
R² = 1 − Σ(y − ŷ)² / Σ(y − ȳ)²; при одном x: R² = r²В числителе — разброс вокруг линии, в знаменателе — разброс вокруг среднего. В примере с рекламой Σ(y − ȳ)² = 400 + 0 + 100 + 400 + 100 = 1 000, поэтому R² = 1 − 360 / 1 000 = 0,64 = 0,8². Разброс регистраций случайно совпал с разбросом бюджета, оттого наклон 0,8 равен r; в общем случае b = r · s_y / s_x.
import numpy as np
from scipy import stats

dau = np.array([
    32, 53, 76, 85, 104, 86, 76, 97, 105, 129, 141, 139, 132, 119, 146,
    154, 172, 180, 204, 185, 173, 198, 210, 233, 234, 249, 215, 203, 234, 240,
    285, 287, 297, 275, 257, 260, 283, 296, 292, 330, 286, 259, 323, 335, 374,
    418, 401, 354, 335, 383, 376, 389, 432, 385, 381, 381, 374, 427, 431, 454,
    480, 428, 406, 443, 419, 485, 499, 446, 457, 441, 444, 454, 494, 503, 498,
    491, 459, 505, 467, 531, 502, 519, 482, 495, 484, 529, 568, 556, 586, 530,
])
revenue = np.array([
    0, 0, 0, 0, 0, 48, 19, 77, 0, 58, 0, 105, 163, 145, 96,
    192, 212, 115, 172, 57, 258, 240, 221, 231, 212, 306, 174, 210, 297, 375,
    212, 307, 347, 182, 86, 424, 259, 193, 337, 365, 222, 298, 326, 395, 153,
    308, 268, 405, 509, 289, 403, 441, 481, 327, 346, 487, 394, 632, 471, 626,
    375, 480, 394, 345, 597, 500, 460, 499, 452, 770, 327, 510, 470, 518, 336,
    491, 460, 567, 316, 558, 442, 691, 771, 548, 529, 660, 519, 604, 646, 607,
])

fit = stats.linregress(dau, revenue)            # сначала x, потом y
residuals = revenue - (fit.intercept + fit.slope * dau)
n = len(dau)
half_width = stats.t.ppf(0.975, n - 2) * fit.stderr

print(round(fit.slope, 3), round(fit.intercept, 2))            # 1.171 -52.12
print(round(fit.rvalue, 4), round(fit.rvalue ** 2, 4))         # 0.8793 0.7731
print(round(fit.stderr, 3), f'{fit.pvalue:.1e}')               # 0.068 4.4e-30
print(round(fit.slope - half_width, 2), round(fit.slope + half_width, 2))  # 1.04 1.3
print(round(np.sqrt((residuals ** 2).sum() / (n - 2)), 1)) # 94.3Что такое остатки и что по ним видно
Остаток — разница между фактом и линией: e = y − ŷ. В примере с рекламой остатки равны −4, 8, −10, 12 и −6. Их сумма всегда ноль: линия устроена так, что промахи вверх и вниз уравновешены.
На учебной базе самый большой промах пришёлся на 9 августа: выручка 770 долларов при 464 по линии, остаток +306. 22 августа — +259, 15 июля — минус 233: при DAU 374 пришло всего 153 доллара. Стандартное отклонение остатков — 94 доллара, это типичный промах линии.
Полезнее смотреть не на отдельные остатки, а на их рисунок вдоль оси x. Если прямая подходит, узора нет: в любой части диапазона средний остаток около нуля. В таблице так и есть — от −19 до +11 при разбросе в десятки долларов. Знаки «минус, плюс, плюс, минус» похожи на дугу, но каждое среднее меньше двух своих стандартных ошибок (−19,1 при ошибке 12), и квадратичная добавка к линии незначима.
Зато разброс остатков растёт: 47 долларов при DAU до 150 и 100–120 при DAU от 300. В верхней части диапазона промах прогноза вдвое с лишним больше, чем в нижней, и одно число «±94» этого не показывает. Тревожные рисунки выглядят иначе: дуга из минусов, плюсов и снова минусов говорит, что связь не прямая, а одинокая далёкая точка — что линию тянет выброс.
| DAU | Дней | Средний остаток | Разброс остатков |
|---|---|---|---|
| до 150 | 15 | −19,1 | 46,9 |
| 150–299 | 26 | 10,8 | 79,5 |
| 300–449 | 25 | 7,1 | 120,2 |
| 450 и больше | 24 | −7,2 | 101,2 |
WITH daily AS (
  SELECT d.day, d.dau, COALESCE(r.revenue, 0) AS revenue
  FROM (SELECT CAST(event_time AS date) AS day, count(DISTINCT user_id) AS dau
        FROM events GROUP BY 1) AS d
  LEFT JOIN (SELECT paid_at AS day, sum(amount) AS revenue
             FROM payments GROUP BY 1) AS r ON r.day = d.day
),
model AS (
  SELECT regr_slope(revenue, dau) AS b, regr_intercept(revenue, dau) AS a
  FROM daily
  WHERE day < DATE '2026-08-30'
),
residuals AS (
  SELECT
    CASE WHEN dau < 150 THEN '1. до 150'
         WHEN dau < 300 THEN '2. 150–299'
         WHEN dau < 450 THEN '3. 300–449'
         ELSE '4. 450 и больше' END AS dau_band,
    revenue - (a + b * dau) AS residual
  FROM daily CROSS JOIN model
  WHERE day < DATE '2026-08-30'
)
SELECT
  dau_band,
  count(*) AS days,
  round(CAST(avg(residual) AS numeric), 1) AS mean_residual,
  round(CAST(stddev_samp(residual) AS numeric), 1) AS sd_residual
FROM residuals
GROUP BY dau_band
ORDER BY dau_band;
Можно ли прогнозировать по уравнению регрессии
Прогноз — это подстановка x в уравнение. Для DAU 400 получается −52,12 + 1,171 · 400 = 416 долларов в день. Это интерполяция: 400 лежит внутри наблюдавшегося диапазона 32–586, вокруг десятки реальных дней. С поправкой на разброс остатков ответ звучит так: «около 416; три дня из четырёх укладываются в плюс-минус сотню, почти все — в плюс-минус 190».
Для DAU 1 000 та же формула даёт около 1 118 долларов (по округлённым коэффициентам выйдет 1 119). Это экстраполяция: выше 586 нет ни одного наблюдения. Линия проведена по тому, что было, и ничего не знает о том, сохранится ли форма связи за краем данных. В обратную сторону это видно сразу: при DAU 0 она обещает −52 доллара.
Проверить экстраполяцию можно на прошлом. Построим линию только по июню, когда DAU не поднимался выше 249. Она выглядит не хуже общей: наклон 1,529, R² = 0,735. Подставим в неё августовские дни со средним DAU 486,9: прогноз — 642,6 доллара в день, факт — 519,6. Линия, которой в июне не в чем было упрекнуть, завысила август на 24%.
Отсюда правило для отчёта. Внутри диапазона прогноз показывают вместе с разбросом. За его пределами — только как сценарий «если связь останется прежней», с оговоркой, что данных там нет.
WITH daily AS (
  SELECT d.day, d.dau, COALESCE(r.revenue, 0) AS revenue
  FROM (SELECT CAST(event_time AS date) AS day, count(DISTINCT user_id) AS dau
        FROM events GROUP BY 1) AS d
  LEFT JOIN (SELECT paid_at AS day, sum(amount) AS revenue
             FROM payments GROUP BY 1) AS r ON r.day = d.day
),
june AS (
  SELECT regr_slope(revenue, dau) AS b, regr_intercept(revenue, dau) AS a,
    regr_r2(revenue, dau) AS r2, max(dau) AS max_dau
  FROM daily
  WHERE day < DATE '2026-07-01'
)
SELECT
  round(CAST(b AS numeric), 3) AS june_slope,
  round(CAST(r2 AS numeric), 3) AS june_r2,
  max_dau AS june_max_dau,
  round(avg(dau), 1) AS august_dau,
  round(CAST(avg(a + b * dau) AS numeric), 1) AS august_forecast,
  round(avg(revenue), 1) AS august_fact
FROM daily CROSS JOIN june
WHERE day >= DATE '2026-08-01' AND day < DATE '2026-08-30'
GROUP BY b, a, r2, max_dau;
Как один выброс и перепутанные оси меняют линию
Вернём в расчёт 30 августа. DAU за этот день — 223, потому что события есть только до 13:00, а выручка — 721 доллар: оплаты за день записаны целиком. С этой точкой наклон падает с 1,171 до 1,143, а R² — с 0,773 до 0,711. Одна строка из 91 забрала шесть процентных пунктов объяснённого разброса.
На коротком окне эффект сильнее. По 29 закрытым дням августа наклон равен 0,942 — и держится он слабо: R² = 0,12, 95%-й интервал от −0,06 до 1,94. Добавьте 30 августа — и наклон становится −0,002. Точка стоит далеко от остальных по оси x, 223 против 406–586, и работает как рычаг. Перед расчётом проверяйте, закрыт ли последний день, и смотрите на диаграмму рассеяния.
Вторая ловушка — порядок величин. Корреляция симметрична, регрессия — нет. Наклон выручки по DAU равен 1,171. Наклон DAU по выручке — 0,660, а не 1 / 1,171 = 0,854. Произведение двух наклонов равно R²: 1,171 · 0,660 = 0,773.
Причина в том, что метод наименьших квадратов уменьшает промахи только по вертикали. Поменяли оси — поменяли то, что считается промахом. В SQL эта ошибка выглядит как regr_slope(dau, revenue) вместо regr_slope(revenue, dau): запрос выполнится и вернёт правдоподобное число.
WITH daily AS (
  SELECT d.day, d.dau, COALESCE(r.revenue, 0) AS revenue
  FROM (SELECT CAST(event_time AS date) AS day, count(DISTINCT user_id) AS dau
        FROM events GROUP BY 1) AS d
  LEFT JOIN (SELECT paid_at AS day, sum(amount) AS revenue
             FROM payments GROUP BY 1) AS r ON r.day = d.day
)
SELECT
  round(CAST(regr_slope(revenue, dau) FILTER (WHERE day < DATE '2026-08-30') AS numeric), 3) AS slope_90,
  round(CAST(regr_slope(revenue, dau) AS numeric), 3) AS slope_91,
  round(CAST(regr_r2(revenue, dau) FILTER (WHERE day < DATE '2026-08-30') AS numeric), 3) AS r2_90,
  round(CAST(regr_r2(revenue, dau) AS numeric), 3) AS r2_91,
  round(CAST(regr_slope(revenue, dau) FILTER (
    WHERE day >= DATE '2026-08-01' AND day < DATE '2026-08-30') AS numeric), 3) AS august_29,
  round(CAST(regr_slope(revenue, dau) FILTER (
    WHERE day >= DATE '2026-08-01') AS numeric), 3) AS august_30
FROM daily;WITH daily AS (
SELECT d.day, d.dau, COALESCE(r.revenue, 0) AS revenue
FROM (SELECT CAST(event_time AS date) AS day, count(DISTINCT user_id) AS dau
FROM events GROUP BY 1) AS d
LEFT JOIN (SELECT paid_at AS day, sum(amount) AS revenue
FROM payments GROUP BY 1) AS r ON r.day = d.day
)
SELECT
round(CAST(regr_slope(revenue, dau) AS numeric), 3) AS revenue_on_dau,
round(CAST(regr_slope(dau, revenue) AS numeric), 3) AS dau_on_revenue,
round(CAST(1 / regr_slope(revenue, dau) AS numeric), 3) AS one_over_b,
round(CAST(regr_slope(revenue, dau) * regr_slope(dau, revenue) AS numeric), 3) AS product
FROM daily
WHERE day < DATE '2026-08-30';Что делать, если связь нелинейная или сегменты разные
Прямую можно провести через любые точки, и высокий R² не доказывает, что прямая — верная форма. Возьмём тренд: DAU по номеру дня. Наклон 5,55 — плюс пять с половиной активных пользователей в день, R² = 0,962. Выглядит как почти идеальная модель.
Остатки говорят другое. В первые десять дней линия завышает DAU в среднем на 22 человека, в середине квартала занижает на 18–19, в последние десять дней снова завышает на 25. Это дуга: рост замедляется, в июне DAU прибавлял по 6,7 в день, в августе — по 4,2. Прямая усредняет оба темпа, и прогноз на сентябрь по ней окажется выше, чем подсказывает август.
Вторая причина не верить одной линии — смешанные сегменты. Посчитаем ту же пару отдельно по каналам привлечения, где строка — день и канал. Платный поиск включили 1 июля, поэтому сравниваем на общем окне, 60 дней июля и августа: рефералы — 1,19, органика — 1,00, платный поиск — 0,75, партнёры — 0,54. Интервалы широкие и перекрываются (органика — от 0,33 до 1,67, платный поиск — от 0,45 до 1,05, партнёры — от −0,30 до 1,38), так что утверждать, что каналы различаются, по этим данным нельзя. Переносить общий наклон 1,17 на отдельный канал тоже нельзя: у каждого он свой и известен неточно.
Что с этим делать. При дуге — строить линию на коротком участке, где связь близка к прямой, или менять форму модели. При разных сегментах — считать линии отдельно, на одном окне, и показывать их рядом вместе с интервалами.
Выше нуля — факт больше линии, ниже — меньше. Остатки хорошей линии колебались бы вокруг нуля без рисунка; здесь они выстроились дугой при R² = 0,962.
WITH daily AS (
  SELECT
    CAST(event_time AS date) - DATE '2026-06-01' + 1 AS day_no,
    count(DISTINCT user_id) AS dau
  FROM events
  WHERE event_time < TIMESTAMP '2026-08-30 00:00:00'
  GROUP BY 1
),
model AS (
  SELECT regr_slope(dau, day_no) AS b, regr_intercept(dau, day_no) AS a
  FROM daily
)
SELECT
  min(day_no) AS from_day,
  max(day_no) AS to_day,
  round(CAST(avg(dau - (a + b * day_no)) AS numeric), 1) AS mean_residual
FROM daily CROSS JOIN model
GROUP BY CAST(floor((day_no - 1) / 10.0) AS integer)
ORDER BY from_day;WITH dau AS (
SELECT CAST(e.event_time AS date) AS day, u.channel, count(DISTINCT e.user_id) AS dau
FROM events AS e
JOIN users AS u ON u.user_id = e.user_id
WHERE e.event_time < TIMESTAMP '2026-08-30 00:00:00'
GROUP BY 1, 2
),
revenue AS (
SELECT p.paid_at AS day, u.channel, sum(p.amount) AS revenue
FROM payments AS p
JOIN users AS u ON u.user_id = p.user_id
GROUP BY 1, 2
),
daily AS (
SELECT d.day, d.channel, d.dau, COALESCE(r.revenue, 0) AS revenue
FROM dau AS d
LEFT JOIN revenue AS r ON r.day = d.day AND r.channel = d.channel
)
SELECT
channel,
regr_count(revenue, dau) AS days,
round(CAST(regr_slope(revenue, dau) AS numeric), 2) AS slope,
round(CAST(regr_r2(revenue, dau) AS numeric), 2) AS r2
FROM daily
WHERE day >= DATE '2026-07-01'
GROUP BY channel
ORDER BY slope DESC;Доказывает ли регрессия причинность
Нет. Наклон 1,17 описывает, чем дни с большим DAU отличались от дней с маленьким. Он не говорит, что будет, если DAU поднять. В учебной базе оплата — первая покупка или продление — почти не связана с заходом в продукт в тот же день: из 1 222 оплат только 201 (16%) пришлась на день, когда плательщик что-то делал в сервисе, — столько же, сколько в случайный день. И аудитория, и выручка растут по одной причине — растёт база пользователей.
Проверить это можно, убрав общий тренд. Вычтем из DAU и из выручки их линии по номеру дня и построим регрессию по остаткам: так сравниваются дни, которые различаются по DAU при одном и том же положении в календаре. Наклон падает с 1,17 до 0,36, и его 95%-й интервал, от −0,31 до 1,02, включает ноль. Один номер дня без DAU объясняет выручку не хуже: R² = 0,785 против 0,773.
Приросты день к дню говорят то же, но слабее. По 89 парам наклон равен 0,198, r = 0,041, R² = 0,002, p-value 0,70. Приросты выручки шумят так сильно, что интервал наклона — от −0,83 до 1,23: в одиночку этот тест ничего не решает. Вместе оба расчёта сходятся: своей связи DAU с выручкой, помимо общего роста, данные не показывают.
Поэтому фраза «каждый активный пользователь приносит 1,17 доллара в день» — неверное чтение уравнения. Причину показывает эксперимент или хотя бы сравнение, в котором третья величина не может двигать обе стороны сразу. Подробно — в разборе корреляции и причинности.
WITH daily AS (
  SELECT d.day - DATE '2026-06-01' + 1 AS day_no, d.dau, COALESCE(r.revenue, 0) AS revenue
  FROM (SELECT CAST(event_time AS date) AS day, count(DISTINCT user_id) AS dau
        FROM events GROUP BY 1) AS d
  LEFT JOIN (SELECT paid_at AS day, sum(amount) AS revenue
             FROM payments GROUP BY 1) AS r ON r.day = d.day
  WHERE d.day < DATE '2026-08-30'
),
trend AS (
  SELECT
    regr_slope(revenue, day_no) AS rev_b, regr_intercept(revenue, day_no) AS rev_a,
    regr_slope(dau, day_no) AS dau_b, regr_intercept(dau, day_no) AS dau_a,
    regr_r2(revenue, day_no) AS r2_day_only
  FROM daily
),
detrended AS (
  SELECT
    revenue - (rev_a + rev_b * day_no) AS revenue_res,
    dau - (dau_a + dau_b * day_no) AS dau_res,
    r2_day_only
  FROM daily CROSS JOIN trend
)
SELECT
  round(CAST(regr_slope(revenue_res, dau_res) AS numeric), 3) AS slope_without_trend,
  round(CAST(r2_day_only AS numeric), 3) AS r2_day_only
FROM detrended
GROUP BY r2_day_only;WITH daily AS (
SELECT d.day, d.dau, COALESCE(r.revenue, 0) AS revenue
FROM (SELECT CAST(event_time AS date) AS day, count(DISTINCT user_id) AS dau
FROM events GROUP BY 1) AS d
LEFT JOIN (SELECT paid_at AS day, sum(amount) AS revenue
FROM payments GROUP BY 1) AS r ON r.day = d.day
),
steps AS (
SELECT
dau - lag(dau) OVER (ORDER BY day) AS dau_change,
revenue - lag(revenue) OVER (ORDER BY day) AS revenue_change
FROM daily
WHERE day < DATE '2026-08-30'
)
SELECT
regr_count(revenue_change, dau_change) AS pairs,
round(CAST(regr_slope(revenue_change, dau_change) AS numeric), 3) AS slope,
round(CAST(corr(revenue_change, dau_change) AS numeric), 3) AS r,
round(CAST(regr_r2(revenue_change, dau_change) AS numeric), 3) AS r2
FROM steps;Что ещё называют регрессией: к среднему, множественная, логистическая
Регрессия к среднему — это не модель, а явление: после необычно высокого или низкого значения следующее чаще оказывается ближе к среднему. Рекордный по выручке день редко повторяется назавтра, и дело не в том, что команда что-то сломала. Название пришло от Фрэнсиса Гальтона. В статье 1886 года «Regression towards Mediocrity in Hereditary Stature» он описал рост родителей и детей: у очень высоких родителей дети в среднем ниже их, у очень низких — выше. От этой работы слово «регрессия» перешло к уравнениям, которыми такую связь описывают.
Множественная регрессия — то же уравнение с несколькими x: выручку объясняют сразу DAU, каналом и днём недели. Каждый коэффициент читается как «при прочих равных». Она нужна, когда факторы действуют одновременно и разделить их вклад одной линией нельзя — например, когда на выручку сразу влияют DAU и день недели.
Логистическая регрессия нужна, когда y — это «да» или «нет»: оплатил, ушёл, кликнул. Она предсказывает вероятность от 0 до 1. Прямая для такой задачи не годится: при больших и малых x она выдаёт «вероятности» ниже нуля и выше единицы.
Частые вопросы
Чем регрессия отличается от линейной регрессии? Регрессия — общее название уравнений, которые показывают, как в среднем меняется одна величина при изменении другой. Линейная — случай, когда связь описывают прямой y = a + b·x.
Чем регрессия отличается от корреляции? Корреляция — одно число от −1 до 1 о том, насколько тесно точки лежат вокруг прямой; она не меняется, если поменять величины местами. Регрессия даёт саму прямую в единицах измерения, и для неё важно, что считать y. В нашем примере r = 0,879 в обе стороны, а наклоны — 1,171 и 0,660.
Что показывает коэффициент регрессии? На сколько единиц в среднем меняется y, когда x увеличивается на одну единицу. Знак показывает направление, а величина зависит от единиц: в долларах на пользователя и в центах на пользователя это разные числа при одной и той же линии.
Какой R² считается хорошим? Общего порога нет: он зависит от того, насколько шумна сама величина и какая точность нужна для решения. К тому же R² не говорит, верна ли форма: тренд DAU с R² = 0,962 систематически ошибается на краях, а линия выручки с 0,773 — нет. Сначала смотрите на остатки, потом на R².
Как построить регрессию в Excel? Наклон считает функция НАКЛОН(известные_значения_y; известные_значения_x), свободный член — ОТРЕЗОК с теми же аргументами, R² — КВПИРСОН. Проверьте себя на пяти точках из примера: должны получиться 0,8, 26 и 0,64. На точечной диаграмме ту же прямую рисует линия тренда: вкладка «Конструктор диаграмм» (в старых версиях — «Конструктор»), «Добавить элемент диаграммы», «Линия тренда», «Линейная». Уравнение и R² появятся, если в параметрах линии отметить «показывать уравнение на диаграмме» и «поместить на диаграмму величину достоверности аппроксимации (R^2)».
Что читать дальше
Регрессия продолжает разговор о корреляции: та отвечает, есть ли линейная связь, а уравнение — какая она и в каких единицах. Запросы из статьи можно выполнить в песочнице симулятора SQL-аналитика: там та же учебная база.
Материалы по теме
Метод наименьших квадратов (МНК): суть, формулы и пример расчёта
Метод наименьших квадратов простыми словами: что минимизирует МНК, формулы наклона и свободного члена, нормальные уравнения, пример на пяти точках, SQL, Python и Excel.
Математическое ожидание: что это, формула и примеры
Математическое ожидание простыми словами: среднее, к которому результат сходится в долгую. Формула, пример на кубике, расчёт в SQL и Python, свойства и ловушки.
Коэффициент вариации: формула, расчёт и как читать
Коэффициент вариации — стандартное отклонение в процентах от среднего. Формула, пример на пяти числах, расчёт в SQL, Python и Excel, порог 33% для НМЦК и ловушки.