Математическое ожидание: что это, формула и примеры
Математическое ожидание простыми словами: среднее, к которому результат сходится в долгую. Формула, пример на кубике, расчёт в SQL и Python, свойства и ловушки.
Содержание статьи
Менеджер спрашивает: «Сколько денег приносит одна регистрация с первой оплаты?» В базе 4 613 регистраций, три тарифа и 80% людей, которые не заплатили ничего. Ответ — одно число, 4,84 доллара: это оценка математического ожидания первой оплаты. Ниже — что это число означает, как его находят по формуле и в SQL, какими свойствами пользуются в расчётах и в каких случаях одного ожидания для решения мало.
Коротко
- Математическое ожидание — среднее значение случайной величины «в долгую»: число, к которому приближается среднее арифметическое, когда опыт повторяют много раз.
- Для дискретной величины каждое возможное значение умножают на его вероятность и складывают: E[X] = Σ xᵢ · pᵢ.
- В учебной базе ожидаемая первая оплата с одной регистрации — 4,84 доллара: 19 · 0,1114 + 29 · 0,0642 + 39 · 0,0221. Обычное среднее по таблице даёт то же число.
- Ожидание суммы всегда равно сумме ожиданий. Для произведения это верно, если величины независимы; у связанных величин E[XY] и E[X]·E[Y] обычно расходятся.
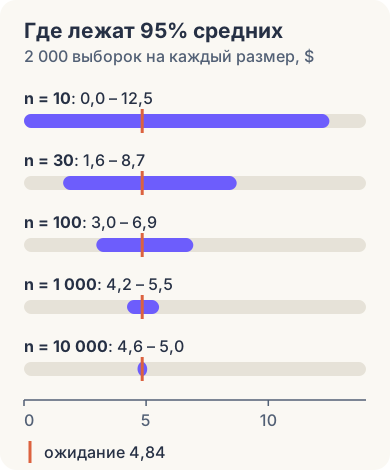
- Ожидание не описывает типичный случай при скошенных данных и ничего не говорит о разбросе: на десяти пользователях среднее гуляет от 0 до 12,5 доллара.
Что такое математическое ожидание простыми словами
Математическое ожидание случайной величины — это её среднее значение, взвешенное по вероятностям. Проще: число, к которому сойдётся среднее арифметическое, если повторять один и тот же опыт очень много раз. Обозначают его E[X], от английского expectation, или M(X) — так чаще пишут в русскоязычных учебниках. В разговоре это «матожидание» или «мат. ожидание».
Чтобы найти математическое ожидание дискретной величины, перечислите все её возможные значения, умножьте каждое на его вероятность и сложите результаты.
Пример — игральный кубик. Значений шесть, от 1 до 6, у каждого вероятность 1/6. E[X] = (1 + 2 + 3 + 4 + 5 + 6) / 6 = 3,5. За один бросок 3,5 не выпадет никогда. Но если бросить кубик десять тысяч раз и разделить сумму очков на десять тысяч, получится число рядом с 3,5: в симуляции вышло 3,5055.
Считать так начали в задачах об игре в кости: сколько стоит шанс на выигрыш. Трактат Христиана Гюйгенса «О расчётах при игре в кости» (1657) Большая советская энциклопедия называет одним из первых исследований в области теории вероятностей.
E[X] = x₁·p₁ + x₂·p₂ + … + xₙ·pₙ = Σ xᵢ·pᵢxᵢ — возможные значения, pᵢ — их вероятности, сумма всех pᵢ равна 1. Кубик: (1 + 2 + 3 + 4 + 5 + 6) · 1/6 = 3,5.
Как найти математическое ожидание на данных: выручка с одной регистрации
Перенесём формулу на рабочую задачу. В учебной базе симулятора SQL-аналитика — сервис «Маяк» с тремя тарифами: basic за 19 долларов в месяц, pro за 29 и team за 39. В таблице users 4 613 зарегистрированных, по строке на человека. В payments лежат оплаты, первая оплата пользователя помечена payment_type = 'first'.
Случайная величина X — сумма первой оплаты одного зарегистрированного пользователя. Возможных значений четыре: 0, если человек не оплатил, 19, 29 и 39. Вероятности возьмём как доли: сколько человек из 4 613 оказалось в каждой группе.
Запрос возвращает четыре строки. Не заплатили 3 701 человек, вероятность 0,8023. Тариф basic выбрали 514 человек, pro — 296, team — 102. Последний столбец — вклад в ожидание, «сумма × вероятность», посчитанный по неокруглённой доле. Сумма вкладов: 2,1171 + 1,8608 + 0,8623 = 4,8402. Одна регистрация в среднем приносит 4,84 доллара первой оплаты.
Посмотрите на вклады. Самый большой, 2,12 из 4,84, даёт самый дешёвый тариф: он берёт частотой. Дорогой team приносит меньше всех, потому что его выбирают двое из ста. В ожидании цена без вероятности ничего не значит.
| Тариф | Сумма xᵢ, $ | Пользователей | Вероятность pᵢ | Вклад xᵢ·pᵢ |
|---|---|---|---|---|
| без оплаты | 0 | 3 701 | 0,8023 | 0 |
| basic | 19 | 514 | 0,1114 | 2,1171 |
| pro | 29 | 296 | 0,0642 | 1,8608 |
| team | 39 | 102 | 0,0221 | 0,8623 |
| Итого | 4 613 | 1 | 4,8402 |
Ожидание 4,84 доллара лежит между столбцами 0 и 19 — там, где нет ни одного возможного значения.
WITH per_user AS (
  SELECT
    u.user_id,
    COALESCE(p.plan, 'без оплаты') AS plan,
    COALESCE(p.amount, 0) AS first_amount
  FROM users u
  LEFT JOIN payments p
    ON p.user_id = u.user_id AND p.payment_type = 'first'
)
SELECT
  plan,
  first_amount,
  COUNT(*) AS users,
  ROUND(1.0 * COUNT(*) / SUM(COUNT(*)) OVER (), 4) AS probability,
  ROUND(first_amount * COUNT(*) / SUM(COUNT(*)) OVER (), 4) AS contribution
FROM per_user
GROUP BY plan, first_amount
ORDER BY first_amount;
Почему обычное среднее по таблице даёт то же число
Формулу Σ xᵢ·pᵢ не обязательно разворачивать руками. Когда вероятности — это доли в тех же данных, взвешенная сумма совпадает с обычным средним. Сложить 4 613 сумм и разделить на 4 613 — то же самое, что сгруппировать одинаковые суммы и умножить каждую на её долю.
Запрос ниже считает оба варианта рядом: в обоих столбцах 4,8402. Главное условие — одна строка на пользователя и нули у тех, кто не платил. Если усреднить только первые оплаты из payments, получится средняя первая оплата среди оплативших, 24,48 доллара. Это другая величина: в ней нет 3 701 нуля.
В Python то же самое: np.sum(values * probabilities) и mean() по развёрнутому массиву из 4 613 чисел печатают 4.8402 и 4.8402.
Две записи нужны для разных задач. Среднее удобно, когда данные уже лежат в таблице. Запись через вероятности нужна, когда данных ещё нет: вы меняете вероятность или сумму в формуле и смотрите, что станет с ожиданием. Так устроен расчёт скидки ниже.
WITH per_user AS (
  SELECT u.user_id, COALESCE(p.amount, 0) AS first_amount
  FROM users u
  LEFT JOIN payments p
    ON p.user_id = u.user_id AND p.payment_type = 'first'
),
distribution AS (
  SELECT
    first_amount,
    1.0 * COUNT(*) / (SELECT COUNT(*) FROM per_user) AS probability
  FROM per_user
  GROUP BY first_amount
)
SELECT
  ROUND(SUM(first_amount * probability), 4) AS sum_value_x_probability,
  (SELECT ROUND(AVG(first_amount), 4) FROM per_user) AS plain_average
FROM distribution;import numpy as np
values = np.array([0, 19, 29, 39]) # сумма первой оплаты, $
users = np.array([3701, 514, 296, 102]) # сколько пользователей с такой суммой
probabilities = users / users.sum()
expected = np.sum(values * probabilities) # сумма «значение × вероятность»
per_user = np.repeat(values, users) # 4 613 чисел, по одному на пользователя
print(round(expected, 4), round(per_user.mean(), 4))Чем математическое ожидание отличается от среднего арифметического
Среднее арифметическое считают по данным, которые уже есть: сложили и разделили. Математическое ожидание — свойство самого распределения: каким было бы среднее по бесконечному числу повторов. Первое — оценка второго.
Ожидание кубика — ровно 3,5. Оно следует из устройства кубика и не зависит от того, бросали его или нет. Среднее по десяти броскам каждый раз новое: в той же симуляции первые десять бросков дали 3,0, следующие десять — 4,1.
Число 4,84 из учебной базы — тоже среднее по выборке: по 4 613 людям, которые зарегистрировались за три месяца. Как оценка ожидания для следующего такого же пользователя оно неточно. Стандартная ошибка — 0,15 доллара, 95%-й доверительный интервал — от 4,55 до 5,14. Интервал учитывает только случайность выборки. Систематический сдвиг он не видит: ниже показано, что из-за недавних регистраций само число 4,84 занижено.
То, что среднее с ростом выборки приближается к ожиданию, — содержание закона больших чисел. Он же объясняет, почему на маленькой выборке это приближение грубое. Как из стандартной ошибки получается интервал, разобрано в статье про доверительный интервал.
| Математическое ожидание | Среднее арифметическое | |
|---|---|---|
| Что это | параметр распределения | статистика, посчитанная по выборке |
| Из чего считают | из значений и их вероятностей | из наблюдений |
| Меняется от выборки к выборке | нет | да |
| Обозначение | E[X], M(X), μ | x̄ |
| Кубик | 3,5 | 3,0 и 4,1 в двух сериях по десять бросков |
Какие свойства математического ожидания нужны в работе
Первое свойство — линейность. Ожидание суммы равно сумме ожиданий: E[X + Y] = E[X] + E[Y]. Оно выполняется для любых величин, у которых ожидание существует, даже когда они зависят друг от друга.
Выручка с пользователя складывается из первой оплаты и продлений. Ожидание первой оплаты — 4,8402, продлений — 1,8016. Продления полностью зависят от первой оплаты: без неё их не бывает. И всё равно сумма ожиданий, 6,6419 (слагаемые показаны с округлением), совпадает со средним полной выручки на пользователя. Первый запрос считает обе стороны равенства.
Второе: константы выносятся, E[aX + b] = a·E[X] + b. Допустим, платёжный провайдер забирает 5% с оплаты, а на каждую регистрацию уходит 1 доллар на приветственную рассылку — числа условные. Ожидаемый остаток — 0,95 · 4,8402 − 1 = 3,5982. Пересчитывать каждую строку не нужно, хотя построчный расчёт в том же запросе даёт те же 3,5982.
Чего у ожидания нет: E[XY] в общем случае не равно E[X]·E[Y]. Выручка с пользователя — это цена его тарифа, умноженная на число его оплат. Среди всех зарегистрированных средняя цена — 4,8402 (у не оплативших она 0), среднее число оплат — 0,2712. Их произведение — 1,31. Настоящая выручка на пользователя — 6,64, в пять раз больше.
Причина — зависимость: у 80% людей цена и число оплат равны нулю одновременно. Среди 912 платящих линейная связь почти исчезает, и произведение средних, 33,58, почти совпадает со средним произведения, 33,60. Так устроены учебные данные: в реальном продукте дорогие тарифы могут продлевать чаще или реже дешёвых. Разница E[XY] − E[X]·E[Y] называется ковариацией, на ней построена корреляция.
E[X + Y] = E[X] + E[Y]; E[aX + b] = a·E[X] + b; E[XY] = E[X]·E[Y], если X и Y независимыПервые два равенства верны для любых величин с конечным ожиданием. Третье гарантировано только при независимости: точное условие — нулевая ковариация, а она бывает и у зависимых величин.
WITH per_user AS (
  SELECT
    u.user_id,
    COALESCE(SUM(CASE WHEN p.payment_type = 'first' THEN p.amount END), 0) AS first_amount,
    COALESCE(SUM(CASE WHEN p.payment_type = 'renewal' THEN p.amount END), 0) AS renewal_amount
  FROM users u
  LEFT JOIN payments p ON p.user_id = u.user_id
  GROUP BY u.user_id
)
SELECT
  ROUND(AVG(first_amount), 4) AS e_first,
  ROUND(AVG(renewal_amount), 4) AS e_renewal,
  ROUND(AVG(first_amount) + AVG(renewal_amount), 4) AS sum_of_expectations,
  ROUND(AVG(first_amount + renewal_amount), 4) AS expectation_of_sum,
  ROUND(0.95 * AVG(first_amount) - 1, 4) AS a_e_plus_b,
  ROUND(AVG(0.95 * first_amount - 1), 4) AS e_of_ax_plus_b
FROM per_user;WITH per_user AS (
SELECT
u.user_id,
COALESCE(MAX(p.amount), 0) AS price,
COUNT(p.payment_id) AS payments
FROM users u
LEFT JOIN payments p ON p.user_id = u.user_id
GROUP BY u.user_id
)
SELECT
'все зарегистрированные' AS base,
COUNT(*) AS users,
ROUND(AVG(price), 4) AS e_price,
ROUND(AVG(payments), 4) AS e_payments,
ROUND(AVG(price) * AVG(payments), 4) AS product_of_expectations,
ROUND(AVG(price * payments), 4) AS expectation_of_product
FROM per_user
UNION ALL
SELECT
'только платившие',
COUNT(*),
ROUND(AVG(price), 4),
ROUND(AVG(payments), 4),
ROUND(AVG(price) * AVG(payments), 4),
ROUND(AVG(price * payments), 4)
FROM per_user
WHERE payments > 0
ORDER BY users DESC;Как выбрать вариант по ожидаемой выручке: пример со скидкой
Маркетинг предлагает скидку 20% на первую оплату и ждёт роста конверсии. Сумма оплаты упадёт точно, вырастет ли конверсия и насколько — неизвестно. Сравнивать нужно ожидаемую выручку на одну регистрацию в обоих вариантах.
Сейчас вероятность оплаты — 912 / 4 613 = 0,1977, средняя первая оплата среди оплативших — 24,48 доллара, ожидание — 0,1977 · 24,48 = 4,84. Со скидкой средняя оплата станет 24,4825 · 0,8 = 19,59.
В расчёте два допущения. Первое: со скидкой тарифы выбирают в тех же пропорциях. Второе — вероятность оплаты: в базе её нет, скидку никто не запускал, и мы задаём её сами. Поэтому полезнее считать порог: при какой конверсии скидка выходит в ноль. 4,84 / 19,59 = 0,2471. Скидка окупается, только если доля оплативших окажется выше 24,71% — вырастет больше чем в 1,25 раза, на 4,9 процентного пункта.
Если конверсия поднимется до 23%, ожидание упадёт до 4,50 доллара, на 6,9%. Если до 26% — вырастет до 5,09, на 5,2%. Решение сводится к вопросу, верите ли вы в рост конверсии больше чем на четверть. На него отвечает A/B-тест, а не формула.
Расчёт учитывает только первую оплату. По линейности продления добавляются отдельным слагаемым, но вероятность продления у пришедших по скидке — ещё одно допущение, и его тоже нужно назвать вслух.
| Вариант | Вероятность оплаты | Средняя оплата, $ | Ожидание, $ |
|---|---|---|---|
| Без скидки (факт) | 0,1977 | 24,48 | 4,84 |
| Скидка, порог окупаемости (при том же выборе тарифов) | 0,2471 | 19,59 | 4,84 |
| Скидка, конверсия 23% (допущение) | 0,2300 | 19,59 | 4,50 |
| Скидка, конверсия 26% (допущение) | 0,2600 | 19,59 | 5,09 |
import numpy as np

values = np.array([19, 29, 39])       # цены тарифов, $
payers = np.array([514, 296, 102])    # первые оплаты по тарифам
signups = 4613

p_pay = payers.sum() / signups
avg_paid = np.sum(values * payers) / payers.sum()
base = p_pay * avg_paid
print(f'сейчас: p = {p_pay:.4f}, оплата {avg_paid:.2f}, ожидание {base:.4f}')

avg_discounted = avg_paid * 0.8       # скидка 20%, тот же набор тарифов
breakeven = base / avg_discounted
print(f'со скидкой: оплата {avg_discounted:.2f}, порог p = {breakeven:.4f}')

for p_new in (0.23, 0.26):            # допущения, в данных их нет
    expected = p_new * avg_discounted
    print(f'p = {p_new:.2f}: ожидание {expected:.4f} ({expected / base - 1:+.1%})')

def sigma(p, amounts):                # разброс первой оплаты на регистрацию
    probs = p * payers / payers.sum()
    mean = np.sum(amounts * probs)
    return np.sqrt(np.sum(amounts**2 * probs) - mean**2)

print(f'sigma: {sigma(p_pay, values):.2f} без скидки, {sigma(breakeven, values * 0.8):.2f} на пороге')
Почему «средний пользователь» не похож на типичного
Ожидание 4,84 не совпадает ни с одним возможным значением: заплатить можно 0, 19, 29 или 39. Это нормально — ожидание описывает сумму по многим пользователям, а не одного человека. Но фраза «пользователь в среднем платит 4,84» сбивает с толку: такого пользователя не существует.
Со всей выручкой, включая продления, картина та же. Среднее на зарегистрированного — 6,64 доллара, медиана — 0: 80,2% людей принесли меньше среднего, потому что не принесли ничего. Среди платящих среднее — 33,60, медиана — 29, и 60,6% заплатили меньше среднего. Хвост из тех, кто продлил подписку один-два раза (290 человек из 912), тянет среднее вверх.
Для бюджета и прогноза выручки нужно именно ожидание: его умножают на число пользователей. Для описания обычного клиента берите медиану и доли. Разница между ними разобрана в статье про среднее, медиану и моду.
| База | Пользователей | Среднее, $ | Медиана, $ | Ниже среднего |
|---|---|---|---|---|
| Все зарегистрированные | 4 613 | 6,64 | 0 | 80,2% |
| Только платившие | 912 | 33,60 | 29 | 60,6% |
WITH per_user AS (
  SELECT u.user_id, COALESCE(SUM(p.amount), 0) AS revenue
  FROM users u
  LEFT JOIN payments p ON p.user_id = u.user_id
  GROUP BY u.user_id
),
bases AS (
  SELECT 'все зарегистрированные' AS base, revenue FROM per_user
  UNION ALL
  SELECT 'только платившие', revenue FROM per_user WHERE revenue > 0
),
with_mean AS (
  SELECT base, revenue, AVG(revenue) OVER (PARTITION BY base) AS mean_revenue
  FROM bases
)
SELECT
  base,
  COUNT(*) AS users,
  ROUND(AVG(revenue), 2) AS mean_revenue,
  PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY revenue) AS median_revenue,
  ROUND(100.0 * COUNT(CASE WHEN revenue < mean_revenue THEN 1 END) / COUNT(*), 1) AS pct_below_mean
FROM with_mean
GROUP BY base
ORDER BY users DESC;
Что ожидание не говорит о разбросе и малых выборках
Два варианта с одинаковым ожиданием могут вести себя по-разному. Вернёмся к скидке на пороге окупаемости: ожидание в обоих вариантах 4,84. Но стандартное отклонение первой оплаты без скидки — 10,22 доллара, со скидкой — 8,88: платят чаще и меньшими суммами. Ожидание этой разницы не видит. Её описывают дисперсия и стандартное отклонение.
От разброса зависит, сколько наблюдений нужно, чтобы среднее подошло к ожиданию. Здесь он велик: стандартное отклонение вдвое больше самого ожидания, коэффициент вариации — 2,11. Проверим симуляцией: берём случайных пользователей из того же распределения и считаем среднее. По 2 000 выборок на каждый размер, зерно генератора зафиксировано.
На десяти пользователях нижняя граница упирается в ноль: 233 выборки из 2 000 дали ровно ноль, никто из десяти не заплатил. Верхняя граница — 12,5 доллара, выше оказались около 2% выборок. На тридцати 95% средних лежат от 1,6 до 8,7. Даже на тысяче диапазон шириной больше доллара: от 4,2 до 5,5. Только на десяти тысячах он сужается до 4,6–5,0.
Практический вывод: выручку на регистрацию по сегменту из тридцати человек или по первой сотне регистраций теста нельзя сравнивать с 4,84 напрямую. Сначала посмотрите, какой диапазон даёт случайность при таком размере.
import numpy as np

values = np.array([0, 19, 29, 39])                  # сумма первой оплаты, $
probabilities = np.array([3701, 514, 296, 102]) / 4613
rng = np.random.default_rng(2026)

for n in (10, 30, 100, 1000, 10000):
    samples = rng.choice(values, size=(2000, n), p=probabilities)
    means = samples.mean(axis=1)                    # 2 000 средних по n пользователей
    low, high = np.percentile(means, [2.5, 97.5])
    zero_samples = int((means == 0).sum())
    print(f'n = {n}: 95% средних от {low:.1f} до {high:.1f}, нулевых выборок {zero_samples}')
Почему вероятность в формуле — тоже оценка: незрелые регистрации
Вероятность 0,1977 — доля оплативших среди всех 4 613 зарегистрированных. Но выгрузка закрыта 30 августа, а от регистрации до первой оплаты в этой базе проходит от 3 до 20 дней, медиана — 11. Те, кто пришёл в последние недели, ещё не успели заплатить.
Разделим регистрации по 10 августа: у тех, кто пришёл с этой даты, двадцатый день приходится на 30 августа, а этот день в выгрузке неполный: события обрываются в 12:59. До неё: 3 207 человек, оплатили 23,57%, ожидание первой оплаты — 5,75 доллара. После: 1 406 человек, 11,10% и 2,76 доллара. Общие 4,84 — смесь зрелых и незрелых когорт. Зрелые тоже неоднородны: в июле включили платный поиск, который конвертирует в два-три раза хуже остальных каналов, и ожидание упало с 6,64 доллара у июньских регистраций до 5,47 у июльских. Если взвесить зрелые ожидания каналов по составу регистраций с 10 августа, получится 5,42: общее число занижает прогноз для нового пользователя примерно на 11%.
Относительный порог скидки от этого не меняется: конверсия должна вырасти в 1,25 раза при любой базе. Абсолютные числа из таблицы меняются: при зрелой конверсии 23,57% порог равен 29,47%, а не 24,71%. Прогноз выручки в деньгах по незрелым данным тоже будет ошибочным.
Правило: вероятность в формуле ожидания измеряют на тех, у кого событие уже могло случиться. То же касается продлений, оттока и LTV (выручки за всё время жизни клиента) — их считают по когортам одного возраста.
SELECT
  CASE
    WHEN u.signup_date < DATE '2026-08-10' THEN 'до 10 августа'
    ELSE 'с 10 августа'
  END AS signup_period,
  COUNT(*) AS users,
  COUNT(p.user_id) AS payers,
  ROUND(100.0 * COUNT(p.user_id) / COUNT(*), 2) AS pay_pct,
  ROUND(SUM(COALESCE(p.amount, 0)) / COUNT(*), 4) AS expected_first_amount
FROM users u
LEFT JOIN payments p
  ON p.user_id = u.user_id AND p.payment_type = 'first'
GROUP BY 1
ORDER BY MIN(u.signup_date);
Как считают математическое ожидание непрерывной величины
У непрерывной величины — времени до оплаты, длительности сессии — вероятность каждого отдельного значения равна нулю, поэтому сумму заменяет интеграл, а вероятности — плотность f(x). Смысл прежний: значения взвешиваются по тому, насколько они вероятны. Руками интеграл берут редко. Либо у распределения есть готовая формула: у нормального ожидание равно параметру μ, у экспоненциального — 1/λ. Либо ожидание оценивают средним по данным. Ожидание есть не у всякого распределения: при очень тяжёлом хвосте интеграл расходится, и среднее по выборке не успокаивается, сколько данных ни добавляй.
E[X] = ∫ x · f(x) dxf(x) — плотность распределения; интеграл берут по всем возможным значениям X.
Частые вопросы
«Как найти математическое ожидание?» Умножить каждое значение на его вероятность и сложить: для кубика это (1 + 2 + 3 + 4 + 5 + 6) / 6 = 3,5. На данных — AVG по таблице, где на каждый объект одна строка, включая нулевые.
«Чем математическое ожидание отличается от среднего значения?» Ожидание — параметр распределения, оно одно. Среднее считают по выборке, и от выборки к выборке оно меняется. Чем больше наблюдений, тем меньше типичное расстояние между средним и ожиданием.
«Может ли математическое ожидание быть отрицательным?» Да, если среди значений есть отрицательные. Лотерея: 100 билетов по 50 ₽, один приз 2 000 ₽ и десять по 100 ₽. Ожидаемый выигрыш на билет — 2 000 · 0,01 + 100 · 0,10 = 30 ₽, с учётом цены билета — 30 − 50 = −20 ₽.
«Чему равно математическое ожидание числа успехов?» Если попыток n, а вероятность успеха в каждой p, ожидание равно n · p — это следует из линейности. Подробности — в статье про биномиальное распределение.
«Что такое математическое ожидание в трейдинге и ставках?» Средний результат одной сделки или ставки на длинной дистанции: вероятность выигрыша, умноженная на его размер, минус вероятность проигрыша, умноженная на размер потери. Ставка на красное в европейской рулетке: 18 красных ячеек из 37, ожидание — 18/37 − 19/37 = −2,7% от ставки. В трейдинге вероятности неизвестны, их оценивают по истории сделок, и к такой оценке относится всё сказанное выше: мало наблюдений, скошенные результаты, меняющиеся условия. Положительное ожидание не обещает прибыли на короткой серии. Это объяснение термина, а не совет, как играть или торговать.
Все запросы из статьи можно выполнить в песочнице симулятора SQL-аналитика: там та же база «Маяк».
Материалы по теме
Закон больших чисел простыми словами: формулировка и примеры
Закон больших чисел: почему среднее и доля стабилизируются с ростом выборки. Пример с монетой, накопленная конверсия A/B-теста в SQL, слабая и сильная форма, ошибка игрока и когда закон работает медленно.
Биномиальное распределение: формула, пример и где оно в аналитике
Биномиальное распределение простыми словами: формула Бернулли, пример расчёта вручную, математическое ожидание и дисперсия, конверсия как биномиальная величина, биномиальный тест в Python и типичные ошибки.
Коэффициент вариации: формула, расчёт и как читать
Коэффициент вариации — стандартное отклонение в процентах от среднего. Формула, пример на пяти числах, расчёт в SQL, Python и Excel, порог 33% для НМЦК и ловушки.