Формула Байеса, условная и полная вероятность на примерах
Формула (теорема) Байеса простыми словами: условная вероятность, формула полной вероятности, априорная и апостериорная вероятность. Расчёт в SQL и Python, ошибка базовой частоты.
Содержание статьи
В отчёте по оплатам за квартал стоит строка: 45% оплативших пришли из органики. Менеджер читает её как «органика конвертирует лучше всех». Органика превращает в оплату 23% регистраций, а реферальный канал — 27%, хотя дал только 30% оплативших. Обе цифры верны, просто это разные условные вероятности: «канал при условии оплаты» и «оплата при условии канала». Формула Байеса связывает одну с другой: P(A|B) = P(B|A) × P(A) / P(B). Дальше — условная и полная вероятность, расчёт на учебной базе симулятора SQL-аналитика в SQL и Python и ловушки, которые переворачивают вывод.
Что такое формула Байеса простыми словами
Формула Байеса (её же называют теоремой Байеса) пересчитывает вероятность причины, когда вы увидели следствие. Вы знаете, как часто причина A приводит к следствию B, — это P(B|A). Спрашивают же об обратном: следствие B случилось, с какой вероятностью за ним стоит A, — это P(A|B). Чтобы перевернуть условие, нужны ещё две величины: как часто встречается сама причина, P(A), и как часто встречается следствие, P(B).
Пример, который можно пересчитать в уме. Из 100 новых пользователей 20 пришли по рекламе, 80 — сами. Оплачивают 10% рекламных, то есть 2 человека, и 25% остальных — 20 человек. Всего оплативших 22. Пользователь оплатил — с какой вероятностью он рекламный? По формуле: 0,10 × 0,20 / 0,22 = 0,0909. Прямым подсчётом то же самое: 2 из 22, около 9%.
Реклама привела каждого пятого пользователя, но среди оплативших рекламный лишь каждый одиннадцатый. Наблюдение «оплатил» сдвинуло вероятность с 20% до 9%. Этот сдвиг и считает формула.
P(A|B) = P(B|A) × P(A) / P(B)P(A|B) — вероятность A, если B произошло; P(B|A) — вероятность B, если произошло A; P(A) и P(B) — вероятности событий без условий.
Что такое условная вероятность и как её найти
Условная вероятность P(A|B) — это вероятность события A среди тех случаев, где произошло B. Вертикальная черта читается «при условии». Считают её делением: число случаев, где произошли оба события, на число случаев с B. Вся разница между условными вероятностями — в знаменателе, то есть в том, какую группу вы взяли за сто процентов.
Посчитаем на учебной базе. В ней 4 613 пользователей сервиса «Маяк», зарегистрированных с 1 июня по 29 августа 2026 года. Событие workspace_created — создание рабочего пространства, таблица payments — оплаты. Пусть A — «оплатил хотя бы раз», B — «создал рабочее пространство». Запрос размечает каждого пользователя двумя флагами и считает обе условные вероятности.
Оба события произошли у 599 человек. Делим на 2 750 создавших пространство — получаем P(оплатил | создал) = 21,78%. Делим на 912 оплативших — получаем P(создал | оплатил) = 65,68%. Числитель один, знаменатели разные, ответы различаются втрое. P(A|B) и P(B|A) совпадают, только когда P(A) = P(B) или когда события вместе не происходят вовсе — тогда обе равны нулю.
В pandas те же числа дают деление клетки таблицы 2×2 на сумму строки или на сумму столбца. Перепутать table.loc[1] с table[1] — значит незаметно поменять условие.
P(A|B) = P(A и B) / P(B)P(A и B) — вероятность, что произошли оба события. Формула имеет смысл, только если P(B) > 0.
| Оплатил | Не оплатил | Всего | |
|---|---|---|---|
| Создал пространство | 599 | 2 151 | 2 750 |
| Не создал | 313 | 1 550 | 1 863 |
| Всего | 912 | 3 701 | 4 613 |
WITH flags AS (
  SELECT
    u.user_id,
    CASE WHEN EXISTS (
      SELECT 1 FROM events e
      WHERE e.user_id = u.user_id AND e.event_name = 'workspace_created'
    ) THEN 1 ELSE 0 END AS has_workspace,
    CASE WHEN EXISTS (
      SELECT 1 FROM payments p WHERE p.user_id = u.user_id
    ) THEN 1 ELSE 0 END AS paid
  FROM users u
)
SELECT
  COUNT(*) AS users,                         -- 4613
  SUM(has_workspace) AS with_workspace,      -- 2750
  SUM(paid) AS payers,                       -- 912
  SUM(has_workspace * paid) AS both_events,  -- 599
  ROUND(100.0 * SUM(has_workspace * paid) / SUM(has_workspace), 2) AS p_paid_given_workspace,  -- 21.78
  ROUND(100.0 * SUM(has_workspace * paid) / SUM(paid), 2) AS p_workspace_given_paid            -- 65.68
FROM flags;import pandas as pd
# клетки таблицы 2×2 из результата SQL: оба события, только пространство, только оплата, ничего
cells = pd.DataFrame({
'workspace': [1, 1, 0, 0],
'paid': [1, 0, 1, 0],
'users': [599, 2151, 313, 1550],
})
table = cells.pivot(index='workspace', columns='paid', values='users')
p_paid_given_workspace = table.loc[1, 1] / table.loc[1].sum() # делим на строку
p_workspace_given_paid = table.loc[1, 1] / table[1].sum() # делим на столбец
print(round(p_paid_given_workspace * 100, 2)) # 21.78
print(round(p_workspace_given_paid * 100, 2)) # 65.68Что такое формула полной вероятности
В знаменателе формулы Байеса стоит P(B) — вероятность следствия без условий. Часто её нет в готовом виде, зато есть разбивка по сегментам. Формула полной вероятности собирает P(B) из частей: для каждого сегмента умножаем его долю на вероятность B внутри него и складываем. Требование одно: сегменты не пересекаются и вместе покрывают всех.
В учебной базе четыре канала привлечения, у каждого пользователя ровно один. Вероятность оплаты — это сумма «доля канала × конверсия канала». Для органики: 37,87% × 23,47% = 8,89 процентного пункта. Складываем вклады: 8,89 + 6,03 + 1,86 + 2,99 = 19,77%. Это общая конверсия: 912 оплативших из 4 613.
Отсюда рабочее следствие: общая конверсия — взвешенное среднее конверсий сегментов. Она может упасть, даже когда ни один канал не стал конвертировать хуже: достаточно, чтобы выросла доля слабого. Поэтому при падении общей метрики сначала проверяют, не изменились ли веса.
P(B) = P(B|A₁) × P(A₁) + … + P(B|Aₙ) × P(Aₙ)A₁…Aₙ — непересекающиеся сегменты, которые вместе покрывают все случаи.
| Канал | Пользователей | Доля канала | Конверсия в оплату | Вклад, п. п. |
|---|---|---|---|---|
| organic | 1 747 | 37,87% | 23,47% | 8,89 |
| referral | 1 037 | 22,48% | 26,81% | 6,03 |
| paid_search | 1 015 | 22,00% | 8,47% | 1,86 |
| partner | 814 | 17,65% | 16,95% | 2,99 |
| Всего | 4 613 | 100% | 19,77% | 19,77 |
WITH payers AS (
  SELECT DISTINCT user_id FROM payments
),
by_channel AS (
  SELECT u.channel, COUNT(*) AS users, COUNT(p.user_id) AS paid
  FROM users u
  LEFT JOIN payers p ON p.user_id = u.user_id
  GROUP BY u.channel
)
SELECT
  channel,
  users,
  paid,
  ROUND(100.0 * users / SUM(users) OVER (), 2) AS share_pct,        -- P(канал)
  ROUND(100.0 * paid / users, 2) AS conversion_pct,                 -- P(оплата | канал)
  ROUND(100.0 * paid / SUM(users) OVER (), 2) AS contribution_pct   -- их произведение
FROM by_channel
ORDER BY users DESC;
Как посчитать формулу Байеса на данных
Теперь перевернём условие. Пользователь оплатил — с какой вероятностью он пришёл из платного поиска? По формуле Байеса: P(paid_search | оплата) = P(оплата | paid_search) × P(paid_search) / P(оплата) = 8,47% × 22,00% / 19,77% = 9,43%. Прямой подсчёт даёт то же: 86 оплативших из платного поиска на 912 оплативших всего.
Запрос считает оба варианта для каждого канала, и столбцы совпадают до сотых. Так и должно быть: формула Байеса — не приближение, а тождество, которое следует из определения условной вероятности. Когда есть строки по каждому пользователю, проще считать напрямую. Формула нужна, когда строк нет, а есть только доли и конверсии из чужого отчёта.
Столбец lift делит долю канала среди оплативших на его долю среди всех. У реферального канала он 1,36: доля реферальных среди оплативших в 1,36 раза выше, чем среди всех пользователей. У платного поиска — 0,43. Тот же лифт получится, если поделить конверсию канала на общую, поэтому по нему сразу видно, кто конвертирует лучше среднего.
Учебная база симулятора SQL-аналитика: 4 613 пользователей, 912 оплативших. Первая серия — вероятность канала до наблюдения, вторая — после наблюдения «оплатил».
WITH payers AS (
  SELECT DISTINCT user_id FROM payments
),
by_channel AS (
  SELECT u.channel, COUNT(*) AS users, COUNT(p.user_id) AS paid
  FROM users u
  LEFT JOIN payers p ON p.user_id = u.user_id
  GROUP BY u.channel
),
parts AS (
  SELECT
    channel,
    1.0 * users / SUM(users) OVER () AS p_channel,                -- P(канал)
    1.0 * paid / users AS p_paid_given_channel,                   -- P(оплата | канал)
    1.0 * SUM(paid) OVER () / SUM(users) OVER () AS p_paid,       -- P(оплата)
    1.0 * paid / SUM(paid) OVER () AS direct_share                -- прямой подсчёт
  FROM by_channel
)
SELECT
  channel,
  ROUND(100 * p_paid_given_channel * p_channel / p_paid, 2) AS bayes_pct,
  ROUND(100 * direct_share, 2) AS direct_pct,
  ROUND(direct_share / p_channel, 2) AS lift
FROM parts
ORDER BY bayes_pct DESC;
-- organic 44.96 / 44.96 / 1.19, referral 30.48 / 30.48 / 1.36,
-- partner 15.13 / 15.13 / 0.86, paid_search 9.43 / 9.43 / 0.43
Почему при редком событии положительный результат теста чаще ложная тревога
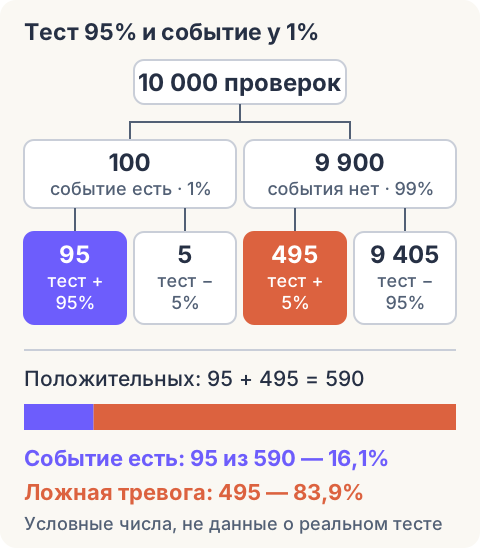
Классический пример — проверка на редкое событие. Числа условные, это не данные о каком-либо реальном тесте. Событие есть у 1% проверяемых. Тест находит его в 95% случаев, когда оно есть (чувствительность), и даёт отрицательный ответ в 95% случаев, когда его нет (специфичность). Результат положительный. С какой вероятностью событие действительно есть?
Интуиция отвечает «95%». Посчитаем частотами на 10 000 проверок. Событие есть у 100, тест отметит 95 из них. У 9 900 события нет, но 5% из них, 495, тоже получат положительный результат. Всего положительных 590, верных среди них 95 — это 16,1%. Примерно пять срабатываний из шести ложные.
Подмену 16% на 95% называют ошибкой базовой частоты: человек помнит точность теста и забывает, насколько редко само событие. В формуле Байеса эта редкость стоит отдельным множителем P(A), и пропустить её нельзя.
Рабочая версия той же задачи — антифрод-правило или алерт на аномалию, который «срабатывает правильно в 99% случаев». Пусть из 100 000 операций мошеннических 100, то есть 0,1%. Правило ловит 99 из них и ложно срабатывает на 1% честных — это 999 операций. В очереди на ручную проверку 1 098 алертов, мошеннических среди них 99, или 9,02%. При этом правило действительно право в 99% всех операций. «Насколько точно правило» и «какая доля алертов оправданна» — разные условные вероятности; обе разобраны в статье про чувствительность и специфичность.
| Мошенническая | Честная | Всего | |
|---|---|---|---|
| Правило сработало | 99 | 999 | 1 098 |
| Не сработало | 1 | 98 901 | 98 902 |
| Всего | 100 | 99 900 | 100 000 |
def posterior(prior, sensitivity, specificity):
    true_pos = sensitivity * prior
    false_pos = (1 - specificity) * (1 - prior)
    return true_pos / (true_pos + false_pos)

test = posterior(0.01, 0.95, 0.95)
print(round(test * 100, 2))                           # 16.1   тест, событие у 1%
print(round(posterior(0.001, 0.99, 0.99) * 100, 2))   # 9.02   антифрод-правило, событие у 0,1%
print(round(posterior(test, 0.95, 0.95) * 100, 2)) # 78.48 второй положительный, ошибки тестов независимыЧто такое априорная и апостериорная вероятность
Априорная вероятность — то, что вы знали о причине до наблюдения: P(A). Апостериорная — то, что знаете после: P(A|B). В примере с тестом априорная вероятность события — 1%, апостериорная после положительного результата — 16,1%. Множитель между ними, P(B|A) / P(B), показывает, насколько наблюдение характерно именно для этой причины.
Обновлять можно по шагам: апостериорная вероятность после первого наблюдения становится априорной для второго. Если тот же человек получил второй положительный результат другого теста с теми же характеристиками, а ошибки двух тестов между собой не связаны (ложное срабатывание первого не делает более вероятным ложное срабатывание второго), в формулу подставляют уже не 1%, а 16,1%. Получается 78,48%. Одно срабатывание оставляло событие маловероятным, два делают его вероятным.
Оговорка: второе наблюдение должно нести новую информацию. Повторный запуск того же правила на той же операции вернёт тот же ответ и ничего не добавит — учитывать его второй раз нельзя.
На учебной базе цепочка выглядит так. Доля платного поиска среди всех пользователей — 22,00%. Узнали, что пользователь оплатил, — 9,43%. Узнали, что он ещё и с десктопа, — 6,45%. На втором шаге все величины берутся уже среди оплативших: с десктопа 38,37% оплативших из платного поиска и 56,14% оплативших в целом, отсюда 9,43% × 38,37% / 56,14% = 6,45%. Прямой подсчёт подтверждает: 33 из 512.
Где формула Байеса нужна аналитику
Скоринг и антифрод. Модель выдаёт оценку, порог превращает её в срабатывание, а аналитика спрашивают, какая доля срабатываний оправданна. Ответ зависит от базовой частоты события в том потоке, где правило применяют. Перенесли правило с подозрительной выборки на общий поток — доля верных срабатываний упадёт, хотя само правило не менялось.
Оценка источника по результату. Оплата, отток или жалоба уже случились — откуда пришли эти пользователи? Это P(сегмент | результат), и рядом всегда должна стоять доля сегмента среди всех, иначе крупный сегмент покажется причиной просто из-за размера.
Байесовский A/B-тест. Вместо p-value считают распределение возможных значений конверсии в каждой группе: исходное представление обновляют данными эксперимента и получают утверждение вида «вариант B лучше A с такой-то вероятностью». Механика та же, что в примерах выше, только обновляется не одно число, а целое распределение. Как устроен сам эксперимент — в статье про A/B-тестирование.
Наивный байесовский классификатор применяет ту же формулу к нескольким признакам сразу и для простоты считает их независимыми внутри класса — отсюда слово «наивный».
Какие ошибки делают с условной вероятностью
Перепутанное условие. Среди оплативших 44,96% пришли из органики. Это не значит, что органика конвертирует на 45%: её конверсия 23,47%. И не значит, что органика — лучший канал: реферальный дал меньше оплативших (30,48%), зато конвертирует лучше — 26,81% против 23,47%. Органика лидирует среди оплативших в основном из-за размера — это 37,87% всех регистраций. В судебной статистике ту же подмену называют ошибкой прокурора: вероятность улики при невиновности выдают за вероятность невиновности при такой улике.
Забытая базовая частота. «65,68% оплативших создали рабочее пространство» звучит как довод: пространство ведёт к оплате. Но его создали 59,61% всех пользователей, лифт всего 1,10. Конверсия создавших — 21,78%, не создавших — 16,80%: связь есть, но куда слабее, чем обещает число 65,68%. Любую долю «среди успешных» сравнивайте с долей того же признака среди всех.
Независимость, которой нет. Правило «вероятность того, что произойдут оба события, равна произведению их вероятностей» верно только для независимых событий. В общем случае P(A и B) = P(A) × P(B|A). Проверим на паре «пришёл из платного поиска» и «оплатил»: доли событий — 22,00% и 19,77%, их произведение — 4,35%. Столько пользователей попало бы в пересечение, будь события независимы. В базе их 1,86%, меньше половины от этого. Для пары «создал пространство» и «оплатил» расхождение мягче: 12,99% против 11,79%.
Сравнение доли пересечения с произведением долей — быстрая проверка на зависимость. Точно на выборке они не совпадут никогда, поэтому небольшое расхождение проверяют критерием хи-квадрат. Если расхождение больше шума, перемножать вероятности нельзя. Наивному байесовскому классификатору та же проверка нужна между признаками внутри класса: два зависимых признака он посчитает как два отдельных свидетельства.
| Как звучит | Что это | Значение |
|---|---|---|
| Оплатившие пришли из органики | P(organic | оплата) | 44,96% |
| Органика оплачивает | P(оплата | organic) | 23,47% |
| Оплатившие пришли из реферального | P(referral | оплата) | 30,48% |
| Реферальный оплачивает | P(оплата | referral) | 26,81% |
| Оплатившие создали пространство | P(пространство | оплата) | 65,68% |
| Создали пространство среди всех | P(пространство) | 59,61% |
WITH payers AS (
  SELECT DISTINCT user_id FROM payments
),
flags AS (
  SELECT
    CASE WHEN u.channel = 'paid_search' THEN 1 ELSE 0 END AS is_paid_search,
    CASE WHEN p.user_id IS NOT NULL THEN 1 ELSE 0 END AS paid
  FROM users u
  LEFT JOIN payers p ON p.user_id = u.user_id
)
SELECT
  ROUND(100.0 * SUM(is_paid_search) / COUNT(*), 2) AS p_a,                -- 22.00
  ROUND(100.0 * SUM(paid) / COUNT(*), 2) AS p_b,                          -- 19.77
  ROUND(100.0 * SUM(is_paid_search * paid) / COUNT(*), 2) AS p_a_and_b,   -- 1.86
  ROUND(100.0 * SUM(is_paid_search) * SUM(paid)
        / (COUNT(*) * COUNT(*)), 2) AS p_a_times_p_b                      -- 4.35
FROM flags;
Сколько пользователей стоит за условной вероятностью
Каждое условие сужает группу. В учебной базе конверсию канала считают по 814–1 747 пользователям, а там, где страна не заполнена, в сегменте остаётся от 8 до 22 человек. Запрос показывает пять самых маленьких сегментов «канал × страна».
У реферального канала без указанной страны конверсия 30%, у органики — 4,55%. Разница почти в семь раз, а стоит за ней 3 оплативших из 10 пользователей против 1 из 22. 95%-й интервал Уилсона для 3 из 10 — от 10,78% до 60,32% (в отличие от привычного «доля ± 1,96 стандартной ошибки», он не выходит за 0–100% и пригоден для малых групп): данные совместимы и с очень слабым, и с очень сильным сегментом. Для всего реферального канала, 278 из 1 037, интервал — 24,20–29,59%.
Рядом с условной вероятностью показывайте знаменатель. Число «30%» без «из 10» читают как свойство сегмента, хотя это сведения о десяти людях, из которых оплатили трое.
WITH payers AS (
  SELECT DISTINCT user_id FROM payments
)
SELECT
  u.channel,
  COALESCE(u.country, 'не указана') AS country,
  COUNT(*) AS users,
  COUNT(p.user_id) AS paid,
  ROUND(100.0 * COUNT(p.user_id) / COUNT(*), 2) AS conversion_pct
FROM users u
LEFT JOIN payers p ON p.user_id = u.user_id
GROUP BY u.channel, COALESCE(u.country, 'не указана')
ORDER BY users, u.channel
LIMIT 5;
-- partner, не указана: 8 / 2 / 25.00;  referral, не указана: 10 / 3 / 30.00
-- paid_search, не указана: 15 / 1 / 6.67;  organic, не указана: 22 / 1 / 4.55
-- partner, BY: 68 / 14 / 20.59from scipy.stats import binomtest
segments = [('referral, страна не указана', 3, 10), ('referral, весь канал', 278, 1037)]
for label, paid, users in segments:
ci = binomtest(paid, users).proportion_ci(confidence_level=0.95, method='wilson')
print(label, round(100 * paid / users, 2), round(100 * ci.low, 2), round(100 * ci.high, 2))
# referral, страна не указана 30.0 10.78 60.32
# referral, весь канал 26.81 24.2 29.59Как незрелые когорты искажают условную вероятность
P(оплата | paid_search) = 8,47% выглядит как свойство канала. Но в этой цифре спрятано ещё одно условие — возраст когорты. В учебной базе первая оплата приходит через 3–20 дней после регистрации, а последний полный день выгрузки — 29 августа. Все 20 дней на оплату были только у тех, кто зарегистрировался до 9 августа включительно. Среди более поздних оплатить успели не все: их конверсия 11,10% против 23,57% у остальных.
Платный поиск запущен 1 июля, позже остальных каналов, поэтому незрелых пользователей в нём больше: с 10 августа зарегистрировались 38,8% канала, у органики таких 28,0%. Сравнивать каналы надёжнее на одном окне — регистрации с 1 июля по 9 августа, когда работали все четыре канала и все когорты успели дозреть.
На этом окне платный поиск конвертирует 10,79%, органика — 25,51%, реферальный — 31,40%, партнёрский — 21,27%. Вывод о слабом канале устоял, но цифра другая: 10,79% вместо 8,47%. Меняется и перевёрнутая вероятность: на том же окне доля платного поиска среди оплативших — 67 из 474, или 14,14%, а не 9,43%, лифт 0,49 вместо 0,43. Формула Байеса пересчитывает то, что в неё положили; если P(B|A) посчитана по незрелым данным, ошибка перейдёт в ответ. Числа выше в статье посчитаны по всей базе и для платного поиска занижены.
WITH payers AS (
  SELECT DISTINCT user_id FROM payments
)
SELECT
  u.channel,
  COUNT(*) AS users,
  COUNT(p.user_id) AS paid,
  ROUND(100.0 * COUNT(p.user_id) / COUNT(*), 2) AS conversion_pct
FROM users u
LEFT JOIN payers p ON p.user_id = u.user_id
WHERE u.signup_date >= DATE '2026-07-01'
  AND u.signup_date < DATE '2026-08-10'
GROUP BY u.channel
ORDER BY users DESC;
-- organic 780 / 199 / 25.51, paid_search 621 / 67 / 10.79,
-- referral 449 / 141 / 31.40, partner 315 / 67 / 21.27Частые вопросы
Формула Байеса простыми словами — это что? Способ перевернуть условие: зная, как часто причина даёт следствие и как часто встречаются причина и следствие по отдельности, найти вероятность причины при наблюдаемом следствии.
Когда применяется формула Байеса? Когда вероятность известна в одну сторону, а нужна в другую: есть точность правила — нужна доля верных срабатываний; есть конверсии сегментов — нужен состав оплативших. Если под рукой строки с обоими признаками, то же число получается прямым подсчётом.
Чем формула полной вероятности отличается от формулы Байеса? Формула полной вероятности идёт от причин к следствию и даёт P(B) как сумму по сегментам. Формула Байеса идёт обратно, от следствия к причине, и использует полную вероятность в знаменателе.
Формула и теорема Байеса — это одно и то же? Да: теоремой называют утверждение, формулой — его запись. В учебниках встречаются оба названия.
Что делать, если P(B) неизвестна? Собрать её по формуле полной вероятности: сложить вклады P(B|Aᵢ) × P(Aᵢ) по всем сегментам, которые вместе покрывают все случаи и не пересекаются.
Как найти условную вероятность? Поделить число случаев, где произошли и A, и B, на число случаев с B. В SQL это отношение двух счётчиков, в pandas — деление клетки таблицы 2×2 на сумму строки или столбца.
Кто такой Байес? Томас Байес — священник и математик XVIII века, член Лондонского королевского общества. Его работа «An Essay towards solving a Problem in the Doctrine of Chances» зачитана в обществе 23 декабря 1763 года и напечатана в 53-м томе журнала Philosophical Transactions, уже после смерти автора: Байес умер в 1761 году, рукопись нашёл в его бумагах и передал обществу Ричард Прайс — об этом сказано в письме Прайса, которым открывается публикация.
Что попробовать на учебной базе
Запросы из статьи выполняются в песочнице симулятора SQL-аналитика на той же базе. Замените рабочее пространство на invite_sent или export_completed и сравните P(оплата | событие) с P(событие | оплата). Затем разложите вероятность оплаты по устройствам вместо каналов и проверьте, что сумма вкладов снова даёт 19,77%.
Материалы по теме
Парадокс Монти Холла: решение, объяснение простыми словами и симуляция
Парадокс Монти Холла простыми словами: почему смена двери выигрывает в 2/3 игр. Перебор, формула Байеса, симуляция на Python и SQL и три правила ведущего с разными ответами.
Математическое ожидание: что это, формула и примеры
Математическое ожидание простыми словами: среднее, к которому результат сходится в долгую. Формула, пример на кубике, расчёт в SQL и Python, свойства и ловушки.
Закон больших чисел простыми словами: формулировка и примеры
Закон больших чисел: почему среднее и доля стабилизируются с ростом выборки. Пример с монетой, накопленная конверсия A/B-теста в SQL, слабая и сильная форма, ошибка игрока и когда закон работает медленно.