Ошибка выжившего: что это, примеры и как она искажает анализ
Ошибка выжившего простыми словами: вывод по тем, кто остался. История Вальда без легенд и четыре примера из аналитики продукта с SQL и Python: выручка, удержание, опрос, A/B-тест.
Содержание статьи
Ошибка выжившего — это вывод, сделанный только по тем, кто дошёл до момента наблюдения: выбывшие в данные не попали. В метрике она сидит в знаменателе. Пример — квартальный отчёт с тремя числами. Клиент с активной подпиской принёс в среднем 37,57 доллара. На восьмой неделе люди заходят в продукт почти так же часто, как на четвёртой. Опрос о продукте разослали тем, кто выгружал отчёты, а это в основном органика и рекомендации. Арифметика везде верная, но все три числа посчитаны по тем, кто остался: ушедшие в выборку не попали. Ниже — история с самолётами Абрахама Вальда, сверенная с источниками, и четыре места, где ошибка живёт в продуктовой аналитике. Каждое разобрано на учебной базе симулятора SQL-аналитика: запросы работают в PostgreSQL и DuckDB, рядом расчёт на Python.
Что такое ошибка выжившего простыми словами
Те, кто выбыл по дороге, в данные не попали, и их отсутствия никто не заметил — в этом вся ошибка. По-английски — survivorship bias, в русских текстах встречается ещё «систематическая ошибка выжившего».
Бытовой пример: старые дома кажутся крепче новых, «раньше строили на века». Но до нас дошли только те дома, что простояли сто лет. Те, что развалились или были снесены, в сравнении не участвуют.
Рабочий пример из учебной базы: средняя выручка на клиента с активной подпиской — 37,57 доллара, а на любого, кто хоть раз платил, — 33,60. Разница в 11,8% взялась не из продукта: фильтр «активные» убрал из расчёта 397 клиентов из 912.
по выжившим = сумма по оставшимся / число оставшихся; по когорте = сумма по всем вошедшим / число всех вошедшихПересчёт вручную. Пять клиентов: трое ушли, заплатив по 19, двое остались и заплатили по 57. По оставшимся — 57. По всем пятерым — (3 · 19 + 2 · 57) / 5 = 34,2.
- Ошибка сидит не в арифметике, а в знаменателе: в него попали только дошедшие.
- Признак в запросе — фильтр по текущему статусу, по факту действия или
JOINс таблицей событий. - Лекарство — считать от входа в когорту, то есть группу людей, начавших в один период, и оставлять выбывших в расчёте с их нулями.
- Смотреть только на выживших можно, когда вопрос задан про них самих, а не про всех пришедших.
Что на самом деле известно про самолёты и Абрахама Вальда
Популярная версия такая. Военные изучили пробоины на вернувшихся бомбардировщиках и собирались усилить броню там, где их больше. Вальд возразил: бронировать надо места без пробоин, потому что самолёты с попаданиями туда не вернулись. К рассказу прикладывают схему самолёта в красных точках.
Документально подтверждается меньше. Математик Абрахам Вальд работал в Statistical Research Group при Колумбийском университете и около 1943 года написал восемь меморандумов о том, как оценивать уязвимость частей самолёта по повреждениям вернувшихся машин. В 1980 году Center for Naval Analyses переиздал их под названием «A Method of Estimating Plane Vulnerability Based on Damage of Survivors». Подробный разбор метода — статья Марка Мангеля и Франсиско Саманиего «Abraham Wald's Work on Aircraft Survivability» в Journal of the American Statistical Association (1984, т. 79, № 386).
Саму идею коротко пересказал У. Аллен Уоллис, руководивший исследованиями группы, — в том же журнале в 1980 году, по памяти, через 37 лет. По его словам, военные были склонны защищать части, на которых у вернувшихся самолётов больше попаданий, а Вальд исходил из того, что попадания распределяются по самолёту равномерно, и у него были на то основания. Других свидетельств о позиции военных, кроме этих нескольких фраз, нет. Тогда попадания в уязвимые части должны реже встречаться у вернувшихся: такие самолёты чаще не возвращаются. Из этого он вывел способ оценить вероятность того, что попадание в конкретную часть сбивает самолёт.
Остальное — пересказ. Математик Билл Кассельман в колонке Американского математического общества «The Legend of Abraham Wald» (2016) сверил легенду с меморандумами. В них — вероятностный расчёт по числу вылетевших и вернувшихся самолётов и числу попаданий. Спора с офицерами, реплик Вальда и совета, куда ставить броню, там нет: группа отвечала на заданный вопрос и рекомендаций военным не давала. Схема с точками в англоязычной Википедии подписана как гипотетическая. Вывод Кассельмана осторожный: история может быть правдой, но свидетельств в пользу её самых эффектных деталей почти нет. Метод Вальда — факт, цитаты «от Вальда» — нет.
Насколько фильтр «активные» завышает выручку на клиента?
Менеджер спрашивает, сколько приносит один клиент. В таблице subscriptions одна строка на каждого, кто платил, и статус: active, past_due или churned. Первое, что хочется сделать, — оставить status = 'active': зачем считать тех, кто ушёл. Выгрузка заканчивается 30 августа 2026 года, от этой даты запрос считает дни.
По активным выходит 37,57, по всем платившим — 33,60. Если же вопрос был «сколько приносит одна регистрация», знаменатель — все 4 613 зарегистрированных, и ответ — 6,64. Три знаменателя дают три разных числа, и в план продаж нельзя подставлять первое. Третье тоже не готово для плана: в нём зарегистрированные неделю назад стоят рядом с теми, кто в продукте три месяца. К этому вернёмся в разделе о когортах.
Последний столбец показывает механизм. У активных с первой оплаты прошло в среднем 45 дней, у ушедших — 16. В учебной базе статус выводится из поведения: active получает тот, у кого набралось не меньше семи дней с заходом, а на это нужно время. Фильтр по статусу оказался скрытым фильтром по стажу: в active попали те, у кого было время и набрать семь дней с заходом, и дойти до продления. А churned здесь в основном новички: у 97 из 169 первая оплата была в последние две недели выгрузки.
| Статус | Клиентов | Выручка на клиента, $ | Дней с первой оплаты |
|---|---|---|---|
| все платившие | 912 | 33,60 | 35,2 |
| active | 515 | 37,57 | 45,3 |
| past_due | 228 | 29,51 | 26,3 |
| churned | 169 | 26,98 | 16,4 |
WITH paid AS (
  SELECT user_id, SUM(amount) AS revenue
  FROM payments
  GROUP BY user_id
)
SELECT
  COALESCE(s.status, 'все платившие') AS status,
  COUNT(*) AS clients,
  SUM(p.revenue) AS revenue,
  ROUND(AVG(p.revenue), 2) AS revenue_per_client,
  ROUND(AVG(DATE '2026-08-30' - s.started_at), 1) AS days_since_first_payment
FROM subscriptions s
JOIN paid p ON p.user_id = s.user_id
GROUP BY ROLLUP (s.status)
ORDER BY clients DESC;import pandas as pd
# строки из запроса выше: статус, клиентов, выручка за всё время
subs = pd.DataFrame({
'status': ['active', 'past_due', 'churned'],
'clients': [515, 228, 169],
'revenue': [19350, 6729, 4560],
})
registered = 4613 # строк в users
survivors = subs[subs.status == 'active']
per_active = survivors.revenue.sum() / survivors.clients.sum()
per_payer = subs.revenue.sum() / subs.clients.sum()
per_registered = subs.revenue.sum() / registered
dropped = subs.clients.sum() - survivors.clients.sum()
print(f'на активную подписку: {per_active:.2f}')
print(f'на любого платившего: {per_payer:.2f}')
print(f'на зарегистрированного: {per_registered:.2f}')
print(f'завышение к платившим: {per_active / per_payer - 1:+.1%}')
print(f'фильтр отбросил: {dropped} из {subs.clients.sum()} ({dropped / subs.clients.sum():.1%})')Почему активность «на активного» почти не падает к восьмой неделе?
Та же болезнь у метрики «активность на активного пользователя». Возьмём 1 042 человека, зарегистрировавшихся в июне, и для каждой недели жизни посчитаем дни с заходом в продукт двумя способами: на того, кто заходил на этой неделе, и на каждого человека из когорты.
На активного пользователя приходится 1,71 дня на второй неделе и 1,25 на восьмой — снижение примерно на четверть. На человека из когорты — 1,28 и 0,56: падение больше чем вдвое. С четвёртой недели по восьмую первая линия почти стоит: 1,39 против 1,25. Ниже единицы она опуститься не может: чтобы попасть в знаменатель, нужен хотя бы один день с заходом. До этого пола осталось 0,25 дня, оттого линия и выглядит устойчивой.
Обе линии посчитаны верно, но отвечают на разные вопросы: как ведут себя оставшиеся и что стало с теми, кого привлекли. За пологой первой линией не видно, что на восьмой неделе в продукт заходили 467 человек из 1 042. Остальные 575 в знаменатель этой недели не попали, и их нули в среднее не вошли. Это не значит, что они ушли навсегда: 263 из них заходили неделей раньше, 141 вернулся в следующие четыре дня. Метрика «на активного» каждую неделю собирает знаменатель заново — из тех, кто пришёл сам.
Отсюда типичный ложный вывод: «пользователи со стажем вовлечены не хуже новых, значит, с удержанием порядок». Удержание восьмой недели — доля когорты, заходившая на этой неделе, здесь 44,8%, и метрика «на активного» её не показывает.
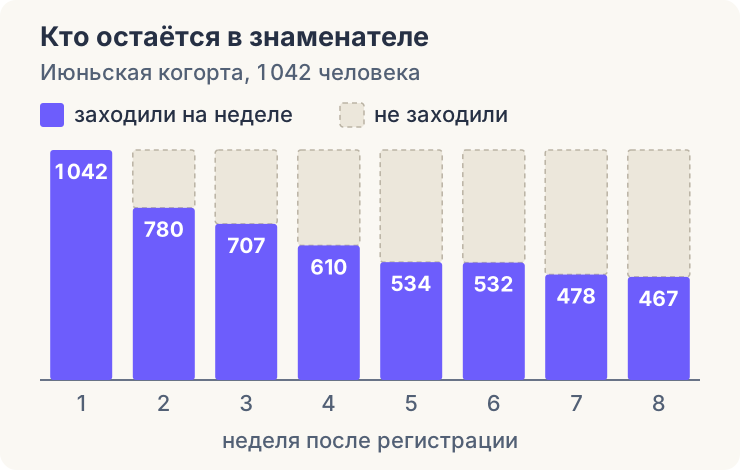
Учебная база симулятора SQL-аналитика, 1 042 регистрации июня 2026. На первой неделе линии совпадают: в день регистрации заходил каждый.
WITH cohort AS (
  SELECT user_id, signup_date
  FROM users
  WHERE signup_date >= DATE '2026-06-01' AND signup_date < DATE '2026-07-01'
),
active_days AS (
  SELECT DISTINCT c.user_id, CAST(e.event_time AS DATE) - c.signup_date AS day_no
  FROM cohort c
  JOIN events e ON e.user_id = c.user_id
  WHERE e.event_name = 'app_open'
),
weekly AS (
  SELECT
    user_id,
    CAST(FLOOR(day_no / 7.0) AS INTEGER) + 1 AS week_no,
    COUNT(*) AS days_active
  FROM active_days
  WHERE day_no < 56
  GROUP BY user_id, CAST(FLOOR(day_no / 7.0) AS INTEGER) + 1
)
SELECT
  week_no,
  COUNT(*) AS active_users,
  SUM(days_active) AS active_days,
  ROUND(1.0 * SUM(days_active) / COUNT(*), 2) AS days_per_active,
  ROUND(1.0 * SUM(days_active) / (SELECT COUNT(*) FROM cohort), 2) AS days_per_cohort
FROM weekly
GROUP BY week_no
ORDER BY week_no;
Чьё мнение вы слышите, когда опрашиваете дошедших до конца воронки?
Команда хочет понять, что мешает людям пользоваться продуктом, и рассылает опрос тем, кто выгрузил отчёт: с ними проще связаться, и им есть что сказать. В учебной базе экспорт сделали 988 человек из 4 613, то есть 21,4%. Остальных 3 625 не спросили.
Из платного поиска пришли 22,0% зарегистрированных, а среди сделавших экспорт таких 13,1%. Из 1 015 человек этого канала до экспорта дошли 129, или 12,7%, — вдвое реже, чем пришедшие по рекомендации (26,7%). Две оговорки. Платный поиск запущен 1 июля; на регистрациях с этой даты его доля — 28,4% зарегистрированных и 17,9% сделавших экспорт. И 126 человек, пришедших 28–29 августа, сделать экспорт ещё не успели: до него в базе проходит два дня.
Опрос ответит на вопрос «что думают те, у кого получилось». О том, почему 886 человек из платного поиска до экспорта не добрались, он не скажет ничего: этих людей в выборке нет вовсе, а от всего канала в ней 129 человек из 988. Так же устроены отзывы и обращения в поддержку — пишут те, кто ещё пользуется продуктом.
Таблицы отзывов в учебной базе нет, поэтому показан только состав выборки. Что ответили бы недошедшие, данные не знают.
| Канал | Зарегистрировались | Доля, % | Сделали экспорт | Доля среди них, % | Дошли до экспорта, % |
|---|---|---|---|---|---|
| organic | 1 747 | 37,9 | 415 | 42,0 | 23,8 |
| referral | 1 037 | 22,5 | 277 | 28,0 | 26,7 |
| paid_search | 1 015 | 22,0 | 129 | 13,1 | 12,7 |
| partner | 814 | 17,6 | 167 | 16,9 | 20,5 |
WITH exporters AS (
  SELECT DISTINCT user_id
  FROM events
  WHERE event_name = 'export_completed'
)
SELECT
  u.channel,
  COUNT(*) AS registered,
  ROUND(100.0 * COUNT(*) / SUM(COUNT(*)) OVER (), 1) AS share_registered,
  COUNT(x.user_id) AS exporters,
  ROUND(100.0 * COUNT(x.user_id) / SUM(COUNT(x.user_id)) OVER (), 1) AS share_exporters,
  ROUND(100.0 * COUNT(x.user_id) / COUNT(*), 1) AS export_rate
FROM users u
LEFT JOIN exporters x ON x.user_id = u.user_id
GROUP BY u.channel
ORDER BY registered DESC;
Что будет, если посчитать A/B-тест только по дошедшим?
В базе есть эксперимент onboarding_checklist: части пользователей на первом экране показывали чек-лист. В таблице experiment_exposures 3 068 человек, у каждого — вариант и флаг converted: совершил ли участник целевое действие теста. Оба промежуточных шага случаются после показа: пространство создают через 35 минут, экспорт делают через два дня. Честное сравнение идёт по всем, кому показали. Соблазнительное — «по тем, кто хотя бы создал рабочее пространство: остальные всё равно продуктом не пользовались».
Три способа отбора дают три ответа: +10,27, +9,76 и +12,11 п. п. На этой базе они расходятся в пределах шума. Зато выборка сжалась с 3 068 человек до 634, и интервал вокруг разницы вырос с ±3,05 до ±6,85 п. п.
Сильного искажения здесь нет: доля дошедших до шага в группах почти одинакова. Пространство создали 58,2% контроля и 60,5% теста — разница 2,4 ± 3,5 п. п., в пределах шума; экспорт сделали 20,6% и 20,8%. Учебные данные так построены, что чек-лист не меняет, кто дойдёт до шага. В настоящем эксперименте рассчитывать на это нельзя: изменение на первом экране часто влияет именно на то, кто пойдёт дальше.
| Кого считаем | Участников | control, % | checklist, % | Разница, п. п. | 95% интервал, ± п. п. |
|---|---|---|---|---|---|
| все показанные | 3 068 | 20,04 | 30,30 | +10,27 | 3,05 |
| создали пространство | 1 821 | 19,93 | 29,69 | +9,76 | 3,94 |
| сделали экспорт | 634 | 21,02 | 33,13 | +12,11 | 6,85 |
WITH steps AS (
  SELECT
    user_id,
    MAX(CASE WHEN event_name = 'workspace_created' THEN 1 ELSE 0 END) AS has_workspace,
    MAX(CASE WHEN event_name = 'export_completed' THEN 1 ELSE 0 END) AS has_export
  FROM events
  GROUP BY user_id
),
scoped AS (
  SELECT 1 AS scope_no, 'все показанные' AS scope, x.variant, x.converted
  FROM experiment_exposures x
  UNION ALL
  SELECT 2, 'создали пространство', x.variant, x.converted
  FROM experiment_exposures x
  JOIN steps s ON s.user_id = x.user_id
  WHERE s.has_workspace = 1
  UNION ALL
  SELECT 3, 'сделали экспорт', x.variant, x.converted
  FROM experiment_exposures x
  JOIN steps s ON s.user_id = x.user_id
  WHERE s.has_export = 1
)
SELECT
  scope,
  variant,
  COUNT(*) AS users,
  SUM(CASE WHEN converted THEN 1 ELSE 0 END) AS conversions,
  ROUND(100.0 * SUM(CASE WHEN converted THEN 1 ELSE 0 END) / COUNT(*), 2) AS conversion_pct
FROM scoped
GROUP BY scope_no, scope, variant
ORDER BY scope_no, variant DESC;import numpy as np
# из запроса выше: (участников, конверсий) для control и checklist
scopes = {
'все показанные': ((1527, 306), (1541, 467)),
'создали пространство': ((888, 177), (933, 277)),
'сделали экспорт': ((314, 66), (320, 106)),
}
shown_c, shown_t = 1527, 1541
for name, ((n_c, x_c), (n_t, x_t)) in scopes.items():
p_c, p_t = x_c / n_c, x_t / n_t
se = np.sqrt(p_c * (1 - p_c) / n_c + p_t * (1 - p_t) / n_t)
print(f'{name:21s} n = {n_c + n_t:4d}'
f' разница {(p_t - p_c) * 100:+.2f} ± {1.96 * se * 100:.2f} п. п.'
f' дошли: control {n_c / shown_c:.1%}, checklist {n_t / shown_t:.1%}')Почему сравнение по дошедшим нечестно, даже когда числа сошлись?
Рандомизация уравнивает группы в момент показа. Всё, что случилось после, может зависеть от варианта — в том числе и то, дошёл ли человек до шага. Отфильтровав по шагу, вы сравниваете две группы, отобранные по-разному.
Условный пример: числа придуманы для иллюстрации, это не учебная база. В каждой группе по 1 000 человек. В контроле до шага дошли 300, целевое действие совершили 150. Чек-лист довёл до шага 500 человек, целевое действие совершили 200.
По всем показанным тест выигрывает: 20% против 15%. По дошедшим проигрывает: 40% против 50%. Чек-лист привёл к шагу 200 дополнительных человек, менее мотивированных. Если те 300, кто дошёл бы и без чек-листа, ведут себя так же, как в контроле, то добавочные 200 дали 50 конверсий, то есть 25%. Они размыли долю, хотя принесли продукту 50 лишних конверсий.
Бывает и зеркальная картина: вариант отпугивает слабо заинтересованных, до шага доходят самые упорные, и конверсия «по дошедшим» растёт при падении общей. Поэтому знаменатель в A/B-тесте — все, кого распределили в группу. Шаг воронки можно сделать отдельной метрикой, но не фильтром. Резать результат можно по тому, что известно до показа: устройство, канал, дата регистрации. Такие сегменты рандомизация уравняла; пример — разбор этого теста по устройствам в SQL.
import pandas as pd

# условные числа, не учебная база: чек-лист доводит до шага больше людей
ab = pd.DataFrame({
    'variant':   ['control', 'checklist'],
    'shown':     [1000, 1000],
    'reached':   [300, 500],   # дошли до промежуточного шага
    'converted': [150, 200],   # совершили целевое действие
}).set_index('variant')

ab['cr_shown'] = ab.converted / ab.shown
ab['cr_reached'] = ab.converted / ab.reached
print(ab[['cr_shown', 'cr_reached']])

extra_reached = ab.loc['checklist', 'reached'] - ab.loc['control', 'reached']
extra_converted = ab.loc['checklist', 'converted'] - ab.loc['control', 'converted']
print(f'добавочных дошедших {extra_reached}, из них конверсий {extra_converted}'
f' ({extra_converted / extra_reached:.0%})')Как заметить ошибку выжившего в своём запросе?
Большую часть случаев закрывает один вопрос: кто не попал в выборку и почему. Если причина выбывания связана с метрикой — ушёл, не оплатил, не дошёл до шага, — результат смещён.
В SQL выжившие отбираются тихо, без предупреждений. WHERE status = 'active', JOIN с таблицей платежей или событий, HAVING COUNT(*) >= 3 — каждая такая строка убирает людей из знаменателя. Полезно посчитать, скольких именно.
| Фильтр | Осталось | Отброшено | Доля отброшенных, % |
|---|---|---|---|
| статус подписки active | 515 из 912 | 397 | 43,5 |
| заходил на восьмой неделе | 467 из 1 042 | 575 | 55,2 |
| есть событие export_completed | 988 из 4 613 | 3 625 | 78,6 |
| A/B: создал рабочее пространство | 1 821 из 3 068 | 1 247 | 40,6 |
- Знаменатель берите от входа: зарегистрировались, впервые оплатили, попали в группу теста. Не «остались на сегодня».
- Выбывшие остаются в расчёте со своими нулями:
LEFT JOINиCOALESCE(…, 0)вместоJOIN. - Сравнивайте когорты одного возраста, а не срез «все активные сейчас».
- Рядом со средней «по активным» ставьте число людей, по которым она посчитана, и размер исходной когорты.
- Пересчитайте метрику на полной совокупности. Если ответ заметно другой, фильтр отбирал не случайно.
Что показывает расчёт по когортам и где его границы?
Вернёмся к выручке на клиента и разложим её по месяцу регистрации. Знаменателей снова три: все зарегистрированные, все платившие и клиенты с активной подпиской.
Внутри когорты разница между «на платившего» и «на активного» почти исчезает: 43,65 и 44,02 в июне, 24,35 и 24,32 в августе. Активные клиенты не платят больше своих ровесников. Просто среди активных много июньских: 46,4% против 30,9% среди всех плативших. В общем срезе смешались когорты разного возраста, и фильтр по статусу сдвинул смесь в сторону старых.
У когорт своя ловушка, обратная: незрелость. Августовская регистрация принесла 3,29 доллара против 11,81 у июньской, и большая часть разрыва — незрелость: у этих людей было меньше месяца на первую оплату и не было времени на продление. Но не вся. За первые 30 дней жизни июньская когорта дала 6,64 доллара на зарегистрированного, июльская — 5,47: с 1 июля в базе появился платный поиск, и его пользователи платят реже. Сравнивайте когорты на одинаковом сроке жизни, а потом проверяйте, одинаков ли их состав. И причину ухода когорта не называет: она исправляет знаменатель, не больше.
| Месяц регистрации | Зарегистрировались | Платили | Активных подписок | На зарегистрированного | На платившего | На активного |
|---|---|---|---|---|---|---|
| июнь | 1 042 | 282 | 239 | 11,81 | 43,65 | 44,02 |
| июль | 1 676 | 374 | 229 | 7,22 | 32,34 | 33,56 |
| август | 1 895 | 256 | 47 | 3,29 | 24,35 | 24,32 |
WITH paid AS (
  SELECT user_id, SUM(amount) AS revenue
  FROM payments
  GROUP BY user_id
)
SELECT
  EXTRACT(MONTH FROM u.signup_date) AS signup_month,
  COUNT(*) AS registered,
  COUNT(p.user_id) AS payers,
  SUM(CASE WHEN s.status = 'active' THEN 1 ELSE 0 END) AS active_subs,
  ROUND(SUM(p.revenue) / COUNT(*), 2) AS revenue_per_registered,
  ROUND(SUM(p.revenue) / COUNT(p.user_id), 2) AS revenue_per_payer,
  ROUND(
    SUM(CASE WHEN s.status = 'active' THEN p.revenue ELSE 0 END)
      / SUM(CASE WHEN s.status = 'active' THEN 1 ELSE 0 END),
    2
  ) AS revenue_per_active
FROM users u
LEFT JOIN paid p ON p.user_id = u.user_id
LEFT JOIN subscriptions s ON s.user_id = u.user_id
GROUP BY EXTRACT(MONTH FROM u.signup_date)
ORDER BY signup_month;Чем ошибка выжившего отличается от смещения отбора и ошибки подтверждения?
Смещение отбора (selection bias) — общее название ситуаций, когда способ попадания в выборку связан с тем, что вы измеряете. Ошибка выжившего — его частный случай: отбор идёт во времени, и в выборке остаются те, кто «дожил». Смещение отбора бывает и без выбывания: опрос в мобильном приложении не слышит тех, кто работает с компьютера, хотя никто никуда не ушёл.
Ошибка подтверждения (confirmation bias) — не про данные, а про аналитика: это склонность искать и запоминать то, что подтверждает готовую гипотезу. Две ошибки часто работают в паре. Гипотеза «продукт удерживает хорошо» подсказывает посмотреть на активных, а данные по активным её подтверждают.
Когда смотреть только на выживших нормально? Когда вопрос о них самих: текущая месячная выручка, нагрузка на поддержку, план продлений на следующий месяц. Ошибка начинается в момент переноса, когда вывод по оставшимся распространяют на всех, кто приходит.
| Ошибка | Где возникает | Пример | Что помогает |
|---|---|---|---|
| Смещение отбора | Способ набора выборки связан с измеряемым | Опрос только в мобильном приложении | Описать, кто мог и кто не мог попасть в выборку |
| Ошибка выжившего | В выборке остались прошедшие отбор временем | Средняя выручка по активным подпискам | Знаменатель от входа в когорту |
| Ошибка подтверждения | В голове аналитика | Проверены только срезы, где гипотеза сходится | Заранее записать, какой результат гипотезу опровергнет |
Частые вопросы
Почему ошибку выжившего трудно заметить? Данные о выбывших не лежат рядом с пометкой «пропущено»: их нет в таблице, с которой вы работаете. Запрос выполняется, числа сходятся, и ничто не подсказывает, что знаменатель неполный.
Какие есть примеры ошибки выжившего? В аналитике — средний чек по активным клиентам, вовлечённость «на активного пользователя», опрос дошедших до конца воронки, A/B-тест по совершившим промежуточное действие. В быту — советы «как я добился успеха»: те, кто делал то же самое и не добился, советов не раздают.
Как избежать ошибки выжившего? Для каждой метрики «по активным» узнать, сколько людей отбросил фильтр, и пересчитать её от входа в когорту. Полный список проверок — в разделе о том, как заметить ошибку в своём запросе.
Как ошибка выжившего проявляется в бизнесе и инвестициях? Рейтинг фондов за десять лет состоит из фондов, которые эти десять лет просуществовали. Закрытые и присоединённые к другим в него не попадают, поэтому средняя доходность по списку выше той, что получил бы инвестор, выбиравший фонд в начале периода. С компаниями так же: в выборке «успешных» нет тех, кто действовал похоже и закрылся.
Ошибка выжившего и систематическая ошибка выжившего — одно и то же? Да. Оба названия переводят английское survivorship bias, второе подчёркивает, что искажение не случайное: оно повторится на любой выборке, собранной тем же способом.
Что читать дальше
Запросы из статьи можно выполнить в песочнице симулятора SQL-аналитика: там та же учебная база. Для начала поменяйте в запросе про недели июньскую когорту на июльскую и проверьте, на какой неделе её окно наблюдения перестаёт быть полным.
Второе упражнение — пересчитать таблицу каналов только для регистраций с 1 июля, когда запустили платный поиск, и посмотреть, как изменится его доля среди зарегистрированных и среди сделавших экспорт.
Материалы по теме
Парадокс Монти Холла: решение, объяснение простыми словами и симуляция
Парадокс Монти Холла простыми словами: почему смена двери выигрывает в 2/3 игр. Перебор, формула Байеса, симуляция на Python и SQL и три правила ведущего с разными ответами.
Закон больших чисел простыми словами: формулировка и примеры
Закон больших чисел: почему среднее и доля стабилизируются с ростом выборки. Пример с монетой, накопленная конверсия A/B-теста в SQL, слабая и сильная форма, ошибка игрока и когда закон работает медленно.
Нулевая гипотеза простыми словами: что это и как её формулировать
Нулевая гипотеза (H0) — утверждение, что эффекта или разницы нет. Чем она отличается от альтернативной гипотезы H1, как формулировать H0 для A/B-теста и продуктовых вопросов, что значит «отвергнуть» и «не отвергнуть» H0 — с расчётом z-теста на учебной базе.