Коэффициент вариации: формула, расчёт и как читать
Коэффициент вариации — стандартное отклонение в процентах от среднего. Формула, пример на пяти числах, расчёт в SQL, Python и Excel, порог 33% для НМЦК и ловушки.
Содержание статьи
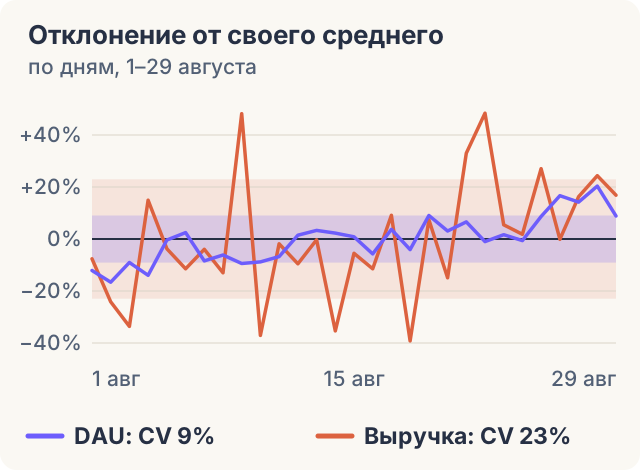
В отчёте за август рядом стоят два стандартных отклонения: у DAU (числа активных пользователей за день) — 44 пользователя, у дневной выручки — 119 долларов. Менеджер спрашивает, какая метрика стабильнее, а сравнить эти числа напрямую нельзя: они в разных единицах и разного масштаба. Коэффициент вариации переводит оба разброса в проценты от собственного среднего — 9% и 23% — и ответ появляется. Дальше — формула, расчёт руками, в SQL, Python и Excel, происхождение порога 33% и ситуации, где показатель обманывает.
Что такое коэффициент вариации простыми словами
Коэффициент вариации (CV, в русских учебниках чаще V) — это стандартное отклонение, выраженное в долях или процентах от среднего. Он отвечает на вопрос, насколько сильно значения гуляют относительно своего обычного уровня. CV = 10% означает: стандартное отклонение равно десятой части среднего.
При делении единицы измерения сокращаются, и показатель получается безразмерным. Поэтому можно поставить рядом разброс рублей и штук, выручку одного магазина и целой сети. Термин coefficient of variation ввёл Карл Пирсон в статье 1896 года — так указано в справочнике Earliest Known Uses of Some of the Words of Probability & Statistics.
- Формула: CV = s / x̄ · 100%, где s — стандартное отклонение, x̄ — среднее арифметическое.
- Имеет смысл только для величин с естественным нулём и положительным средним: деньги, штуки, длительность. Для приростов, температуры в °C и метрик со средним около нуля он бесполезен.
- Пороги 10% и 33% — соглашение из учебников. В госзакупках граница 33% записана в методических рекомендациях по расчёту НМЦК.
- CV зависит от нарезки данных: по дням он выше, чем по неделям, а на трёх–пяти точках скачет от случая к случаю.
Формула коэффициента вариации и пример расчёта вручную
Кофейная точка за пять будних дней выручила 42, 48, 50, 53 и 57 тысяч рублей. Сумма — 250, среднее — 50 тысяч в день.
Дальше четыре шага. Отнимаем среднее от каждого дня: −8, −2, 0, 3, 7. Возводим отклонения в квадрат и складываем — получается 126. Делим на n − 1 = 4 и извлекаем корень: √31,5 ≈ 5,61 тысячи рублей, это стандартное отклонение. Делим его на среднее: 5,61 / 50 = 0,112, то есть CV = 11,2%.
Читается результат так: разброс дневной выручки — около 11% от её обычного уровня. Это не среднее отклонение по модулю (оно здесь 4 тысячи, или 8%): стандартное отклонение сильнее учитывает крупные отклонения. У соседней точки со средним 200 тысяч и отклонением 12 тысяч CV равен 6%: в рублях она колеблется вдвое сильнее, относительно своего масштаба — почти вдвое слабее.
CV = s / x̄ · 100%; s = √( Σ(x − x̄)² / (n − 1) )s — выборочное стандартное отклонение, x̄ — среднее, n — число значений. Результат записывают долей (0,112) или в процентах (11,2%).
| День | Выручка, x | Отклонение x − x̄ | Квадрат отклонения |
|---|---|---|---|
| 1 | 42 | −8 | 64 |
| 2 | 48 | −2 | 4 |
| 3 | 50 | 0 | 0 |
| 4 | 53 | 3 | 9 |
| 5 | 57 | 7 | 49 |
| Итого | среднее 50 | сумма 0 | сумма 126 |
| Стандартное отклонение | √(126 / 4) ≈ 5,61 | ||
| Коэффициент вариации | 5,61 / 50 = 11,2% |
Зачем нужен коэффициент вариации, если есть стандартное отклонение
Стандартное отклонение измеряется в единицах самой метрики. В учебной базе продукта «Маяк» за полные дни 1–29 августа у DAU оно равно 44,1 пользователя, у числа оплат в день — 4,6 штуки, у дневной выручки — 119,3 доллара. Какое из трёх чисел больше — вопрос без смысла.
Делим каждое на своё среднее и получаем CV: DAU — 9,0%, оплаты — 21,7%, выручка — 23,0%. Теперь ответ есть: выручка от дня к дню колеблется в 2,5 раза сильнее аудитории. Виден и источник: CV выручки почти совпадает с CV числа оплат, значит, шумит количество платежей: размер платежа почти постоянен.
Оговорка о запросе: день без единой оплаты в группировку не попадёт. В августе оплаты были каждый день, а на редких событиях сначала нужен календарь с нулями, иначе CV окажется заниженным.
В pandas расчёт занимает одну строку, df.std() / df.mean(): метод std() по умолчанию делит на n − 1, как и stddev_samp.
WITH active AS (
  SELECT CAST(event_time AS date) AS day, COUNT(DISTINCT user_id) AS dau
  FROM events
  WHERE event_time >= TIMESTAMP '2026-08-01'
    AND event_time <  TIMESTAMP '2026-08-30'
  GROUP BY CAST(event_time AS date)
),
paid AS (
  SELECT paid_at AS day, COUNT(*) AS payments, SUM(amount) AS revenue
  FROM payments
  WHERE paid_at >= DATE '2026-08-01' AND paid_at < DATE '2026-08-30'
  GROUP BY paid_at
)
SELECT 'DAU' AS metric, COUNT(*) AS days,
  ROUND(AVG(dau), 1) AS mean_value,
  ROUND(CAST(STDDEV_SAMP(dau) AS numeric), 1) AS sd,
  ROUND(CAST(100.0 * STDDEV_SAMP(dau) / AVG(dau) AS numeric), 1) AS cv_pct
FROM active
UNION ALL
SELECT 'оплат в день', COUNT(*),
  ROUND(AVG(payments), 1),
  ROUND(CAST(STDDEV_SAMP(payments) AS numeric), 1),
  ROUND(CAST(100.0 * STDDEV_SAMP(payments) / AVG(payments) AS numeric), 1)
FROM paid
UNION ALL
SELECT 'выручка', COUNT(*),
  ROUND(AVG(revenue), 1),
  ROUND(CAST(STDDEV_SAMP(revenue) AS numeric), 1),
  ROUND(CAST(100.0 * STDDEV_SAMP(revenue) / AVG(revenue) AS numeric), 1)
FROM paid
ORDER BY cv_pct;
-- DAU           29  486.9   44.1   9.0
-- оплат в день  29   21.1    4.6  21.7
-- выручка 29 519.6 119.3 23.0import pandas as pd
df = pd.DataFrame({
"dau": [428, 406, 443, 419, 485, 499, 446, 457, 441, 444, 454, 494, 503, 498, 491,
459, 505, 467, 531, 502, 519, 482, 495, 484, 529, 568, 556, 586, 530],
"revenue": [480, 394, 345, 597, 500, 460, 499, 452, 770, 327, 510, 470, 518, 336, 491,
460, 567, 316, 558, 442, 691, 771, 548, 529, 660, 519, 604, 646, 607],
})
cv = df.std() / df.mean() * 100 # std() в pandas делит на n − 1
print(cv.round(2).to_dict()) # {'dau': 9.05, 'revenue': 22.96}Как сравнить разброс между группами: тарифы и каналы
Вопрос «у какого тарифа платежи однороднее» в учебной базе упирается в данные: сумма одной оплаты внутри тарифа постоянна (19, 29 или 39 долларов), её CV равен нулю. Содержательная величина — выручка с плательщика за всё время: кто-то заплатил раз, кто-то продлевал.
Стандартное отклонение говорит, что на team разброс вдвое больше, чем на basic: 24,02 доллара против 11,07. Коэффициент вариации показывает, что это эффект цены: 42,4% у basic и pro, 44,2% у team. Плательщики трёх тарифов ведут себя одинаково, различается только размер платежа.
С каналами привлечения наоборот: CV сам рисует различие, которого нет. По всем дням августа дневные регистрации дают 37,5% у organic, 38,4% у paid_search, 45,2% у partner и 45,9% у referral. Большая часть этого разброса — будни против выходных, поэтому в запросе оставлены только будни: 17,2%, 19,0%, 27,1% и 26,0%.
Кажется, что organic и paid_search ровнее. Но у счётчиков есть свойство: чем меньше среднее, тем больше относительный шум. У пуассоновского потока событий стандартное отклонение равно корню из среднего, то есть CV = 1 / √среднее. При 28,2 регистрации в день ориентир равен 18,8%, при 12,6 регистрации — уже 28,2%. Фактические CV каналов почти совпадают с этим ориентиром: в учебной базе каналы различаются только объёмом. Ориентир — не закон. Сумма всех каналов в будни (80,0 регистрации в день) даёт CV 6,5% при пуассоновских 11,2%: учебные данные ровнее случайного потока. В живых продуктах обычно наоборот — счётчики шумят сильнее ориентира.
Учебная база симулятора SQL-аналитика, 1–29 августа 2026. Ориентир — CV пуассоновского счётчика с тем же средним в будни: 100 / √среднее.
WITH payer AS (
  SELECT user_id, MIN(plan) AS plan, SUM(amount) AS revenue
  FROM payments
  GROUP BY user_id
)
SELECT plan, COUNT(*) AS payers,
  ROUND(AVG(revenue), 2) AS mean_revenue,
  ROUND(CAST(STDDEV_SAMP(revenue) AS numeric), 2) AS sd,
  ROUND(CAST(100.0 * STDDEV_SAMP(revenue) / AVG(revenue) AS numeric), 1) AS cv_pct
FROM payer
GROUP BY plan
ORDER BY plan;
-- basic  514  26.10  11.07  42.4
-- pro    296  39.48  16.74  42.4
-- team 102 54.29 24.02 44.2WITH daily AS (
SELECT signup_date AS day, channel, COUNT(*) AS signups
FROM users
WHERE signup_date >= DATE '2026-08-01' AND signup_date < DATE '2026-08-30'
GROUP BY signup_date, channel
)
SELECT channel, COUNT(*) AS days,
ROUND(AVG(signups), 1) AS mean_signups,
ROUND(CAST(100.0 * STDDEV_SAMP(signups) / AVG(signups) AS numeric), 1) AS cv_pct,
ROUND(CAST(100.0 / SQRT(AVG(signups)) AS numeric), 1) AS poisson_cv_pct
FROM daily
WHERE EXTRACT(isodow FROM day) < 6
GROUP BY channel
ORDER BY cv_pct;
-- organic 20 28.2 17.2 18.8
-- paid_search 20 22.4 19.0 21.2
-- referral 20 16.8 26.0 24.4
-- partner 20 12.6 27.1 28.2Выборочный или генеральный: делить на n − 1 или на n
Коэффициентов вариации два, как и стандартных отклонений. Выборочный делит сумму квадратов на n − 1, генеральный — на n. Если ваши данные — часть процесса, о котором вы делаете вывод (дни месяца, цены нескольких поставщиков, участники теста), берите n − 1.
На пяти числах из примера разница заметна: 11,22% против 10,04%. На 29 днях DAU — 9,05% против 8,89%. На 1 251 оплате — 28,14% против 28,13%. Генеральный вариант равен выборочному, умноженному на √((n − 1) / n): он меньше на 10,6% при n = 5 и на 1,7% при n = 29.
Главная ловушка — умолчания библиотек. numpy.std и scipy.stats.variation по умолчанию делят на n (ddof=0), а stddev_samp, метод std() в pandas и СТАНДОТКЛОН.В в Excel — на n − 1. Документация SciPy сама советует ddof=1, ноль оставлен ради обратной совместимости. Если цифра из ноутбука расходится с цифрой из SQL на доли процента, сначала проверьте знаменатель.
| Инструмент | Как посчитать CV | Знаменатель |
|---|---|---|
| PostgreSQL, DuckDB | stddev_samp(x) / avg(x) | n − 1 |
| pandas | s.std() / s.mean() | n − 1 |
| NumPy | x.std() / x.mean() | n; с ddof=1 — n − 1 |
| SciPy | stats.variation(x) | n; с ddof=1 — n − 1 |
| Excel | СТАНДОТКЛОН.В(…) / СРЗНАЧ(…) | n − 1 |
| Excel | СТАНДОТКЛОН.Г(…) / СРЗНАЧ(…) | n |
WITH days AS (
  SELECT CAST(event_time AS date) AS day, COUNT(DISTINCT user_id) AS dau
  FROM events
  WHERE event_time >= TIMESTAMP '2026-08-01'
    AND event_time <  TIMESTAMP '2026-08-30'
  GROUP BY CAST(event_time AS date)
)
SELECT 'DAU по дням' AS sample, COUNT(*) AS n,
  ROUND(CAST(100.0 * STDDEV_SAMP(dau) / AVG(dau) AS numeric), 2) AS cv_sample,
  ROUND(CAST(100.0 * STDDEV_POP(dau) / AVG(dau) AS numeric), 2) AS cv_population
FROM days
UNION ALL
SELECT 'сумма оплаты', COUNT(*),
  ROUND(CAST(100.0 * STDDEV_SAMP(amount) / AVG(amount) AS numeric), 2),
  ROUND(CAST(100.0 * STDDEV_POP(amount) / AVG(amount) AS numeric), 2)
FROM payments
ORDER BY n;
-- DAU по дням     29   9.05   8.89
-- сумма оплаты 1251 28.14 28.13import numpy as np
from scipy import stats
x = np.array([42, 48, 50, 53, 57]) # выручка точки за пять дней, тыс. ₽
cv_sample = x.std(ddof=1) / x.mean() * 100 # делитель n − 1
cv_population = x.std(ddof=0) / x.mean() * 100 # делитель n
print(round(cv_sample, 2), round(cv_population, 2)) # 11.22 10.04
print(round(stats.variation(x) * 100, 2)) # 10.04 — по умолчанию ddof=0
print(round(stats.variation(x, ddof=1) * 100, 2)) # 11.22 — как stddev_samp / avgКакой коэффициент вариации считается нормальным: откуда 10% и 33%
В русскоязычных учебниках общей теории статистики CV используют как признак однородности совокупности. В пособии УрФУ «Основы теории статистики» (Полякова, Шаброва, 2015) шкала такая: до 10% — совокупность однородная, 10–20% — достаточно однородная, 20–33% — достаточно разнородная, свыше 33% — разнородная. Те же границы часто описывают словами об изменчивости: до 10% — незначительная, 10–20% — средняя, 20–33% — значительная, выше 33% — совокупность неоднородна.
Откуда число 33, учебники объясняют редко; обычно ограничиваются оговоркой, что правило относится к распределениям, близким к нормальному. Правдоподобная арифметика: 33% — это треть. Если стандартное отклонение равно трети среднего, ноль лежит в трёх стандартных отклонениях от него, и у нормального распределения ниже нуля оказывается 0,13% значений. При большем CV нормальная кривая для положительной величины заметно залезает в минус, то есть описывает данные плохо. Высокий CV подсказывает искать скошенность или смесь групп, но сам их не различает.
Это соглашение, а не закон. У экспоненциального распределения стандартное отклонение равно среднему, CV всегда 100%, хотя совокупность может быть совершенно однородной.
Но иногда правило срабатывает по существу. Дневные регистрации за август дают CV 34,6% — формально «неоднородная совокупность». Причина — смесь двух режимов: в будни в среднем 80,0 регистрации при CV 6,5%, в выходные — 32,9 при CV 10,0%. Высокий CV здесь подсказал разрез. Субботы выбрасывать не нужно: будни и выходные анализируют раздельно.
Свои пороги есть и у XYZ-анализа, где товары или клиентов делят по стабильности спроса: X — CV до 10%, Y — от 10 до 25%, Z — выше 25%. Это тоже договорённость: границы выбирают под свои данные до расчёта. Заранее фиксируют и знаменатель: в нашем разборе ABC и XYZ взят делитель n, на восьми периодах такой CV на 6,5% меньше выборочного. С порогами сравнивают один и тот же вариант.
WITH daily AS (
  SELECT signup_date AS day, COUNT(*) AS signups
  FROM users
  WHERE signup_date >= DATE '2026-08-01' AND signup_date < DATE '2026-08-30'
  GROUP BY signup_date
)
SELECT CASE WHEN EXTRACT(isodow FROM day) >= 6 THEN 'выходные' ELSE 'будни' END AS day_type,
  COUNT(*) AS days,
  ROUND(AVG(signups), 1) AS mean_signups,
  ROUND(CAST(100.0 * STDDEV_SAMP(signups) / AVG(signups) AS numeric), 1) AS cv_pct
FROM daily
GROUP BY CASE WHEN EXTRACT(isodow FROM day) >= 6 THEN 'выходные' ELSE 'будни' END
UNION ALL
SELECT 'все дни', COUNT(*),
  ROUND(AVG(signups), 1),
  ROUND(CAST(100.0 * STDDEV_SAMP(signups) / AVG(signups) AS numeric), 1)
FROM daily
ORDER BY days DESC;
-- все дни   29  65.3  34.6
-- будни     20  80.0   6.5
-- выходные 9 32.9 10.0Коэффициент вариации в закупках: правило 33% для НМЦК
В госзакупках коэффициент вариации — обязательная часть расчёта цены. Заказчик по закону № 44-ФЗ обосновывает начальную (максимальную) цену контракта — НМЦК. При методе сопоставимых рыночных цен он собирает цены единицы товара из нескольких источников: ответы поставщиков на запросы (коммерческие предложения), реестр контрактов, общедоступные прайсы.
Порядок описан в Методических рекомендациях, утверждённых приказом Минэкономразвития России от 02.10.2013 № 567. Пункт 3.19 рекомендует использовать не менее трёх цен от разных поставщиков. Пункт 3.20 рекомендует определять коэффициент вариации, чтобы оценить однородность собранных цен. Формула та же: V = σ / <ц> · 100, где <ц> — средняя цена, а σ — среднее квадратичное отклонение с делителем n − 1. По пункту 3.20.1 считать можно стандартными функциями табличного редактора. В Excel это =СТАНДОТКЛОН.В(B2:B5)/СРЗНАЧ(B2:B5)*100.
Порог задаёт пункт 3.20.2: совокупность цен считается неоднородной, если коэффициент вариации превышает 33%. На этот случай там же сказано, что «целесообразно провести дополнительные исследования», чтобы увеличить количество ценовой информации. Указания исключать самую высокую или самую низкую цену в этом пункте нет. Сама НМЦК по пункту 3.21 — объём закупки, умноженный на среднюю цену.
В приложении № 3 к рекомендациям есть пример: закупка сплит-систем, четыре цены из реестра контрактов. Среднее — 29 982,33 ₽, отклонение — 8 809,66 ₽, V = 29,38%, совокупность принята однородной. Пересчёт в блоке ниже даёт те же числа.
Запас здесь небольшой, и знаменатель важен. По первым трём ценам из того же примера CV с делителем n − 1 равен 33,03% — выше порога. Если по ошибке взять СТАНДОТКЛОН.Г, получится 26,97%, и та же тройка «пройдёт» проверку.
| Источник | Цена за единицу, ₽ |
|---|---|
| Контракт 1 | 29 000,00 |
| Контракт 2 | 17 899,73 |
| Контракт 3 | 36 000,00 |
| Контракт 4 | 37 029,60 |
| Средняя цена | 29 982,33 |
| Стандартное отклонение (n − 1) | 8 809,66 |
| Коэффициент вариации | 29,38% |
import numpy as np

# цены за единицу из приложения № 3 к Методическим рекомендациям (приказ № 567)
prices = np.array([29000.00, 17899.73, 36000.00, 37029.60])

mean = prices.mean()
s = prices.std(ddof=1)                     # делитель n − 1, как в пункте 3.20
print(round(mean, 2), round(s, 2), round(s / mean * 100, 2))
# 29982.33 8809.66 29.38

three = prices[:3]                         # если бы цен было только три
print(round(three.std(ddof=1) / three.mean() * 100, 2))   # 33.03 — выше порога
print(round(three.std(ddof=0) / three.mean() * 100, 2)) # 26.97 — делитель n, ошибкаРаздел пересказывает текст рекомендаций в редакции, доступной в правовых базах 2 октября 2026 года. По пункту 1.2 они разъясняют возможные способы определения НМЦК; для отдельных товаров, работ и услуг порядок задают другие акты. Применимость к своей закупке проверяйте по действующим документам.
Когда коэффициент вариации считать нельзя
Первый случай — среднее около нуля. Возьмём изменение DAU к прошлому дню за тот же август: в среднем +3,64 пользователя при стандартном отклонении 33,8. CV получается 928%. О стабильности это число ничего не говорит: сам DAU, из которого получены разности, имеет CV 9%. Знаменатель почти нулевой, и результат определяется им. Окажись среднее изменение отрицательным, отрицательным вышел бы и CV.
Второй случай — шкала без естественного нуля. Условная неделя в ноябре: −4, −1, 0, 2, 3, 5 и 2 °C. Среднее — 1,0 °C, стандартное отклонение — 2,94, CV — 294,4%. Переведём те же дни в кельвины: среднее 274,15 К, отклонение те же 2,94, CV — 1,07%. Погода одна, а «изменчивость» различается больше чем в 270 раз, потому что ноль шкалы Цельсия назначен условно.
Отсюда правило: CV осмыслен только там, где ноль означает «ничего нет», а значения не бывают отрицательными, — рубли, штуки, секунды. Разности, приросты в процентах, z-оценки и баллы по шкале от −100 до 100 под него не подходят. Для них разброс описывают самим стандартным отклонением.
WITH days AS (
  SELECT CAST(event_time AS date) AS day, COUNT(DISTINCT user_id) AS dau
  FROM events
  WHERE event_time >= TIMESTAMP '2026-08-01'
    AND event_time <  TIMESTAMP '2026-08-30'
  GROUP BY CAST(event_time AS date)
),
delta AS (
  SELECT day, dau - LAG(dau) OVER (ORDER BY day) AS change
  FROM days
)
SELECT COUNT(change) AS n,
  ROUND(AVG(change), 2) AS mean_change,
  ROUND(CAST(STDDEV_SAMP(change) AS numeric), 1) AS sd_change,
  ROUND(CAST(100.0 * STDDEV_SAMP(change) / AVG(change) AS numeric), 0) AS cv_pct
FROM delta;
-- 28 3.64 33.8 928WITH t(day_no, celsius) AS (
VALUES (1, -4.0), (2, -1.0), (3, 0.0), (4, 2.0), (5, 3.0), (6, 5.0), (7, 2.0)
)
SELECT
ROUND(AVG(celsius), 2) AS mean_c,
ROUND(CAST(STDDEV_SAMP(celsius) AS numeric), 2) AS sd_c,
ROUND(CAST(100.0 * STDDEV_SAMP(celsius) / AVG(celsius) AS numeric), 1) AS cv_c_pct,
ROUND(AVG(celsius + 273.15), 2) AS mean_k,
ROUND(CAST(STDDEV_SAMP(celsius + 273.15) AS numeric), 2) AS sd_k,
ROUND(CAST(100.0 * STDDEV_SAMP(celsius + 273.15) / AVG(celsius + 273.15) AS numeric), 2) AS cv_k_pct
FROM t;
-- 1.00 2.94 294.4 274.15 2.94 1.07Что раздувает коэффициент вариации на реальных данных
Нули и длинный хвост. Выручка на пользователя по всем 4 613 зарегистрированным: среднее 6,64 доллара, стандартное отклонение 15,53, CV 233,8%. По 912 плательщикам — 33,60, 17,74 и 52,8%. Разница в четыре с лишним раза — это доля нулей: 80% пользователей не платили. Сначала решите, чей разброс вам нужен.
Тренд. CV DAU за август — 9,0%, а за все 90 полных дней выгрузки — 45,0%: аудитория выросла с 32 человек в первый день до 530–590 в конце августа, и стандартное отклонение измерило рост. Рост есть и внутри августа, около 4 пользователей в день: если вычесть линейный тренд, CV августовского DAU падает с 9,0% до 5,3%, у выручки — с 23,0% до 21,1%. Считайте CV на окне без тренда или на отклонениях от него.
Выбросы. Добавьте к 29 дням неполное 30 августа, где данные обрываются в 12:59 и DAU равен 223: CV вырастает с 9,05% до 13,55%, в полтора раза из-за одной точки.
Устойчивая альтернатива — отношение межквартильного размаха к медиане, (Q3 − Q1) / медиана. Для DAU за 1–29 августа это (505 − 454) / 491 = 10,4%, для дневной выручки — (597 − 460) / 510 = 26,9%. Неполный день сдвигает показатель только до 11,6%. С CV его напрямую не сравнивают: у нормального распределения этот размах равен 1,35 стандартного отклонения. Предел есть и у него: у выручки на пользователя медиана и оба квартиля равны нулю, делить не на что.
WITH per_user AS (
  SELECT u.user_id, COALESCE(SUM(p.amount), 0) AS revenue
  FROM users u
  LEFT JOIN payments p ON p.user_id = u.user_id
  GROUP BY u.user_id
)
SELECT 'все пользователи' AS grp, COUNT(*) AS users,
  ROUND(AVG(revenue), 2) AS mean_revenue,
  ROUND(CAST(STDDEV_SAMP(revenue) AS numeric), 2) AS sd,
  ROUND(CAST(100.0 * STDDEV_SAMP(revenue) / AVG(revenue) AS numeric), 1) AS cv_pct
FROM per_user
UNION ALL
SELECT 'только плательщики', COUNT(*),
  ROUND(AVG(revenue), 2),
  ROUND(CAST(STDDEV_SAMP(revenue) AS numeric), 2),
  ROUND(CAST(100.0 * STDDEV_SAMP(revenue) / AVG(revenue) AS numeric), 1)
FROM per_user
WHERE revenue > 0
ORDER BY users DESC;
-- все пользователи    4613   6.64  15.53  233.8
-- только плательщики 912 33.60 17.74 52.8WITH days AS (
SELECT CAST(event_time AS date) AS day, COUNT(DISTINCT user_id) AS dau
FROM events
WHERE event_time >= TIMESTAMP '2026-08-01'
GROUP BY CAST(event_time AS date)
),
labelled AS (
SELECT '1–29 августа' AS period, dau FROM days WHERE day < DATE '2026-08-30'
UNION ALL
SELECT '1–30 августа' AS period, dau FROM days
)
SELECT period, COUNT(*) AS days,
ROUND(CAST(100.0 * STDDEV_SAMP(dau) / AVG(dau) AS numeric), 2) AS cv_pct,
ROUND(CAST(100.0
* (PERCENTILE_CONT(0.75) WITHIN GROUP (ORDER BY dau)
- PERCENTILE_CONT(0.25) WITHIN GROUP (ORDER BY dau))
/ PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY dau) AS numeric), 1) AS iqr_to_median_pct
FROM labelled
GROUP BY period
ORDER BY days;
-- 1–29 августа 29 9.05 10.4
-- 1–30 августа 30 13.55 11.6Почему дневной и недельный коэффициент вариации не совпадают
Возьмём четыре полные недели с 27 июля по 23 августа. Регистрации по дням: среднее 63,2, CV 32,3%. Те же регистрации, сложенные в недели: среднее 442,3, CV 7,4%. У выручки за тот же период — 24,3% по дням и 9,6% по неделям.
Противоречия нет: это разные величины. Недельная сумма целиком поглощает разницу между буднями и выходными и сглаживает случайный шум. Оставшиеся 7,4% у регистраций — почти целиком рост: 404, 430, 454 и 481 регистрация, по 24–27 в неделю. Если вычесть эту прямую, от разброса остаётся 0,2%. Недельная выручка (3 372, 3 623, 3 112 и 3 893 доллара) такого роста не показывает, её 9,6% — колебания. Поэтому CV всегда называют вместе с шагом: «CV дневных регистраций — 32%». Сравнивать дневной CV одного продукта с недельным CV другого нельзя. По той же причине средний чек за день стабильнее отдельной оплаты: в августе его CV — 5,1% против 28,1% у самих сумм.
Недельный CV здесь посчитан по четырём точкам, и верить ему до десятых не стоит. Насколько ненадёжны малые выборки, показывает перебор: из 29 дней августовской выручки можно составить 3 654 тройки. CV по тройке получается от 0,9% до 55,1%, хотя у всех 29 дней он равен 23,0%. У 17,7% троек он ниже 10%, у 12,2% — выше 33%. Три цены в расчёте НМЦК — выборка того же размера, и совет собрать больше цен при высоком CV с этим согласуется.
WITH daily AS (
  SELECT signup_date AS day, COUNT(*) AS signups
  FROM users
  WHERE signup_date >= DATE '2026-07-27' AND signup_date < DATE '2026-08-24'
  GROUP BY signup_date
),
weekly AS (
  SELECT CAST(date_trunc('week', day) AS date) AS week_start, SUM(signups) AS signups
  FROM daily
  GROUP BY CAST(date_trunc('week', day) AS date)
)
SELECT 'по дням' AS grain, COUNT(*) AS periods,
  ROUND(AVG(signups), 1) AS mean_signups,
  ROUND(CAST(100.0 * STDDEV_SAMP(signups) / AVG(signups) AS numeric), 1) AS cv_pct
FROM daily
UNION ALL
SELECT 'по неделям', COUNT(*),
  ROUND(AVG(signups), 1),
  ROUND(CAST(100.0 * STDDEV_SAMP(signups) / AVG(signups) AS numeric), 1)
FROM weekly
ORDER BY periods DESC;
-- по дням     28   63.2  32.3
-- по неделям 4 442.3 7.4Частые вопросы
Как рассчитать коэффициент вариации? Найдите среднее, посчитайте стандартное отклонение (с делителем n − 1, если данные — выборка), разделите второе на первое и умножьте на 100%. Для чисел 42, 48, 50, 53, 57 это 5,61 / 50 = 11,2%.
Какой коэффициент вариации считается нормальным? Единого норматива нет. Учебное соглашение: до 10% — изменчивость незначительная, 10–20% — средняя, 20–33% — значительная, выше 33% — совокупность неоднородна. В XYZ-анализе границы — 10% и 25%, в расчёте НМЦК — 33%. Полезнее сравнивать CV метрики с её же значением за прошлые периоды.
Может ли коэффициент вариации быть больше 100%? Да, когда стандартное отклонение больше среднего. У выручки на пользователя с нулями в учебной базе он равен 233,8%. Расчёт верен: так выглядит масса нулей или длинный хвост.
В чём измеряется коэффициент вариации? Ни в чём: единицы числителя и знаменателя сокращаются. Его записывают долей (0,23) или в процентах (23%).
Как посчитать коэффициент вариации в Excel? Отдельной функции нет: нужна формула =СТАНДОТКЛОН.В(A2:A30)/СРЗНАЧ(A2:A30) и процентный формат ячейки. СТАНДОТКЛОН.В считает по выборке (n − 1); для всей совокупности берут СТАНДОТКЛОН.Г. В Excel 2007 и старше те же функции называются СТАНДОТКЛОН (n − 1) и СТАНДОТКЛОНП (n).
Что попробовать на учебной базе
Все запросы статьи можно выполнить в песочнице симулятора SQL-аналитика на этой же базе. Для начала посчитайте CV дневного DAU отдельно по месяцам, оставив только полные дни (event_time < TIMESTAMP '2026-08-30'): должно получиться 40,0% в июне, 18,1% в июле и 9,0% в августе. Без этого условия август даст 13,5% — из-за неполного 30-го числа. Объясните, почему июньское число говорит о росте, а не о нестабильности.
Материалы по теме
Дисперсия и стандартное отклонение: что это и как посчитать
Дисперсия — средний квадрат отклонения от среднего, стандартное отклонение — корень из неё. Формулы, пример на пяти числах, почему делят на n − 1, расчёт в SQL, Excel и Python, типичные ошибки.
ABC и XYZ-анализ: что это, как сделать и пример расчёта
ABC-анализ делит клиентов или товары на группы по вкладу в выручку, XYZ — по стабильности продаж. Как сделать оба, матрица из 9 ячеек и пример на SQL.
Статистика для аналитика с нуля: разброс, перцентили, форма данных и выборка
Что из статистики нужно в рабочий день: как читать разброс и стандартное отклонение, зачем p90 и p99, почему продуктовые данные почти никогда не нормальные и чем выборочная ошибка отличается от смещения.