Размах в статистике: что это, как найти и чем он обманывает
Размах — разность между наибольшим и наименьшим значением ряда. Формула, пример на семи числах, SQL и Python, межквартильный размах и ловушки: выброс, тренд, объём выборки.
Содержание статьи
Размах — это разность между наибольшим и наименьшим значением в наборе чисел: R = максимум − минимум. Для ряда 28, 31, 35, 36, 40, 42, 47 он равен 47 − 28 = 19. Это самая простая мера разброса: её проходят в седьмом классе, и она же стоит в рабочих отчётах в виде «DAU (число активных пользователей за день) в августе — от 406 до 586». За простоту приходится платить: размах целиком определяют два наблюдения, в среднем он растёт вместе с объёмом выборки, а один неполный день в примере ниже увеличил его вдвое. Дальше — расчёт руками, в SQL и Python, межквартильный размах и задачи, где размах работает по делу.
Что такое размах простыми словами
Размах (в учебниках статистики — размах вариации, обозначается R; по-английски range) показывает ширину коридора, в который уложились все значения, от самого маленького до самого большого. Измеряется он в тех же единицах, что и данные: в минутах, рублях, пользователях.
В школьном курсе «Вероятность и статистика» размах появляется в 7 классе рядом со средним арифметическим, медианой, наибольшим и наименьшим значениями. Определение во взрослой статистике то же: в Большой советской энциклопедии размах — «разность между наибольшим и наименьшим значениями результатов наблюдений».
- Формула: R = x_max − x_min. Сортировать ряд необязательно: нужны только два крайних числа.
- Он зависит от выбросов — резко выделяющихся значений — и от числа наблюдений, поэтому размах выборок разного объёма напрямую не сравнивают.
- Устойчивый родственник — межквартильный размах IQR = Q3 − Q1, ширина средней половины данных.
Как найти размах: пример на семи числах
Служба доставки записала время семи заказов в минутах: 35, 28, 47, 31, 40, 36, 42. Находим наибольшее значение — 47, наименьшее — 28 и вычитаем: 47 − 28 = 19 минут. Длинный ряд удобно сначала отсортировать — 28, 31, 35, 36, 40, 42, 47, — тогда края видны сразу.
С отрицательными числами правило то же, вычитаем со знаком. Если за неделю температура менялась от −4 до 5 °C, размах равен 5 − (−4) = 9 градусов.
О том, что происходит между краями, размах ничего не знает. У ряда 28, 28, 29, 36, 46, 47, 47 он тоже равен 19, хотя значения сгрудились у краёв: стандартное отклонение здесь 9,2 минуты против 6,5 у исходного ряда. А одна задержка — 95 минут вместо 47 — увеличивает размах до 67.
R = x_max − x_minx_max — наибольшее значение ряда, x_min — наименьшее. Результат получается в единицах самих данных.
| Ряд | Размах | Стандартное отклонение | IQR |
|---|---|---|---|
| 28, 31, 35, 36, 40, 42, 47 | 19 | 6,5 | 8 |
| 28, 28, 29, 36, 46, 47, 47 | 19 | 9,2 | 18 |
| 28, 31, 35, 36, 40, 42, 95 | 67 | 23,1 | 8 |
Как посчитать размах в SQL, Python и Excel
Отдельной функции для размаха в PostgreSQL и DuckDB нет: пишут MAX(x) - MIN(x). Посчитаем три величины на учебной базе продукта «Маяк» за полные дни 1–29 августа 2026 года: DAU по дням, выручку по дням и сумму одной оплаты. Данные за 30 августа обрываются в 12:59, поэтому период в запросе закрыт условием < 2026-08-30. Рядом стоят стандартное отклонение и межквартильный размах, о нём ниже.
DAU менялся от 406 до 586 пользователей: размах 180 при стандартном отклонении 44,1. Дневная выручка — от 316 до 771 доллара: размах 455, стандартное отклонение 119,3. У обоих рядов размах примерно вчетверо больше стандартного отклонения (в 4,1 и 3,8 раза).
Третья строка показывает, чем размах бывает бесполезен. Сумма оплаты меняется от 19 до 39 долларов, размах 20. Это расстояние между самым дешёвым и самым дорогим тарифом: в базе всего три цены — 19, 29 и 39. Размах остался бы тем же при любом соотношении тарифов. Он описывает прейскурант и ничего не говорит о плательщиках.
В pandas размах — s.max() - s.min(), в NumPy есть готовая функция np.ptp (peak to peak). В Excel: =МАКС(A2:A30)-МИН(A2:A30).
WITH series AS (
  SELECT 'DAU по дням' AS metric, COUNT(DISTINCT user_id) AS value
  FROM events
  WHERE event_time >= TIMESTAMP '2026-08-01'
    AND event_time <  TIMESTAMP '2026-08-30'
  GROUP BY CAST(event_time AS date)
  UNION ALL
  SELECT 'выручка по дням', SUM(amount)
  FROM payments
  WHERE paid_at >= DATE '2026-08-01' AND paid_at < DATE '2026-08-30'
  GROUP BY paid_at
  UNION ALL
  SELECT 'сумма оплаты', amount
  FROM payments
  WHERE paid_at >= DATE '2026-08-01' AND paid_at < DATE '2026-08-30'
)
SELECT metric, COUNT(*) AS n,
  MIN(value) AS min_value, MAX(value) AS max_value,
  MAX(value) - MIN(value) AS range_value,
  ROUND(CAST(STDDEV_SAMP(value) AS numeric), 1) AS sd,
  PERCENTILE_CONT(0.75) WITHIN GROUP (ORDER BY value)
    - PERCENTILE_CONT(0.25) WITHIN GROUP (ORDER BY value) AS iqr
FROM series
GROUP BY metric
ORDER BY n, metric;
-- дробные нули в выводе опущены
-- DAU по дням       29  406  586  180   44.1   51
-- выручка по дням   29  316  771  455  119.3  137
-- сумма оплаты 613 19 39 20 6.9 10import pandas as pd
df = pd.DataFrame({
"dau": [428, 406, 443, 419, 485, 499, 446, 457, 441, 444, 454, 494, 503, 498, 491,
459, 505, 467, 531, 502, 519, 482, 495, 484, 529, 568, 556, 586, 530],
"revenue": [480, 394, 345, 597, 500, 460, 499, 452, 770, 327, 510, 470, 518, 336, 491,
460, 567, 316, 558, 442, 691, 771, 548, 529, 660, 519, 604, 646, 607],
})
print(pd.DataFrame({
"range": df.max() - df.min(),
"sd": df.std().round(1), # std() делит на n − 1
"iqr": df.quantile(0.75) - df.quantile(0.25),
}))
# range sd iqr
# dau 180 44.1 51.0
# revenue 455 119.3 137.0Что такое межквартильный размах и как его найти
Межквартильный размах (IQR, interquartile range) — это разность третьего и первого квартилей: IQR = Q3 − Q1. Q1 — значение, ниже которого лежит четверть наблюдений, Q3 — значение, ниже которого три четверти. Получается ширина средней половины данных: четверть самых маленьких и четверть самых больших значений в расчёт не попадают.
Для семи доставок Q1 = 33, Q3 = 41, IQR = 8 минут. Заменим последнее значение на 95, как в третьей строке таблицы: IQR остаётся равным 8. Пока значение остаётся крайним, квартилям всё равно, насколько оно далеко.
В SQL квартили считает percentile_cont — так сделано в запросе выше. В pandas это s.quantile(0.75) - s.quantile(0.25), в Excel — =КВАРТИЛЬ.ВКЛ(A2:A30;3)-КВАРТИЛЬ.ВКЛ(A2:A30;1).
У IQR своя ловушка: способов считать квартили несколько. Если искать их как медианы нижней и верхней половин ряда — 28, 31, 35 и 40, 42, 47, — получится Q1 = 31, Q3 = 42 и IQR = 11 вместо 8. На этом ряду тот же ответ даёт КВАРТИЛЬ.ИСКЛ. На 29 августовских днях DAU два способа дают 51 и 62, а на 30 380 паузах из раздела о сравнении групп — одни и те же 99. Сравнивая IQR из разных инструментов, проверьте метод.
На IQR построено правило поиска выбросов: кандидатом считают значение ниже Q1 − 1,5 · IQR или выше Q3 + 1,5 · IQR. В примере границы — 33 − 12 = 21 и 41 + 12 = 53 минуты: доставка за 95 минут за них выходит, за 47 — нет. Правило отбирает строки для проверки и не решает, удалять ли их.
IQR = Q3 − Q1Q1 и Q3 — первый и третий квартили, то есть 25-й и 75-й перцентили.
import numpy as np

x = np.array([28, 31, 35, 36, 40, 42, 47])   # минуты доставки, семь заказов
y = np.array([28, 31, 35, 36, 40, 42, 95])   # одна задержка: 95 вместо 47

for a in (x, y):
    q1, q3 = np.percentile(a, [25, 75])      # как percentile_cont и КВАРТИЛЬ.ВКЛ
    print(np.ptp(a), q1, q3, q3 - q1, round(a.std(ddof=1), 1))
# 19 33.0 41.0 8.0 6.5
# 67 33.0 41.0 8.0 23.1

q1, q3 = np.percentile(x, [25, 75], method="weibull")   # как КВАРТИЛЬ.ИСКЛ
print(q1, q3, q3 - q1)
# 31.0 42.0 11.0Почему один день меняет размах вдвое
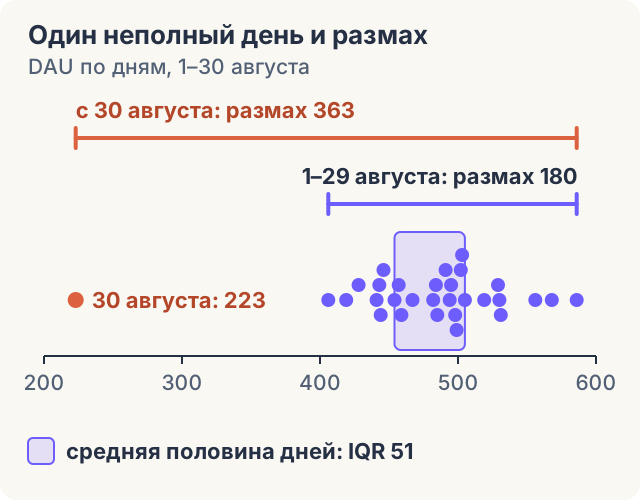
Добавим к 29 дням августа 30-е число. Выгрузка закрыта в 12:59, и за неполный день набралось 223 активных пользователя. Размах DAU вырастает со 180 до 363 — вдвое. Стандартное отклонение — с 44,1 до 64,8, в полтора раза. IQR — с 51 до 56,5, на 11%.
Причина в устройстве показателя: размах определяют ровно два наблюдения. Остальные 27 дней августа можно менять как угодно в пределах от 406 до 586, и число останется прежним. Стоит сдвинуться одному из двух крайних — сдвигается и размах.
Отсюда рабочая привычка: увидев неожиданно большой размах, откройте две строки, которые его задали. Здесь минимум — день, который ещё не закончился. В рабочих выгрузках на этом месте бывают день сбоя трекера или тестовый платёж.
WITH days AS (
  SELECT CAST(event_time AS date) AS day, COUNT(DISTINCT user_id) AS dau
  FROM events
  WHERE event_time >= TIMESTAMP '2026-08-01'
  GROUP BY CAST(event_time AS date)
),
labelled AS (
  SELECT '1–29 августа' AS period, dau FROM days WHERE day < DATE '2026-08-30'
  UNION ALL
  SELECT '1–30 августа' AS period, dau FROM days
)
SELECT period, COUNT(*) AS days,
  MIN(dau) AS min_dau, MAX(dau) AS max_dau,
  MAX(dau) - MIN(dau) AS range_dau,
  ROUND(CAST(STDDEV_SAMP(dau) AS numeric), 1) AS sd,
  PERCENTILE_CONT(0.75) WITHIN GROUP (ORDER BY dau)
    - PERCENTILE_CONT(0.25) WITHIN GROUP (ORDER BY dau) AS iqr
FROM labelled
GROUP BY period
ORDER BY days;
-- 1–29 августа  29  406  586  180  44.1  51
-- 1–30 августа  30  223  586  363  64.8  56.5
Почему размах растёт вместе с объёмом выборки
Новое наблюдение либо попадает между уже известными краями, либо отодвигает один из них. Уменьшить размах оно не может. Поэтому с новыми данными размах может только расти или стоять на месте, даже когда сам процесс не меняется.
Возьмём дневную выручку августа. За четыре семидневки подряд, с 1 по 28 августа, размах составил 252, 443, 375 и 252 доллара, за все 29 дней — 455. Если перебрать все 1 560 780 способов выбрать семь дней из 29, средний размах получится 332 доллара; по всем тройкам дней — 204, по наборам из 14 дней — 415. Месяц один, а ответ на вопрос «каков разброс выручки» зависит от того, сколько дней попало в расчёт.
Чистый опыт — симуляция. Берём нормальное распределение со средним 500 и стандартным отклонением 100 и тянем из него по 5 000 выборок разного объёма. Средний размах: 233 при n = 5, 310 при n = 10, 409 при n = 30, 502 при n = 100 и 649 при n = 1 000. Распределение одно и то же, а размах вырос в 2,8 раза.
Стандартное отклонение в тех же выборках держится около 100 (от 94 до 100). IQR на пяти точках занижен — 99, но начиная с тридцати наблюдений стоит на 129–135. Оба показателя оценивают свойство распределения, и с ростом выборки оценка уточняется. Размах описывает конкретную выборку: у нормального распределения нет значения, к которому он сходился бы. У ограниченной величины, например оценки от 1 до 5, он упирается в края шкалы.
Симуляция из блока выше: нормальное распределение со средним 500 и стандартным отклонением 100, по 5 000 выборок каждого объёма. Шаги по оси неравные: каждый следующий объём в 2–10 раз больше предыдущего.
import numpy as np

rng = np.random.default_rng(42)
for n in (5, 10, 30, 100, 1000):
    x = rng.normal(500, 100, size=(5000, n))     # 5 000 выборок объёма n
    spread = x.max(axis=1) - x.min(axis=1)       # размах каждой выборки
    q1, q3 = np.percentile(x, [25, 75], axis=1)
    sd = x.std(axis=1, ddof=1)
    print(n, round(spread.mean()), round((q3 - q1).mean()), round(sd.mean()))
# 5 233 99 94
# 10 310 117 98
# 30 409 129 99
# 100 502 133 100
# 1000 649 135 100Можно ли сравнивать размах двух групп
При разном числе наблюдений — нельзя, при одинаковом — с осторожностью. Пример — паузы между соседними действиями одного пользователя, в часах, по странам. В России размах пауз — 1 390 часов, в Беларуси — 1 151, в Казахстане — 1 127, в Армении — 1 081. Напрашивается вывод, что российские пользователи пропадают надолго.
Но пауз из России 18 199, а из Армении 3 306 — в 5,5 раза меньше. Межквартильный размах во всех четырёх странах одинаковый, 99 часов. Чтобы уравнять объём, разделим российских пользователей на шесть частей по остатку от деления user_id на 6: в каждой окажется около трёх тысяч пауз, как в Армении и Беларуси.
Размах в шести частях — 1 106, 1 035, 1 009, 1 080, 1 390 и 1 273 часа. Значения остальных стран, от 1 081 до 1 151, лежат внутри этого разброса. Шесть равных частей одной страны разошлись на 381 час — сильнее, чем страны между собой: даже при равном объёме размах слишком шумный для сравнения. Различие между странами из размаха не следует: рекордная пауза чаще достаётся группе, в которой больше наблюдений.
У пауз есть и потолок, заданный самой базой: события каждого пользователя записаны меньше чем за 60 дней после регистрации, поэтому пауза длиннее 1 440 часов невозможна. Группы разного объёма сравнивают по IQR, стандартному отклонению или высоким перцентилям (P95 — значение, ниже которого лежат 95% наблюдений).
WITH gaps AS (
  SELECT u.country,
    EXTRACT(epoch FROM e.event_time - LAG(e.event_time) OVER (
      PARTITION BY e.user_id ORDER BY e.event_time
    )) / 3600 AS gap_hours
  FROM events e
  JOIN users u ON u.user_id = e.user_id
)
SELECT country, COUNT(gap_hours) AS gaps,
  ROUND(CAST(MAX(gap_hours) - MIN(gap_hours) AS numeric), 1) AS range_h,
  ROUND(CAST(PERCENTILE_CONT(0.75) WITHIN GROUP (ORDER BY gap_hours)
    - PERCENTILE_CONT(0.25) WITHIN GROUP (ORDER BY gap_hours) AS numeric), 1) AS iqr_h
FROM gaps
WHERE country IS NOT NULL
GROUP BY country
ORDER BY gaps DESC;
-- RU  18199  1390.4  99.0
-- KZ   6019  1127.4  99.0
-- AM   3306  1081.4  99.0
-- BY 2856 1151.4 99.0WITH gaps AS (
SELECT e.user_id,
EXTRACT(epoch FROM e.event_time - LAG(e.event_time) OVER (
PARTITION BY e.user_id ORDER BY e.event_time
)) / 3600 AS gap_hours
FROM events e
JOIN users u ON u.user_id = e.user_id
WHERE u.country = 'RU'
)
SELECT user_id % 6 AS part, COUNT(gap_hours) AS gaps,
ROUND(CAST(MAX(gap_hours) - MIN(gap_hours) AS numeric), 1) AS range_h,
ROUND(CAST(PERCENTILE_CONT(0.75) WITHIN GROUP (ORDER BY gap_hours)
- PERCENTILE_CONT(0.25) WITHIN GROUP (ORDER BY gap_hours) AS numeric), 1) AS iqr_h
FROM gaps
GROUP BY user_id % 6
ORDER BY part;
-- 0 2969 1106.4 98.0
-- 1 2815 1035.4 99.0
-- 2 3020 1009.4 97.6
-- 3 3133 1080.4 99.0
-- 4 3211 1390.4 99.0
-- 5 3051 1272.8 98.0Что показывает размах на растущем ряду
За 90 полных дней выгрузки, с 1 июня по 29 августа, DAU менялся от 32 до 586: размах 554. Минимум пришёлся на первый день, максимум — на 28 августа. Это число измеряет рост аудитории за квартал; о колебаниях от дня к дню оно ничего не говорит.
По месяцам размах меньше: 217 в июне, 223 в июле, 180 в августе. Но и внутри августа края стоят в разных концах месяца: минимум — 2 августа, максимум — 28-го. DAU прибавлял в среднем 4,2 пользователя в день. Если вычесть эту прямую и посчитать размах остатков, получится 91,1 — вдвое меньше исходных 180.
С выручкой иначе: размах остатков даже вырос, 508 против 455. Тренд у неё слабый, а крайние дни — 316 долларов 18 августа и 770 долларов 9 августа — с ростом не связаны: вычитание прямой только раздвинуло их.
Правило такое: на ряду с трендом размах отвечает на вопрос «насколько выросли». Для вопроса «насколько шумит» его считают по остаткам от тренда или на коротком окне.
WITH days AS (
  SELECT CAST(event_time AS date) AS day, COUNT(DISTINCT user_id) AS dau
  FROM events
  WHERE event_time >= TIMESTAMP '2026-08-01'
    AND event_time <  TIMESTAMP '2026-08-30'
  GROUP BY CAST(event_time AS date)
),
numbered AS (
  SELECT dau, ROW_NUMBER() OVER (ORDER BY day) AS t
  FROM days
),
fit AS (
  SELECT REGR_SLOPE(dau, t) AS slope, REGR_INTERCEPT(dau, t) AS intercept
  FROM numbered
)
SELECT
  MAX(dau) - MIN(dau) AS range_raw,
  ROUND(CAST(MAX(slope) AS numeric), 1) AS growth_per_day,
  ROUND(CAST(MAX(dau - (intercept + slope * t))
           - MIN(dau - (intercept + slope * t)) AS numeric), 1) AS range_detrended
FROM numbered
CROSS JOIN fit;
-- 180 4.2 91.1Где размах полезен: проверка данных и диапазон в отчёте
Первое применение — проверка выгрузки. Минимум и максимум по ключевым столбцам занимают один запрос и ловят ошибки до того, как они попадут в расчёт.
В учебной базе четыре строки сообщают три вещи. События заканчиваются 30 августа в 12:59 — последний день неполный. Регистрации обрываются 29 августа, а оплаты записаны по 30-е: таблицы закрыты в разные моменты, и ряд по дням нужно обрезать по самой короткой. Суммы оплат лежат между 19 и 39 долларами: нет нулей, отрицательных значений и платежа на 1 900, который выдал бы центы вместо долларов.
Размах дат тоже полезен: между первой и последней регистрацией 89 дней, то есть в таблице регистраций 90 календарных дней.
Второе применение — диапазон в отчёте. «Оплаты от 19 до 39 долларов» или «доставка за 28–47 минут» читателю понятнее одного числа: видны и уровень, и ширина. Только обещание клиенту на максимуме не строят: «доставим за 47 минут» по семи заказам продержится до первой задержки. Для обещаний берут перцентили.
SELECT 'users.signup_date' AS field,
  CAST(MIN(signup_date) AS varchar) AS min_value,
  CAST(MAX(signup_date) AS varchar) AS max_value,
  COUNT(*) AS row_count
FROM users
UNION ALL
SELECT 'events.event_time',
  CAST(MIN(event_time) AS varchar), CAST(MAX(event_time) AS varchar), COUNT(*)
FROM events
UNION ALL
SELECT 'payments.paid_at',
  CAST(MIN(paid_at) AS varchar), CAST(MAX(paid_at) AS varchar), COUNT(*)
FROM payments
UNION ALL
SELECT 'payments.amount',
  CAST(MIN(amount) AS varchar), CAST(MAX(amount) AS varchar), COUNT(*)
FROM payments
ORDER BY field;
-- events.event_time  2026-06-01 08:38:00  2026-08-30 12:59:00  35341
-- payments.amount    19.00                39.00                 1251
-- payments.paid_at   2026-06-06           2026-08-30            1251
-- users.signup_date  2026-06-01           2026-08-29            4613
Как размах используют в контрольных картах
В контроле качества размах — рабочий инструмент. Контрольные карты Шухарта следят за процессом по небольшим подгруппам измерений: для каждой считают среднее и размах R. Правила описаны в ГОСТ Р ИСО 7870-2-2015.
На карте размахов (R-карте) центральная линия — средний размах подгрупп R̄, верхняя контрольная граница — D4 · R̄, нижняя — D3 · R̄. По размаху оценивают и стандартное отклонение процесса: σ ≈ R̄ / d2. Коэффициенты зависят от объёма подгруппы; прочерк в столбце D3 означает, что нижняя граница равна нулю. d2 — это средний размах выборки из n нормально распределённых значений в единицах σ. Для n = 5 он равен 2,326 — те самые 233 из симуляции выше.
По стандарту подгруппа часто состоит из 4 или 5 измерений, а при десяти и больше предпочтительнее карта стандартных отклонений: на больших подгруппах размах оценивает разброс хуже.
Пример на учебной базе: регистрации в будни, подгруппа — рабочая неделя из пяти дней, всего 13 недель с 1 июня по 28 августа. В двенадцати неделях размах равен 2–3 регистрациям, в неделе 13–17 июля — 41: на 15 и 16 июля в учебной базе заложен всплеск — два дня кампании: 99 и 100 регистраций при обычных 59–61. Сумма размахов — 73, R̄ = 73 / 13 ≈ 5,62, верхняя граница — 2,114 · 73 / 13 ≈ 11,87. Неделя кампании выходит за границу, остальные — нет.
За квартал средний уровень вырос с 33 до 87 регистраций в будний день, а размах внутри недели остался прежним. R-карта следит только за разбросом внутри подгруппы и роста не видит. Его показывает парная карта средних: на ней за границами 58,0–64,5 лежат 12 недель из 13.
Оговорки. Стандарт советует не менее 25 предварительных подгрупп, здесь их 13. Учебные регистрации заданы формулой без случайной части: размах 2–3 внутри недели — это недельный прирост, а не шум, так что пример показывает только механику расчёта. Коэффициенты выведены для нормально распределённых независимых измерений в однородных условиях; дневной ряд с ростом этому не отвечает. Подгруппу, у выброса которой нашлась причина, стандарт предписывает исключить и пересчитать границы: без недели кампании R̄ = 2,67, граница — 5,64.
| Объём подгруппы n | d2 | D3 | D4 |
|---|---|---|---|
| 2 | 1,128 | — | 3,267 |
| 3 | 1,693 | — | 2,575 |
| 4 | 2,059 | — | 2,282 |
| 5 | 2,326 | — | 2,114 |
| 7 | 2,704 | 0,076 | 1,924 |
| 10 | 3,078 | 0,223 | 1,777 |
WITH daily AS (
  SELECT signup_date AS day, COUNT(*) AS signups
  FROM users
  GROUP BY signup_date
),
weekly AS (
  SELECT CAST(date_trunc('week', day) AS date) AS week_start,
    MIN(signups) AS min_signups, MAX(signups) AS max_signups,
    MAX(signups) - MIN(signups) AS r
  FROM daily
  WHERE EXTRACT(isodow FROM day) < 6
  GROUP BY CAST(date_trunc('week', day) AS date)
),
limits AS (
  SELECT COUNT(*) AS weeks, AVG(r) AS r_bar, 2.114 * AVG(r) AS ucl
  FROM weekly
)
SELECT week_start, min_signups, max_signups, r,
  weeks, ROUND(r_bar, 2) AS r_bar, ROUND(ucl, 2) AS ucl,
  CASE WHEN r > ucl THEN 'выше границы' ELSE 'в пределах' END AS verdict
FROM weekly
CROSS JOIN limits
ORDER BY r DESC, week_start
LIMIT 3;
-- 2026-07-13  59  100  41  13  5.62  11.87  выше границы
-- 2026-06-01  32   35   3  13  5.62  11.87  в пределах
-- 2026-06-15  41   44   3  13  5.62  11.87  в пределах
Частые вопросы
Как найти размах ряда чисел, если числа идут не по порядку? Порядок не важен: найдите наибольшее и наименьшее значение и вычтите второе из первого. Для ряда 3, 8, 15, 4, 10 это 15 − 3 = 12.
Может ли размах быть отрицательным или равным нулю? Отрицательным — нет: из большего вычитают меньшее. Нулю он равен, когда все значения в ряду одинаковы.
Чем размах отличается от стандартного отклонения? Размах использует два крайних значения, стандартное отклонение — все. У DAU за август это 180 и 44,1.
Что больше: размах или межквартильный размах? Размах не меньше межквартильного: средняя половина данных лежит внутри полного диапазона. У DAU за август это 180 против 51.
Размах и диапазон — это одно и то же? Диапазоном обычно называют сами границы, «от 406 до 586», размахом — расстояние между ними, 180.
Что попробовать на учебной базе
Запросы из статьи выполняются в песочнице симулятора SQL-аналитика: база там та же. Для начала посчитайте размах дневных регистраций за 1–29 августа трижды: по всем дням, только по будням и только по выходным. Должно получиться 60 (от 28 до 88), 16 (от 72 до 88) и 10 (от 28 до 38). Объясните, что именно измеряет число 60, если ни в будни, ни в выходные регистрации не гуляют шире 16.
Материалы по теме
Математическое ожидание: что это, формула и примеры
Математическое ожидание простыми словами: среднее, к которому результат сходится в долгую. Формула, пример на кубике, расчёт в SQL и Python, свойства и ловушки.
Коэффициент вариации: формула, расчёт и как читать
Коэффициент вариации — стандартное отклонение в процентах от среднего. Формула, пример на пяти числах, расчёт в SQL, Python и Excel, порог 33% для НМЦК и ловушки.
Линейная регрессия простыми словами: уравнение, наклон и R²
Что такое регрессия и линейная регрессия: уравнение y = a + b·x, наклон, свободный член и R². Пример на пяти точках, расчёт в SQL, Python и Excel, остатки, прогноз и ловушки.