Метод наименьших квадратов (МНК): суть, формулы и пример расчёта
Метод наименьших квадратов простыми словами: что минимизирует МНК, формулы наклона и свободного члена, нормальные уравнения, пример на пяти точках, SQL, Python и Excel.
Содержание статьи
Метод наименьших квадратов (МНК) подбирает параметры модели так, чтобы сумма квадратов остатков — разниц между фактом и моделью — была минимальной. Для прямой ŷ = a + b·x у задачи есть готовый ответ: b = Σ(x − x̄)(y − ȳ) / Σ(x − x̄)², a = ȳ − b·x̄. Тот же результат возвращают regr_slope в SQL, polyfit в Python и НАКЛОН в Excel. Ниже — почему метод выбирает именно эту прямую, откуда берутся формулы и когда ответу нельзя верить: на пяти точках, которые легко пересчитать руками, и на учебной базе сервиса с выручкой за 90 дней.
Что такое метод наименьших квадратов простыми словами
Есть облако точек и желание описать его прямой. Провести её можно как угодно, поэтому нужен критерий, какая прямая лучше. МНК предлагает такой: у каждой точки взять остаток — отклонение точки от прямой по вертикали, факт минус значение на прямой: e = y − ŷ, — возвести в квадрат и всё сложить. Лучшая прямая — та, у которой эта сумма наименьшая.
Пример на всю статью — пять недель рекламы: бюджет 10, 20, 30, 40 и 50 тысяч рублей, регистраций — 30, 50, 40, 70 и 60. Те же точки — в статье о линейной регрессии, где разобрано, как читать готовое уравнение. Прямая МНК для них — ŷ = 26 + 0,8·x. Остатки равны −4, 8, −10, 12 и −6, их квадраты — 16, 64, 100, 144 и 36, сумма — 360.
Название метода видно на схеме: на каждом промахе построен квадрат со стороной в остаток, и метод делает общую площадь наименьшей. Знак при возведении в квадрат пропадает, поэтому промахи вверх и вниз друг друга не гасят.
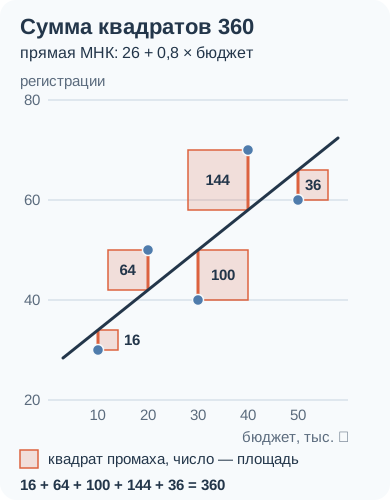
S(a, b) = Σ(y − a − b·x)² → minS — сумма квадратов остатков по всем наблюдениям (SSE или RSS). В примере S(26; 0,8) = 360.
Формулы МНК: как найти наклон и свободный член
Для прямой минимум находится без перебора. Наклон b — сумма произведений отклонений x и y от своих средних, делённая на сумму квадратов отклонений x. Свободный член a подбирают так, чтобы прямая прошла через точку средних (x̄; ȳ).
В примере средний бюджет равен 30, среднее число регистраций — 50. Произведения отклонений по неделям — 400, 0, 0, 200 и 200, в сумме 800. Квадраты отклонений бюджета — 400, 100, 0, 100 и 400, в сумме 1 000. Наклон b = 800 / 1 000 = 0,8, свободный член a = 50 − 0,8 · 30 = 26.
Если числитель и знаменатель разделить на n − 1, получатся ковариация x и y и дисперсия x, так что наклон равен cov(x, y) / var(x). Отсюда видно, когда метод не сработает: если все x одинаковы, знаменатель равен нулю и наклон не определён.
b = Σ(x − x̄)(y − ȳ) / Σ(x − x̄)²; a = ȳ − b·x̄x̄ и ȳ — средние значения x и y.
SELECT
  regr_slope(y, x) AS b,
  regr_intercept(y, x) AS a,
  regr_sxy(y, x) AS sum_xy_deviations,
  regr_sxx(y, x) AS sum_xx_deviations
FROM (VALUES (10, 30), (20, 50), (30, 40), (40, 70), (50, 60)) AS t(x, y);
Откуда берутся формулы: нормальные уравнения
Сумма квадратов S(a, b) зависит от двух чисел. Над плоскостью (a, b) она выглядит как чаша: в одной точке дно, во все стороны — подъём. На дне чаша никуда не наклонена, то есть обе частные производные — наклон чаши, если менять только a или только b, — равны нулю.
Производная по a даёт условие Σ(y − a − b·x) = 0: сумма остатков равна нулю. Производная по b — условие Σx·(y − a − b·x) = 0: остатки, умноженные на x, тоже в сумме дают ноль. Раскрыв скобки, получаем два линейных уравнения с двумя неизвестными — нормальные уравнения.
Для пяти точек нужны четыре суммы: Σx = 150, Σy = 250, Σxy = 8 300, Σx² = 5 500. Уравнения: 5a + 150b = 250 и 150a + 5 500b = 8 300. Из первого a = 50 − 30b. Подставляем во второе: 7 500 − 4 500b + 5 500b = 8 300, откуда 1 000b = 800. Вышли те же b = 0,8 и a = 26: формулы из предыдущего раздела — решение этой системы в общем виде.
Оба условия видны на остатках: их сумма, −4 + 8 − 10 + 12 − 6, равна нулю, и сумма остатков, умноженных на x, тоже. Первое означает, что прямая проходит через точку средних, второе — что в остатках не осталось линейной связи с x.
n·a + b·Σx = Σy; a·Σx + b·Σx² = ΣxyПолучаются из условий ∂S/∂a = 0 и ∂S/∂b = 0.
Почему любая другая прямая хуже: проверка перебором
Производные нашли точку, где чаша не наклонена. Убедимся, что это дно: посчитаем сумму квадратов для нескольких разумных на вид прямых. Более крутая и более пологая прямые через ту же точку средних дают по 370, прямая на глаз через первую и последнюю точки — 487,5, горизонталь на уровне среднего — 1 000.
Перебор кодом говорит то же. На сетке из 4 961 прямой (a от 0 до 60 с шагом 0,5, b от 0 до 2 с шагом 0,05) наименьшая сумма, 360, — у пары a = 26, b = 0,8; следующая за ней — 361,25.
За этим стоит алгебра. Если изменить свободный член на Δa и наклон на Δb, сумма квадратов вырастет на n·(Δa + x̄·Δb)² + Σ(x − x̄)²·Δb². Оба слагаемых — квадраты и меньше нуля не бывают. Для пяти точек прибавка равна 5·(Δa + 30·Δb)² + 1 000·Δb²: у прямой 23 + 0,9x это 10, у поднятой на 4 — 80.
| Прямая | Как выбрана | Сумма квадратов | Сумма модулей |
|---|---|---|---|
| 26 + 0,8x | МНК | 360 | 40 |
| 23 + 0,9x | круче, через точку средних | 370 | 40 |
| 29 + 0,7x | положе, через точку средних | 370 | 40 |
| 20 + 1,0x | ещё круче, через точку средних | 400 | 40 |
| 30 + 0,8x | прямая МНК, поднятая на 4 | 440 | 44 |
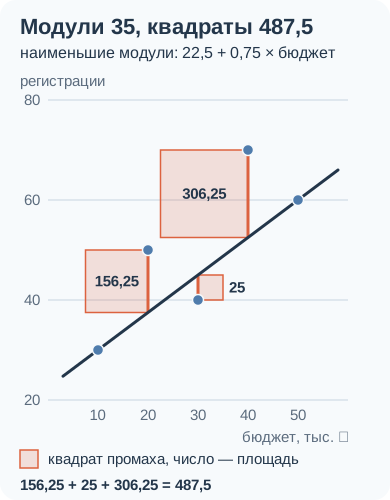
| 22,5 + 0,75x | через первую и последнюю точки | 487,5 | 35 |
| 50 + 0x | горизонталь на уровне среднего | 1 000 | 60 |
import numpy as np

x = np.array([10, 20, 30, 40, 50])      # бюджет, тысяч рублей
y = np.array([30, 50, 40, 70, 60])      # регистрации

def sse(a, b):                          # сумма квадратов остатков
    return float(((y - (a + b * x)) ** 2).sum())

def sae(a, b):                          # сумма модулей остатков
    return float(np.abs(y - (a + b * x)).sum())

# 1. Нормальные уравнения: два уравнения, две неизвестные
A = np.array([[len(x), x.sum()], [x.sum(), (x ** 2).sum()]])
rhs = np.array([y.sum(), (x * y).sum()])
a, b = np.linalg.solve(A, rhs)
print(A.tolist(), rhs.tolist())                   # [[5, 150], [150, 5500]] [250, 8300]
print(round(a, 2), round(b, 2), round(sse(a, b), 2))   # 26.0 0.8 360.0

# 2. Перебор по сетке: a = 0, 0.5, …, 60 и b = 0, 0.05, …, 2
grid = sorted((round(sse(i / 2, j / 20), 2), i / 2, j / 20)
              for i in range(121) for j in range(41))
print(len(grid), grid[0], grid[1][0])             # 4961 (360.0, 26.0, 0.8) 361.25

# 3. Прямые из таблицы
for a_, b_ in [(23, 0.9), (29, 0.7), (20, 1.0), (30, 0.8), (22.5, 0.75), (50, 0)]:
    print(a_, b_, round(sse(a_, b_), 2), round(sae(a_, b_), 2))
# 23 0.9 370.0 40.0
# 29 0.7 370.0 40.0
# 20 1.0 400.0 40.0
# 30 0.8 440.0 44.0
# 22.5 0.75 487.5 35.0
# 50 0 1000.0 60.0
Почему квадраты, а не модули остатков
Возводить остатки в квадрат не обязательно: можно складывать их модули и искать прямую с наименьшей суммой. Это метод наименьших модулей, по-английски LAD (least absolute deviations). По таблице выше он выбрал бы другую прямую: у 22,5 + 0,75x сумма модулей 35 против 40 у прямой МНК. Она проходит точно через первую и последнюю точки и мирится с промахами 12,5 и 17,5 на второй и четвёртой.
Разница в цене крупного промаха. Для модулей остаток 12 — то же, что двенадцать остатков по единице, для квадратов — сто сорок четыре. МНК согласен немного ошибиться везде, лишь бы нигде не ошибиться сильно. Так же расходятся ответы в задаче без x: сумму квадратов отклонений минимизирует среднее, сумму модулей — медиана.
У квадратов практическое преимущество: их сумма — гладкая чаша с единственным дном, поэтому есть формула. У суммы модулей изломы и плоские участки: в таблице четыре разные прямые дают одни и те же 40, а лучшую приходится искать перебором или линейным программированием.
Плата за квадраты — чувствительность к выбросам. В учебной базе 30 августа события есть только до 13:00, а оплаты записаны за весь день, поэтому DAU — число пользователей хотя бы с одним событием за день — равен 223 при выручке 721 доллар. Линия по 90 закрытым дням, выручка = −52,12 + 1,171 · DAU, ждёт при таком DAU 209 долларов. Промах 512 — это 5,4 стандартного отклонения остатков. Если мерить все 91 день от этой линии, один этот день даёт 25,1% суммы квадратов остатков и только 7,6% суммы модулей.
Прямая МНК на эту точку откликается: наклон меняется с 1,171 на 1,143. У прямой наименьших модулей сдвиг примерно вдвое меньше — с 1,210 до 1,196.
Лекарством от выбросов модули считать не стоит. В одном августе 30-е число стоит далеко от остальных дней по оси x, 223 против 406–586, и тянет за собой обе прямые: наклон МНК падает с 0,942 до −0,002, наименьших модулей — с 1,400 до 0,757. Такую точку называют рычагом; заменой квадратов на модули её не обезвредить, помогает проверка данных до расчёта.
import numpy as np
from itertools import combinations

# DAU и выручка по дням с 1 июня; последний элемент — неполное 30 августа
dau = np.array([
    32, 53, 76, 85, 104, 86, 76, 97, 105, 129, 141, 139, 132, 119, 146,
    154, 172, 180, 204, 185, 173, 198, 210, 233, 234, 249, 215, 203, 234, 240,
    285, 287, 297, 275, 257, 260, 283, 296, 292, 330, 286, 259, 323, 335, 374,
    418, 401, 354, 335, 383, 376, 389, 432, 385, 381, 381, 374, 427, 431, 454,
    480, 428, 406, 443, 419, 485, 499, 446, 457, 441, 444, 454, 494, 503, 498,
    491, 459, 505, 467, 531, 502, 519, 482, 495, 484, 529, 568, 556, 586, 530,
    223,
])
revenue = np.array([
    0, 0, 0, 0, 0, 48, 19, 77, 0, 58, 0, 105, 163, 145, 96,
    192, 212, 115, 172, 57, 258, 240, 221, 231, 212, 306, 174, 210, 297, 375,
    212, 307, 347, 182, 86, 424, 259, 193, 337, 365, 222, 298, 326, 395, 153,
    308, 268, 405, 509, 289, 403, 441, 481, 327, 346, 487, 394, 632, 471, 626,
    375, 480, 394, 345, 597, 500, 460, 499, 452, 770, 327, 510, 470, 518, 336,
    491, 460, 567, 316, 558, 442, 691, 771, 548, 529, 660, 519, 604, 646, 607,
    721,
])

def ols(x, y):                            # метод наименьших квадратов
    b, a = np.polyfit(x, y, 1)
    return a, b

def lad(x, y):                            # метод наименьших модулей
    # среди лучших прямых всегда есть проходящая через две точки: перебираем пары
    best = None
    for i, j in combinations(range(len(x)), 2):
        if x[i] == x[j]:
            continue
        b = (y[j] - y[i]) / (x[j] - x[i])
        a = y[i] - b * x[i]
        total = np.abs(y - (a + b * x)).sum()
        if best is None or total < best[0]:
            best = (total, a, b)
    return best[1], best[2]

for name, method in (('МНК', ols), ('модули', lad)):
    a90, b90 = method(dau[:-1], revenue[:-1])
    a91, b91 = method(dau, revenue)
    print(name, round(a90, 2), round(b90, 3), '->', round(a91, 2), round(b91, 3))
# МНК -52.12 1.171 -> -37.55 1.143
# модули -63.23 1.21 -> -54.86 1.196

a, b = ols(dau[:-1], revenue[:-1])
res = revenue - (a + b * dau)             # остатки всех дней от линии по 90 дням
share_squares = res[-1] ** 2 / (res ** 2).sum() * 100
share_abs = abs(res[-1]) / np.abs(res).sum() * 100
print(round(res[-1]), round(share_squares, 1), round(share_abs, 1)) # 512 25.1 7.6МНК для нескольких факторов: матричная форма
С несколькими факторами уравнений становится больше, и их записывают матрицами. Наблюдения y собирают в столбец, факторы — в матрицу X: строка на наблюдение, столбец на фактор и столбец из единиц для свободного члена. Модель — y = Xβ + e.
Условие «производные равны нулю» превращается в систему XᵀXβ = Xᵀy: те же нормальные уравнения, по одному на параметр. Xᵀ — та же матрица, повёрнутая набок: строки стали столбцами. Её решение — β = (XᵀX)⁻¹Xᵀy. Для прямой в матрице XᵀX стоят знакомые n, Σx и Σx².
Пример на учебной базе. Выручка по дням связана и с DAU, и с номером дня: оба ряда растут весь квартал. Матрица X — 90 строк и три столбца: единицы, DAU, номер дня. Результат: выручка = 1,573 + 0,357 · DAU + 4,692 · день. Наклон по DAU упал с 1,171 до 0,357 — в статье о регрессии то же число получено вычитанием тренда.
На практике обратную матрицу не считают: numpy.linalg.lstsq решает задачу через разложение самой матрицы X, так меньше накапливаются ошибки округления. Здесь до них далеко — оба способа в коде совпали. Тесная связь факторов бьёт по статистической точности: корреляция DAU и номера дня равна 0,981, и стандартная ошибка наклона по DAU выросла впятеро, с 0,068 до 0,336. 95%-й интервал наклона 0,357 — от −0,31 до 1,02: МНК делит выручку между двумя почти одинаковыми факторами неуверенно.
β = (XᵀX)⁻¹XᵀyX — матрица факторов со столбцом единиц, y — столбец наблюдений, β — столбец коэффициентов.
import numpy as np

# DAU и выручка по дням, 1 июня – 29 августа 2026 (90 закрытых дней)
dau = np.array([
    32, 53, 76, 85, 104, 86, 76, 97, 105, 129, 141, 139, 132, 119, 146,
    154, 172, 180, 204, 185, 173, 198, 210, 233, 234, 249, 215, 203, 234, 240,
    285, 287, 297, 275, 257, 260, 283, 296, 292, 330, 286, 259, 323, 335, 374,
    418, 401, 354, 335, 383, 376, 389, 432, 385, 381, 381, 374, 427, 431, 454,
    480, 428, 406, 443, 419, 485, 499, 446, 457, 441, 444, 454, 494, 503, 498,
    491, 459, 505, 467, 531, 502, 519, 482, 495, 484, 529, 568, 556, 586, 530,
])
revenue = np.array([
    0, 0, 0, 0, 0, 48, 19, 77, 0, 58, 0, 105, 163, 145, 96,
    192, 212, 115, 172, 57, 258, 240, 221, 231, 212, 306, 174, 210, 297, 375,
    212, 307, 347, 182, 86, 424, 259, 193, 337, 365, 222, 298, 326, 395, 153,
    308, 268, 405, 509, 289, 403, 441, 481, 327, 346, 487, 394, 632, 471, 626,
    375, 480, 394, 345, 597, 500, 460, 499, 452, 770, 327, 510, 470, 518, 336,
    491, 460, 567, 316, 558, 442, 691, 771, 548, 529, 660, 519, 604, 646, 607,
])
day = np.arange(1, 91)                                   # номер дня: 1 — это 1 июня

# 1. Выручка по DAU и номеру дня: столбцы X — единицы, DAU, день
X = np.column_stack([np.ones(90), dau, day])
beta = np.linalg.solve(X.T @ X, X.T @ revenue)           # нормальные уравнения
beta_lstsq, *_ = np.linalg.lstsq(X, revenue, rcond=None) # то же без XᵀX
print(np.round(beta, 3), np.round(beta_lstsq, 3))        # [1.573 0.357 4.692] [1.573 0.357 4.692]
print(round(np.corrcoef(dau, day)[0, 1], 3))             # 0.981

# 2. Парабола DAU по номеру дня: столбцы — единицы, t, t²
T = np.column_stack([np.ones(90), day, day ** 2])
c, *_ = np.linalg.lstsq(T, dau, rcond=None)
line = np.polyfit(day, dau, 1)
res_line = dau - np.polyval(line, day)
res_parabola = dau - T @ c
print([round(float(v), 4) for v in c])                   # [40.56, 7.8634, -0.0254]
print(round((res_line ** 2).sum()), round((res_parabola ** 2).sum()))   # 74443 53219
print(np.round(res_parabola.reshape(9, 10).mean(axis=1), 1))
# [ 1.5  1.1 -5.4 -1.2  1.3  4.6  4.2 -4.4 -1.6]

peak = -c[1] / (2 * c[2])                                # вершина параболы
print(round(peak, 1), round(c @ [1, peak, peak ** 2]))   # 154.5 648
print(round(np.polyval(line, 180)), round(c @ [1, 180, 180 ** 2]))      # 1075 632
МНК не только для прямой: парабола и логарифм
Слово «линейный» в названии «линейный МНК» относится к параметрам: кривая может быть не прямой, лишь бы параметры входили в неё в первой степени. Парабола y = c₀ + c₁·t + c₂·t² — кривая, но c₀, c₁ и c₂ входят в неё в первой степени. Достаточно добавить в матрицу X столбец t², и формула работает без изменений. С логарифмом так же: вместо столбца t берут столбец ln t.
Проверим на тренде DAU по номеру дня. Прямая даёт наклон 5,55 и R² = 0,962 (R² — доля разброса, которую описывает модель), но её остатки идут дугой: на краях квартала она завышает DAU на 22–25 человек. Парабола 40,56 + 7,863·t − 0,0254·t² дугу убирает: средний остаток по десятидневкам не выходит за ±5,4, сумма квадратов остатков падает с 74 443 до 53 219, на 29%, R² растёт до 0,973.
Подходящую форму ещё нужно угадать. Корень из номера дня даёт тот же R² = 0,962, что и прямая, логарифм — 0,843: он загибается слишком резко. Модели с одним преобразованным столбцом — корнем или логарифмом — в SQL считают те же функции regr_*; для параболы нужны уже два столбца и матричная формула.
Ловушка параболы — за краем данных. У неё есть вершина: по этой подгонке DAU достигнет максимума 648 на 155-й день и пойдёт вниз. На 180-й день парабола обещает 632, прямая — 1 075. Внутри 90 дней парабола описывает данные лучше, но разворот вниз — свойство формулы: в данных его нет.
Выше нуля — факт больше модели. У прямой остатки идут дугой, у параболы держатся около нуля.
WITH daily AS (
  SELECT
    CAST(event_time AS date) - DATE '2026-06-01' + 1 AS day_no,
    count(DISTINCT user_id) AS dau
  FROM events
  WHERE event_time < TIMESTAMP '2026-08-30 00:00:00'
  GROUP BY 1
)
SELECT
  round(CAST(regr_r2(dau, day_no) AS numeric), 3) AS r2_line,
  round(CAST(regr_r2(dau, sqrt(day_no)) AS numeric), 3) AS r2_sqrt,
  round(CAST(regr_r2(dau, ln(day_no)) AS numeric), 3) AS r2_ln
FROM daily;
Когда оценкам МНК можно доверять: условия Гаусса — Маркова
Минимизировать сумму квадратов можно на любых данных. Насколько хороши при этом коэффициенты как оценки настоящей связи, говорит теорема Гаусса — Маркова. Пусть модель линейна по параметрам, а её ошибки — то, что модель не объясняет, — имеют нулевое среднее при любых значениях факторов, одинаковый разброс и не связаны между собой. Тогда оценки МНК несмещённые, то есть в среднем попадают в истинные значения, и самые точные среди всех несмещённых оценок, линейных по y: у них наименьшая дисперсия. Ошибок мы не видим — о них судят по остаткам, и только если форма модели верна. Ещё одно условие — факторы не должны точно выражаться друг через друга, иначе система уравнений не решается.
Нормального распределения ошибок теорема не требует. И обещает она немного — лучший результат только среди линейных несмещённых оценок: при тяжёлых выбросах оценка другого типа, например наименьшие модули, может оказаться точнее.
На учебной базе у каждого из трёх условий находится нарушение. Одинаковый разброс: остатки линии «выручка по DAU» расходятся веером, стандартное отклонение — 47 долларов при DAU до 150 и 100–120 при DAU от 300. Коэффициенты от этого не смещаются, но наименьшую дисперсию теорема им уже не обещает, а стандартная ошибка наклона по обычной формуле перестаёт быть надёжной.
Несвязанные ошибки: в рядах по дням соседние остатки бывают похожи. У тренда DAU корреляция остатка с остатком предыдущего дня равна 0,52. Часть её создаёт сама дуга, но и у параболы остаётся 0,35 — заметно выше шума (для 89 пар порог около 0,21). У линии «выручка по DAU» связь близка к нулю, −0,08. При связанных остатках 90 дней несут меньше сведений, чем 90 независимых наблюдений, и обычные интервалы и p-value выходят слишком уверенными.
Нулевое среднее ошибок ломается, когда неверна форма модели или пропущен фактор, связанный с x. Дуга в остатках тренда — первый случай. Наклон 1,171, который падает до 0,357, стоит добавить номер дня, — второй: общий рост остался в ошибках, и коэффициент при DAU вобрал его в себя. Такое смещение не лечится ни объёмом данных, ни другим критерием.
WITH daily AS (
  SELECT d.day, d.dau, COALESCE(r.revenue, 0) AS revenue
  FROM (SELECT CAST(event_time AS date) AS day, count(DISTINCT user_id) AS dau
        FROM events GROUP BY 1) AS d
  LEFT JOIN (SELECT paid_at AS day, sum(amount) AS revenue
             FROM payments GROUP BY 1) AS r ON r.day = d.day
),
closed AS (
  SELECT day, day - DATE '2026-06-01' + 1 AS day_no, dau, revenue
  FROM daily
  WHERE day < DATE '2026-08-30'
),
model AS (
  SELECT
    regr_slope(dau, day_no) AS trend_b, regr_intercept(dau, day_no) AS trend_a,
    regr_slope(revenue, dau) AS money_b, regr_intercept(revenue, dau) AS money_a
  FROM closed
),
residuals AS (
  SELECT
    day,
    dau - (trend_a + trend_b * day_no) AS trend_res,
    revenue - (money_a + money_b * dau) AS money_res
  FROM closed CROSS JOIN model
),
pairs AS (
  SELECT
    trend_res, lag(trend_res) OVER (ORDER BY day) AS trend_prev,
    money_res, lag(money_res) OVER (ORDER BY day) AS money_prev
  FROM residuals
)
SELECT
  regr_count(trend_res, trend_prev) AS pairs,
  round(CAST(corr(trend_res, trend_prev) AS numeric), 2) AS dau_by_day,
  round(CAST(corr(money_res, money_prev) AS numeric), 2) AS revenue_by_dau
FROM pairs;Как посчитать МНК в SQL, Python и Excel
В PostgreSQL и DuckDB прямую считают агрегаты regr_slope(y, x) и regr_intercept(y, x): сначала зависимая величина, потом фактор. Документация PostgreSQL описывает результат как наклон прямой, подобранной методом наименьших квадратов. Проверим: посчитаем то же руками через пять сумм — n, Σx, Σy, Σxy и Σx². Наклон — b = (n·Σxy − Σx·Σy) / (n·Σx² − (Σx)²), свободный член — a = (Σy − b·Σx) / n.
На 90 закрытых днях, до 29 августа включительно, оба способа дают наклон 1,171 и свободный член −52,12.
Разойдутся они на пропусках. Уберите COALESCE — и в семи днях без оплат выручка станет NULL. regr_slope молча отбросит эти дни и вернёт 1,118 по 83 парам. Формула через суммы даст прежние 1,171: sum пропускает NULL, а count(*) и Σx считаются по всем 90 дням, и пустой день учтён как нулевая выручка. Здесь верен второй ответ, но что значит пропуск, решают до расчёта.
В Python прямую считает numpy.polyfit(x, y, 1), несколько факторов — numpy.linalg.lstsq(X, y, rcond=None); столбец единиц в X добавляют сами. Порядок аргументов обратный: сначала x.
В Excel наклон считает НАКЛОН(известные_значения_y; известные_значения_x), свободный член — ОТРЕЗОК с теми же аргументами; на пяти точках они вернут 0,8 и 26. Функция ЛИНЕЙН считает тем же методом и возвращает массив: сначала наклон, затем свободный член. В Excel 365 достаточно ввести формулу в одну ячейку, в старых версиях её вводят как формулу массива — Ctrl+Shift+Enter. Ей можно передать несколько столбцов x; коэффициенты тогда идут в обратном порядке столбцов.
WITH daily AS (
  SELECT d.day, d.dau, COALESCE(r.revenue, 0) AS revenue
  FROM (SELECT CAST(event_time AS date) AS day, count(DISTINCT user_id) AS dau
        FROM events GROUP BY 1) AS d
  LEFT JOIN (SELECT paid_at AS day, sum(amount) AS revenue
             FROM payments GROUP BY 1) AS r ON r.day = d.day
),
sums AS (
  SELECT
    count(*) AS n,
    sum(dau) AS sum_x,
    sum(revenue) AS sum_y,
    sum(dau * revenue) AS sum_xy,
    sum(dau * dau) AS sum_xx,
    regr_slope(revenue, dau) AS b_regr,
    regr_intercept(revenue, dau) AS a_regr
  FROM daily
  WHERE day < DATE '2026-08-30'
),
by_hand AS (
  SELECT *, 1.0 * (n * sum_xy - sum_x * sum_y) / (n * sum_xx - sum_x * sum_x) AS b
  FROM sums
)
SELECT
  n, sum_x, sum_y, sum_xy, sum_xx,
  round(CAST(b AS numeric), 3) AS slope_by_hand,
  round(CAST((sum_y - b * sum_x) / n AS numeric), 2) AS intercept_by_hand,
  round(CAST(b_regr AS numeric), 3) AS slope_regr,
  round(CAST(a_regr AS numeric), 2) AS intercept_regr
FROM by_hand;WITH daily AS (
SELECT d.day, d.dau, r.revenue
FROM (SELECT CAST(event_time AS date) AS day, count(DISTINCT user_id) AS dau
FROM events GROUP BY 1) AS d
LEFT JOIN (SELECT paid_at AS day, sum(amount) AS revenue
FROM payments GROUP BY 1) AS r ON r.day = d.day
WHERE d.day < DATE '2026-08-30'
),
sums AS (
SELECT
count(*) AS n,
sum(dau) AS sum_x,
sum(revenue) AS sum_y,
sum(dau * revenue) AS sum_xy,
sum(dau * dau) AS sum_xx,
regr_count(revenue, dau) AS pairs,
regr_slope(revenue, dau) AS b_regr
FROM daily
)
SELECT
n,
pairs,
round(CAST(1.0 * (n * sum_xy - sum_x * sum_y) / (n * sum_xx - sum_x * sum_x) AS numeric), 3) AS slope_by_hand,
round(CAST(b_regr AS numeric), 3) AS slope_regr
FROM sums;Кто придумал метод наименьших квадратов
Первым метод опубликовал французский математик Адриен Мари Лежандр: в 1805 году, в приложении к книге о расчёте орбит комет. Карл Фридрих Гаусс напечатал свой вариант в 1809 году в «Theoria motus corporum coelestium» и заявил, что пользуется методом с 1795 года. Этот спор о приоритете историк Стивен Стиглер называет самым известным в истории статистики (S. Stigler, «Gauss and the Invention of Least Squares», The Annals of Statistics, 1981). По его оценке — не окончательной, как он сам оговаривает, — Гаусс, вероятно, владел методом раньше Лежандра, но не сумел донести его до современников.
Гаусс добавил то, чего в приложении Лежандра не было: связал метод с теорией вероятностей и нормальным распределением ошибок. Теорема об оптимальности оценок носит его имя вместе с именем русского математика Андрея Маркова.
Частые вопросы
Как расшифровывается МНК и что такое OLS? МНК — метод наименьших квадратов. OLS (ordinary least squares, «обычный МНК») — его английское название; слово «обычный» отличает базовый вариант от взвешенного и обобщённого.
МНК и линейная регрессия — одно и то же? Нет. Регрессия — это модель, уравнение связи, а МНК — способ подобрать её коэффициенты. Ту же прямую можно подогнать методом наименьших модулей, и коэффициенты выйдут другими: на 90 днях учебной базы наклон 1,210 вместо 1,171.
Нужно ли, чтобы данные были распределены нормально? Для самих коэффициентов — нет: формулы работают на любых числах. Нормальность ошибок (самих x и y она не касается) нужна для точных интервалов и p-value на малых выборках.
Что такое взвешенный МНК? Вариант, в котором каждый квадрат остатка умножают на вес. Наблюдениям с большим разбросом дают меньший вес — так метод приспосабливают к неодинаковой дисперсии ошибок.
Что читать дальше
Запросы из этой статьи можно выполнить в песочнице симулятора SQL-аналитика: там та же учебная база.
Проверьте себя. Замените в пяти точках последнее значение 60 на 160 и пересчитайте прямую: должно получиться −14 + 2,8x. Одна точка увеличила наклон в три с половиной раза.
Материалы по теме
Линейная регрессия простыми словами: уравнение, наклон и R²
Что такое регрессия и линейная регрессия: уравнение y = a + b·x, наклон, свободный член и R². Пример на пяти точках, расчёт в SQL, Python и Excel, остатки, прогноз и ловушки.
Математическое ожидание: что это, формула и примеры
Математическое ожидание простыми словами: среднее, к которому результат сходится в долгую. Формула, пример на кубике, расчёт в SQL и Python, свойства и ловушки.
Коэффициент вариации: формула, расчёт и как читать
Коэффициент вариации — стандартное отклонение в процентах от среднего. Формула, пример на пяти числах, расчёт в SQL, Python и Excel, порог 33% для НМЦК и ловушки.