Медиана и перцентили в SQL: percentile_cont и percentile_disc
На ценах броней считаем p50 и p90, сравниваем непрерывный и дискретный перцентили, находим медиану без функции и сверяем pandas quantile.
Содержание статьи
Средняя стоимость брони 1 июля — 79 334,95 ₽, медиана — 56 000 ₽. Максимальная бронь превышает 1,2 млн ₽, поэтому средняя тянется за хвостом. Чтобы описать типичную покупку и дорогой край, нужны p50 и p90. В PostgreSQL percentile_cont интерполирует между наблюдениями, а percentile_disc возвращает одно из них; на p90 первого дня они уже расходятся: 167 480 против 167 500 ₽.
Короткий ответ: CONT или DISC
percentile_cont(0.5) WITHIN GROUP (ORDER BY amount) даёт непрерывную медиану: при чётном числе разных центральных значений между ними может появиться число, которого не было в таблице. percentile_disc(0.5) выбирает наблюдаемое значение — первый элемент, на котором накопленная доля достигла 50%. Для p90 логика такая же. Обе функции игнорируют NULL в сортируемом выражении.
Если нужен порог «настоящей цены», выбирайте DISC. Если нужна гладкая оценка распределения для сравнения сегментов, CONT часто удобнее. Но прежде решите, что именно измеряете: бронь, билет, перелёт или клиента. Опорная статья о перцентилях разбирает само понятие без SQL.
Перцентиль не является долей от суммы. p90 цены означает границу отсортированных наблюдений: примерно девять из десяти броней не дороже неё. Он не говорит, что эти брони принесли 90% выручки. Для доли выручки нужен накопительный денежный итог по отсортированным броням. Такое уточнение на встрече часто важнее выбора функции, потому что два похожих названия требуют разных расчётов и приводят к разным решениям.
Одна бронь — одна цена
Таблица bookings содержит одну строку на book_ref, а total_amount — стоимость всей брони. Мы не соединяем её с tickets и ticket_flights: после такого JOIN бронь с несколькими пассажирами повторилась бы и сместила перцентили. Период 1–3 июля задан полуоткрытым интервалом от 1 до 4 июля.
За 1 июля есть 5 353 брони, за 2-е — 5 535, за 3-е — 5 544. Это достаточно много для распределения, но не делает сравнение между днями причинным: каналы, состав поездок и календарь не контролируются одним перцентилем.
Если бы отчёт был по стоимости перелёта, пришлось бы перейти в ticket_flights, где один билет может иметь несколько сегментов. Если бы вопрос был о тратах клиента, нужно было бы сначала сложить брони по выбранной идентичности. Все три распределения могут иметь разные p50 и p90. Поэтому таблица ниже подписана именно «стоимость брони», а не «цена билета» или «чек клиента».
| День | Броней | Средняя | p50 CONT | p90 CONT | Максимум |
|---|---|---|---|---|---|
| 1 июля | 5 353 | 79 334,95 | 56 000 | 167 480 | 1 204 500 |
| 2 июля | 5 535 | 78 481,14 | 55 800 | 167 500 | 799 200 |
| 3 июля | 5 544 | 80 009,97 | 56 000 | 168 000 | 782 400 |
PostgreSQL: медиана и p90 по дням
В PostgreSQL это упорядоченные агрегаты: обычный GROUP BY оставляет по одной строке на дату, а порядок для перцентиля указывается внутри WITHIN GROUP, не во внешнем ORDER BY. Округление средней сделано на numeric, поскольку round(double precision, integer) в PostgreSQL нет.
На 1 июля дискретный p90 равен 167 500 ₽ — это цена конкретной брони. Непрерывный p90 равен 167 480 ₽ и может лежать между соседними ценами. Для медианы обоих методов в выбранном дне получилось 56 000, но совпадение этого числа не делает функции одинаковыми.
Группировка по дню происходит после фильтра времени. Условие book_date <= DATE '2026-07-03' включило бы только полночь 3 июля, а не весь день, поэтому последний дневной перцентиль оказался бы рассчитан на иной выборке. Полуоткрытая граница до 4 июля удерживает весь третий день. Проверка числа броней рядом с p50 помогает ловить такие ошибки, даже когда сами медианы из-за округления выглядят похожими.
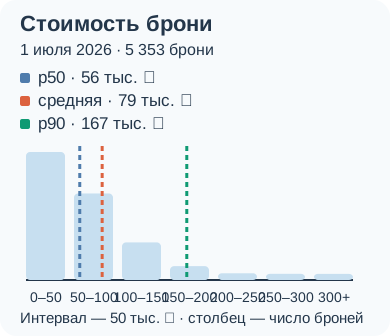
Максимум вынесен в ту же шкалу намеренно: он показывает тяжёлый хвост, из-за которого средняя выше медианы.
SELECT CAST(book_date AS DATE) AS day, count(*) AS bookings,
       round(avg(total_amount), 2) AS mean_amount,
       percentile_cont(0.5) WITHIN GROUP (ORDER BY total_amount) AS p50_cont,
       percentile_disc(0.5) WITHIN GROUP (ORDER BY total_amount) AS p50_disc,
       percentile_cont(0.9) WITHIN GROUP (ORDER BY total_amount) AS p90_cont,
       percentile_disc(0.9) WITHIN GROUP (ORDER BY total_amount) AS p90_disc,
       max(total_amount) AS max_amount
FROM bookings
WHERE book_date >= TIMESTAMP '2026-07-01'
  AND book_date < TIMESTAMP '2026-07-04'
GROUP BY 1 ORDER BY 1;
Четыре реальные брони: где CONT создаёт новое число
Возьмём четыре брони того же дня по фиксированным book_ref. Их цены в порядке возрастания: 16 400, 26 000, 234 800, 265 700 ₽. При чётном числе строк середина лежит между вторым и третьим значениями. CONT возвращает 130 400 ₽ — арифметическое среднее двух центральных цен, DISC — 26 000 ₽, нижнюю из двух центральных цен при p=0,5.
Это синтетическая по выбору четвёрка, но сами четыре цены и ключа взяты из учебной таблицы. Нельзя писать, что медианная бронь «стоила 130 400»: такой брони в этом маленьком наборе нет. Для продуктовой карточки порога DISC может быть понятнее, для непрерывной статистики CONT остаётся осмысленным.
Четвёрка нарочно мала, чтобы расчёт можно было проверить без доверия функции: отсортируйте четыре числа, возьмите среднее второго и третьего, затем найдите первое значение, на котором накопленная доля достигла половины. На полном дне такой ручной обход уже неудобен, но логика функции та же. При большом числе одинаковых цен DISC часто совпадает с CONT на одной отметке; это свойство данных, а не эквивалентность методов.
| Отсортированные цены | p50 CONT | p50 DISC |
|---|---|---|
| 16 400; 26 000; 234 800; 265 700 | 130 400 | 26 000 |
SELECT count(*) AS bookings,
       percentile_cont(0.5) WITHIN GROUP (ORDER BY total_amount) AS p50_cont,
       percentile_disc(0.5) WITHIN GROUP (ORDER BY total_amount) AS p50_disc
FROM bookings
WHERE book_ref IN ('00000F','000859','0012C1','003EB0');
Медиана без percentile_cont
На собеседовании иногда запрещают готовую функцию. Тогда отсортируйте значения через row_number(), рядом получите размер группы через count(*) OVER (), оставьте центральную одну или две строки и возьмите их среднее. Для 5 353 броней 1 июля центральная строка — 2 677-я; результат 56 000 ₽.
Для чётного размера условие на позиции должно захватывать обе середины. Формула rn IN ((n+1)/2, (n+2)/2) с целочисленным делением в PostgreSQL выглядит кратко, но переносимость деления в DuckDB иная. Ниже использованы неравенства через n/2.0, чтобы смысл не зависел от этого отличия.
Сортировка дополнена book_ref, чтобы при равных суммах номера строк не зависели от плана выполнения. Для самой медианы это не меняет цену центральных наблюдений, но делает список выбранных строк воспроизводимым. Если попросили «покажите две конкретные центральные брони», без второго ключа ответ может прыгать между запусками при ничьей в стоимости.
WITH ranked AS (
  SELECT total_amount,
         row_number() OVER (ORDER BY total_amount, book_ref) AS rn,
         count(*) OVER () AS n
  FROM bookings
  WHERE book_date >= TIMESTAMP '2026-07-01'
    AND book_date < TIMESTAMP '2026-07-02'
)
SELECT count(*) AS middle_rows, avg(total_amount) AS median_amount
FROM ranked
WHERE rn >= n / 2.0 AND rn <= n / 2.0 + 1;
Медиана рядом с исходной строкой
В PostgreSQL percentile_cont(...) WITHIN GROUP (...) OVER (...) для упорядоченного агрегата не поддерживается. Если нужно показать порог рядом с каждой бронью, сначала посчитайте его в CTE по группе, затем присоедините к исходным строкам по ключу группы. Для одной даты можно присоединить агрегат через CROSS JOIN; для нескольких дат — по дате.
DuckDB поддерживает median() и quantile_cont() как агрегаты и оконные функции; это отдельный диалект. Не переносите median(total_amount) OVER (...) в PostgreSQL только потому, что он работал в учебном DuckDB. В проверке PostgreSQL возвращает ошибку про ordered-set aggregate с OVER.
При нескольких датах CTE порогов должен иметь одну строку на дату и присоединяться именно по ней. Если сделать CROSS JOIN одного общего порога ко всем датам, таблица будет технически ровной, но ответит на вопрос «насколько каждая бронь выше медианы всего периода», а не своего дня. Нужный уровень порога следует записать в имени поля и в ключе соединения.
WITH sample AS (
  SELECT book_ref, total_amount FROM bookings
  WHERE book_date >= TIMESTAMP '2026-07-01' AND book_date < TIMESTAMP '2026-07-02'
), threshold AS (
  SELECT percentile_cont(0.5) WITHIN GROUP (ORDER BY total_amount) AS median_amount
  FROM sample
)
SELECT s.book_ref, s.total_amount, t.median_amount
FROM sample s CROSS JOIN threshold t
ORDER BY s.book_ref LIMIT 3;
То же в pandas: median и quantile
В pandas Series.median() и quantile(0.5) дают 56 000 ₽ за 1 июля; quantile(0.9) с методом linear даёт 167 480 ₽, как CONT. Для четырёх выбранных броней quantile(0.5, interpolation="lower") даёт 26 000 ₽, как DISC на этом наборе.
Но lower не является универсальным переводом percentile_disc для любого n и q. DISC выбирает позицию по первому значению с накопленной долей не меньше q; интерполяции pandas работают от индекса между 0 и n−1. Если нужен точный DISC в Python, отсортируйте ряд и возьмите элемент с индексом ceil(q*n)-1, контролируя q=0 отдельно.
Код печатает результаты на той же таблице: 5 353 наблюдения, p50 56 000, p90 CONT 167 480 и p90 DISC 167 500. Для четырёх броней CONT 130 400 и lower 26 000. Это полезный локальный тест при переносе витрины из SQL в ноутбук: сначала сравните точные значения на одном срезе, потом переносите код на все группы.
import math
import pandas as pd

b = pd.read_parquet('bookings.parquet', columns=['book_ref', 'book_date', 'total_amount'])
b['book_date'] = pd.to_datetime(b['book_date'])
day = b.loc[b.book_date.ge(pd.Timestamp('2026-07-01')) & b.book_date.lt(pd.Timestamp('2026-07-02'))]
values = day.total_amount.astype(float)
ordered = values.sort_values().reset_index(drop=True)
disc90 = ordered.iloc[max(math.ceil(0.9 * len(ordered)) - 1, 0)]
four = b.loc[b.book_ref.isin(['00000F','000859','0012C1','003EB0']), 'total_amount'].astype(float)
print(len(day), int(values.median()), int(values.quantile(0.9)), int(disc90))
print(int(four.quantile(0.5)), int(four.quantile(0.5, interpolation='lower')))
Ловушка 1: цена брони размножена JOIN
Если соединить bookings с билетами и затем считать медиану total_amount, бронь с двумя пассажирами войдёт дважды, с тремя — трижды. В день 1 июля исходных броней 5 353; любое большее число строк после JOIN уже означает другие веса. Исправление — сначала определить зерно метрики, посчитать по исходным броням или вернуть одну строку на book_ref.
Не исправляйте это DISTINCT total_amount: две разные брони могут иметь одинаковую цену. Такой DISTINCT уберёт легальные наблюдения и создаст третье, неверное распределение.
Ловушка 2: средняя названа типичной ценой
1 июля средняя 79 334,95 ₽ против медианы 56 000 ₽; максимальная бронь 1 204 500 ₽. Если подписать среднюю как цену «обычной брони», читатель подумает о середине распределения, хотя на неё влияет дорогой хвост. Исправление — показывать p50 рядом со средней и p90, а не выбирать одно число без формы распределения.
Рисунок отмечает эту дистанцию. Сравнение с обычной медианой и средней полезно перед переносом в SQL.
Ловушка 3: DISC ждут на интерполированной отметке
У первого дня p90 CONT — 167 480 ₽, DISC — 167 500 ₽. Неправильно ждать от DISC промежуточное значение и считать 20 ₽ расхождения ошибкой запроса. Исправление — выбрать метод по смыслу порога и записать его в определении метрики.
На четырёх бронях расхождение гораздо крупнее: CONT 130 400 ₽, DISC 26 000 ₽. Размер разницы зависит от расстояния между соседними порядковыми значениями, а не от качества функции.
Ловушка 4: NTILE принимают за точный перцентиль
ntile(4) OVER (ORDER BY amount) распределяет строки по четырём корзинам с близким числом записей. При повторяющихся ценах одинаковые значения могут оказаться по разные стороны границы корзины. Это не порог p25 или p75 как значение цены.
На 5 353 бронях группы будут иметь примерно 1 338–1 339 строк, но этот баланс строк не отвечает на вопрос «какая цена в 90% броней не превышена». Для такого вопроса используйте p90 по явно выбранному методу.
Ловушка 5: ROUND без приведения типа
В PostgreSQL percentile_cont возвращает double precision. Вызов round(percentile_cont(...), 2) падает: у round(double precision, integer) нет подходящей перегрузки. Исправление — привести к numeric перед округлением, если нужны десятичные знаки, или округлять для отображения в клиенте.
В основном запросе p50 и p90 оставлены как точные возвращаемые значения, а средняя по numeric total_amount округлена через round(avg(...), 2). Проверяйте тип промежуточного выражения, не только вид исходной колонки.
Отдельная ловушка — округлять каждую бронь до тысяч рублей перед вычислением перцентиля. Тогда несколько разных сумм сольются в одну отметку, и при большом числе ничьих DISC может перескочить на соседнюю цену. Сначала считайте по исходной денежной колонке, затем округляйте результат только для таблицы или подписи графика. Контрольный p90 167 480 ₽ полезен именно как число до такого редакционного округления.
Частые вопросы
Что делает percentile_cont(0.5)? Возвращает непрерывную медиану и при необходимости интерполирует между центральными значениями.
Чем отличается percentile_disc? Он выбирает существующее наблюдение, на котором накопленная доля достигла заданного q.
Как посчитать медиану без функции? Пронумеровать отсортированные строки, оставить одну или две центральные и усреднить их.
Можно ли сделать процентиль оконной функцией в PostgreSQL 14? Для ordered-set aggregate с WITHIN GROUP — нет; считайте порог в CTE и присоединяйте. Ключ такого JOIN должен соответствовать уровню порога: день к дню, сегмент к сегменту.
Материалы по теме
FULL JOIN и CROSS JOIN в SQL: сверка и сетка без пропусков
FULL JOIN и CROSS JOIN для сверки броней и заполнения пустых часов: запросы PostgreSQL и pandas, три зоны результата, дубли и ловушка пустого ключа.
Рамка окна в SQL: ROWS BETWEEN, RANGE и GROUPS на примерах
ROWS, RANGE и GROUPS на восьми открытиях приложения: три разных ответа, рамка по умолчанию и граница pandas rolling против SQL RANGE.
ROLLUP, CUBE и GROUPING SETS в SQL: подытоги в одном запросе
На событиях приложения сравниваем ROLLUP, CUBE и GROUPING SETS: как отличить настоящий NULL от итога, не сложить уникальных клиентов дважды и повторить расчёт в pandas.