Рамка окна в SQL: ROWS BETWEEN, RANGE и GROUPS на примерах
ROWS, RANGE и GROUPS на восьми открытиях приложения: три разных ответа, рамка по умолчанию и граница pandas rolling против SQL RANGE.
Содержание статьи
Участник учебной программы лояльности открыл приложение восемь раз между 3 и 10 июля, но активных дней было только пять. В строке первого открытия 7 июля «последние семь строк» дают 2 события, «последние семь календарных дней» — 4, а рамка по умолчанию сразу показывает 4 из-за трёх открытий за один день. ROWS, RANGE и GROUPS отвечают на разные вопросы; если не назвать нужную единицу окна, скользящая метрика тихо меняет смысл.
Коротко: три единицы рамки
ROWS BETWEEN 6 PRECEDING AND CURRENT ROW берёт текущую строку и до шести предыдущих строк в порядке сортировки. RANGE BETWEEN INTERVAL '6 days' PRECEDING AND CURRENT ROW берёт все строки с датой от текущей минус шесть календарных дней до текущей включительно. GROUPS BETWEEN 6 PRECEDING AND CURRENT ROW берёт текущую группу равных значений сортировки и до шести предыдущих групп.
Оконный PARTITION BY определяет, чьи строки вообще рассматриваются, ORDER BY — в каком порядке, рамка — какая часть упорядоченного раздела участвует в агрегате. Если нужен базовый разбор OVER и PARTITION BY, он есть в предыдущей статье. Здесь вопрос уже: почему два корректных запроса возвращают разные числа.
Данные: восемь открытий, пять дат
Берём события app_open для участника 605 до 15 июля. Два события от 3 и 7 июля не соседствуют по календарю; 7 июля приложение открыли три раза. Следующие дни — 8, 9 и 10 июля, причём 10 июля открытий два. Таким образом, строковый счёт, календарный счёт и счёт активных дат должны расходиться.
В учебной базе событие имеет event_time с точностью до секунды. Для ROWS порядок задаём двумя полями — день, затем время события. Для RANGE и GROUPS намеренно сортируем только по дню: одинаковые даты образуют peers, одну группу. Если добавить время в ORDER BY, группы равных ключей исчезнут и пример станет другой задачей.
| Дата | Открытий | Что важно |
|---|---|---|
| 3 июля | 1 | начало ряда |
| 7 июля | 3 | три строки с одной датой |
| 8 июля | 1 | следующий день |
| 9 июля | 1 | ещё день |
| 10 июля | 2 | две строки с одной датой |
Один запрос показывает три разных ответа
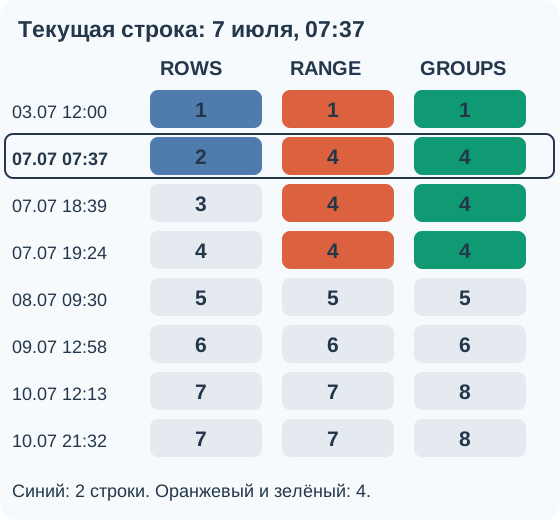
Этот запрос выводит каждое открытие и три числа рядом. ROWS считает последние семь физических строк, RANGE — события за семь календарных дат, GROUPS — события за последние семь активных дат. В первом открытии 7 июля значения 2, 4 и 4: ROWS ещё не дошёл до остальных событий того же дня, а RANGE и GROUPS видят всю группу дат.
У первого открытия 10 июля значения становятся 7, 7 и 8. RANGE уже исключил 3 июля, потому что это старше шести календарных дней; GROUPS видит все пять активных дней и восемь открытий. Вторая строка 10 июля тоже входит в текущую группу для RANGE и GROUPS. Это особенно заметно на графике, где две точки одного дня могут иметь одну и ту же оконную сумму.
| Открытие | ROWS | RANGE | GROUPS |
|---|---|---|---|
| 7 июля 07:37 | 2 | 4 | 4 |
| 10 июля 12:13 | 7 | 7 | 8 |
| 10 июля 21:32 | 7 | 7 | 8 |
WITH opens AS (
  SELECT event_time, CAST(event_time AS DATE) AS day
  FROM app_events
  WHERE event_name = 'app_open' AND member_id = 605
    AND event_time < TIMESTAMP '2026-07-15'
)
SELECT event_time,
       count(*) OVER (ORDER BY day, event_time
         ROWS BETWEEN 6 PRECEDING AND CURRENT ROW) AS last_7_rows,
       count(*) OVER (ORDER BY day
         RANGE BETWEEN INTERVAL '6 days' PRECEDING AND CURRENT ROW) AS last_7_days,
       count(*) OVER (ORDER BY day
         GROUPS BETWEEN 6 PRECEDING AND CURRENT ROW) AS last_7_active_days
FROM opens ORDER BY event_time;
Рамка на рисунке: текущая строка 7 июля
Схема подсвечивает строки, которые функция видит у первого открытия 7 июля. Для ROWS включены 3 июля и текущее открытие; два более поздних открытия 7 июля остаются вне физической рамки. Для RANGE все три открытия 7 июля входят одновременно, потому что сортировка задаёт одну дату. Для GROUPS текущая группа тоже входит целиком.
У такой схемы нет «правильного» цвета одной рамки. Вопрос «сколько последних открытий» требует ROWS, «сколько открытий за календарную неделю» — RANGE, «сколько открытий за последние семь дней с активностью» — GROUPS. Название метрики обязано обозначать выбранную единицу.
В pandas rolling(3) считает три существующие строки дневной сводки. Временное rolling("3D") по умолчанию исключает левую границу: для 10 июля оно даёт 4 открытия за 8–10 июля. SQL RANGE INTERVAL '3 days' PRECEDING включает 7 июля и даёт 7. Укажите closed="both" в pandas, чтобы получить те же 7. Прямого аналога SQL GROUPS в pandas rolling нет: для последних N активных дат нужно отдельно определить группы и агрегировать их.
WITH daily AS (
  SELECT CAST(event_time AS DATE) AS day, count(*) AS opens
  FROM app_events
  WHERE member_id = 605 AND event_name = 'app_open'
    AND event_time < TIMESTAMP '2026-07-15'
  GROUP BY 1
), windows AS (
  SELECT day, sum(opens) OVER (ORDER BY day
    RANGE BETWEEN INTERVAL '3 days' PRECEDING AND CURRENT ROW) AS opens_including_boundary
  FROM daily
)
SELECT day, opens_including_boundary FROM windows WHERE day = DATE '2026-07-10';import pandas as pd
e = pd.read_parquet('app_events.parquet', columns=['member_id', 'event_name', 'event_time'])
e['event_time'] = pd.to_datetime(e['event_time'])
opens = e.loc[e.member_id.eq(605) & e.event_name.eq('app_open') &
e.event_time.lt(pd.Timestamp('2026-07-15')), ['event_time']].copy()
opens['day'] = opens.event_time.dt.normalize()
daily = opens.groupby('day').size().rename('opens')
rows = daily.rolling(3, min_periods=1).sum()
default = daily.rolling('3D').sum()
inclusive = daily.rolling('3D', closed='both').sum()
day = pd.Timestamp('2026-07-10')
print(int(rows.loc[day]), int(default.loc[day]), int(inclusive.loc[day]))Скользящее среднее: семь строк не равны семи дням
Для среднего количества открытий можно сначала агрегировать события до дня, а затем применять окно. Если в дневной сводке нет дат без активности, семь строк — это семь активных дней, которые могут занимать две недели календаря. RANGE INTERVAL '6 days' ограничивает календарное расстояние, но среднее берёт только существующие строки; дни без активности не становятся нулями сами собой.
Если вопрос звучит «среднее на календарный день включая нули», сначала строится полный ряд дат и присоединяется дневной факт. Если вопрос «среднее по дням с открытиями», оставляют разреженную сводку. Отдельный материал о датах и интервалах объясняет полуоткрытые границы. Смешение этих двух средних меняет знаменатель, даже когда сумма событий одинакова.
Ось X категориальная: расстояния между датами на графике одинаковы; значения — из дневной сводки участника 605.
WITH daily AS (
  SELECT CAST(event_time AS DATE) AS day, count(*) AS opens
  FROM app_events
  WHERE event_name = 'app_open' AND member_id = 605
    AND event_time < TIMESTAMP '2026-08-01'
  GROUP BY 1
)
SELECT day, opens,
       round(avg(opens) OVER (ORDER BY day
         ROWS BETWEEN 6 PRECEDING AND CURRENT ROW), 2) AS last_7_rows_avg,
       round(avg(opens) OVER (ORDER BY day
         RANGE BETWEEN INTERVAL '6 days' PRECEDING AND CURRENT ROW), 2) AS last_7_days_avg
FROM daily ORDER BY day;
Ловушка 1: ROWS называют календарной неделей
Неправильно: count(*) OVER (ORDER BY day, event_time ROWS BETWEEN 6 PRECEDING AND CURRENT ROW) с подписью «открытия за последние семь дней». На первом событии 7 июля он даёт 2, тогда как календарный RANGE даёт 4. ROWS не знает, что позже в том же дне есть ещё два открытия, и не измеряет расстояние между датами.
Исправление — RANGE BETWEEN INTERVAL '6 days' PRECEDING AND CURRENT ROW, если нужны события от текущей даты и шести предыдущих. Если нужны последние семь событий вне зависимости от даты, ROWS верен, но подпись должна быть «последние семь открытий».
Ловушка 2: рамку по умолчанию считают построчной
Неправильно оставить count(*) OVER (ORDER BY day) и ожидать накопление по одной строке. В PostgreSQL и DuckDB рамка по умолчанию с ORDER BY включает peers текущей строки. Поэтому у каждого из трёх открытий 7 июля сразу будет 4, а не 2, 3, 4. У обоих открытий 10 июля — 8.
Исправление — явная ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW, если нужны последовательные 1, 2, 3… по строкам, и детерминированное ORDER BY day, event_time, event_id при возможных равных временах. Если требуется сумма по завершённому дню, ступеньки peers как раз уместны — нужно лишь назвать их.
Ловушка 3: GROUPS путают с RANGE
Неправильно взять GROUPS BETWEEN 6 PRECEDING AND CURRENT ROW и подписать «последняя календарная неделя». На первом открытии 10 июля GROUPS даёт 8 событий: он охватывает пять имеющихся активных дат, включая 3 июля. Календарный RANGE даёт 7, поскольку 3 июля уже вне недели.
Исправление — выбрать правило по вопросу. GROUPS считает группы одинаковых значений ORDER BY и удобен, когда нужны N последних дней с наблюдениями. RANGE считает расстояние в значениях ключа. Если дат нет, GROUPS перескакивает пробел, RANGE — нет. Серии и пропуски помогают заметить этот разрыв.
Ловушка 4: фильтр поставлен до окна
Неправильно добавить AND event_time >= TIMESTAMP '2026-07-07' внутрь CTE opens, а потом спрашивать «сколько открытий за семь дней на 7 июля». Первое открытие 7 июля увидит лишь три события этого дня вместо четырёх: строка 3 июля уже выброшена до расчёта окна. Оконные функции видят только строки результата FROM/WHERE своего уровня.
Исправление — считать окно на полной доступной истории, а фильтр видимых дат ставить во внешнем SELECT. Если исходный журнал действительно начинается позже, полного окна нет: в отчёте надо пометить ранние даты как незрелые, а не подменять неизвестное нулём. В нашей базе журнал начинается 1 июля, поэтому окна у самого края периода требуют оговорки.
Ловушка 5: LAST_VALUE возвращает «сегодня»
Неправильно написать last_value(day) OVER (ORDER BY day) для последней даты в разделе. У открытия 3 июля результат будет 3 июля, хотя последнее открытие выбранного ряда случилось 10 июля. Функция смотрит на конец текущей рамки, а рамка по умолчанию заканчивается текущей группой peers.
Исправление — ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING, если нужен конец всего раздела. Тогда у всех восьми строк последняя дата — 10 июля. Альтернатива max(day) OVER () проще, если нужен именно максимум даты; LAST_VALUE нужен, когда значение другой колонки соответствует последней строке по заданному порядку.
Ловушка 6: сортировка без устойчивого порядка
Внутри 7 июля три открытия. Если для ROWS написать только ORDER BY day, база вправе выбрать любой физический порядок среди равных дат. Числа 2, 3, 4 распределятся между тремя событиями непредсказуемо. В нашем запросе event_time расставляет их по времени, но для общих таблиц нужно ещё учитывать совпадение секунд и добавить стабильный ключ.
Для RANGE и GROUPS, напротив, убрать равенство дат добавлением времени — значит изменить определение группы. Сравнивайте окна с разным ORDER BY осознанно: два запроса могут возвращать ровные, правдоподобные числа, измеряя разные вещи. Разбор ROW_NUMBER и LAG показывает, где устойчивый порядок обязателен.
В других СУБД
PostgreSQL 14 и используемая версия DuckDB поддерживают ROWS, RANGE с INTERVAL '6 days' и GROUPS; запрос выше выполнен в обоих движках на одних Parquet. Поведение рамки по умолчанию и last_value сверено исполнением. Переносить вычисление в другую СУБД следует с проверкой синтаксиса рамок и типа ключа сортировки: поддержка GROUPS и интервальных смещений не универсальна.
Рамка не меняет сами строки результата: оконный агрегат добавляет значение к каждой строке. Поэтому прежде чем связывать её с дневным графиком, определите, нужен график событий или график дней. Это решение нельзя исправить выбором цвета линии.
Два честных средних из одного ряда
Окно на дневной сводке и окно на сырых событиях не взаимозаменяемы. Если сначала свести несколько открытий 7 июля в одну дневную строку, ROWS считает активные даты и среднее дневных количеств. Если оставить восемь сырых событий, ROWS считает события; avg(1) там всегда будет единицей и не ответит на вопрос о средней активности в день. Поэтому зерно CTE daily — не техническая деталь, а часть определения величины на графике.
Перед переносом такого графика в дашборд проверьте, что дата на оси и дата в ORDER BY окна взяты из одного часового пояса. В учебной базе время хранится как московское без зоны, поэтому CAST(event_time AS DATE) соответствует заданной локальной дате. На потоке в UTC без перевода часового пояса часть поздних событий переедет в соседний день, и скользящая неделя изменится у границы.
На 10 июля за последние семь строк дневной сводки доступны только пять активных дат: 3, 7, 8, 9 и 10 июля. Среднее число открытий по этим датам — 1,60. RANGE от 4 до 10 июля исключает 3-е и считает 1,75 по четырём активным дням. Оба числа верны для своих знаменателей, но ни одно не является средним за семь календарных дней с нулями: для него нужно достроить 4, 5 и 6 июля как даты без открытий.
На 29 июля после нового разрыва ROWS берёт семь последних активных строк дневной сводки и даёт 1,43; календарный RANGE видит только 29 июля и даёт 1. Это не «ошибка окна» — это свойство разреженного ряда. Если показать линии без пояснения, читатель решит, что одна из них сглажена лучше. Подпись должна отвечать, какие даты в знаменателе и что считается нулевым днём.
Среднее у края истории тоже незрелое. У 3 июля в обоих вариантах оно равно 1, но это среднее по одной наблюдаемой дате, а не по полноценной неделе. Для недельного сравнения можно скрывать первые шесть дней, оставляя расчёт на полной истории, или показывать рядом число дат в рамке. Второй способ полезен при отладке: он сразу объясняет, почему два одинаковых значения имеют разную надёжность.
Как читать график с нерегулярными датами
Встроенная линия ставит все десять наблюдаемых дат на равном расстоянии: 10 и 19 июля соседствуют на экране так же, как 8 и 9 июля, хотя между ними девять календарных дней. Это категориальная ось, удобная для сравнения десяти значений, но она не изображает расстояние времени. Для диагноза паузы нужен календарный ряд с явными пустыми датами либо график с настоящей временной осью.
Перед публикацией метрики проверьте крайние строки: первый день в выборке, первый день после длинного пропуска, день с несколькими событиями, последний неполный день. У участника 605 именно 7 и 10 июля различают ROWS, RANGE и GROUPS; обычный день с одним событием не выявил бы ошибку. Такой набор контрольных строк можно хранить рядом с SQL как небольшой регрессионный пример.
Частые вопросы
Чем ROWS отличается от RANGE? ROWS отсчитывает позиции в упорядоченном разделе, RANGE — расстояние по значению ключа. При пропусках дат и нескольких строках в день результаты различаются.
**Что значит 6 PRECEDING для семи дней?** Текущая дата плюс шесть предыдущих календарных дат — семь дат. Если поставить семь предыдущих, получится восемь.
Что считает GROUPS? Группы равных значений ORDER BY. При сортировке по дню все открытия одного дня составляют группу, даже если между активными днями календарные пропуски.
Почему LAST_VALUE равен текущей строке? По умолчанию рамка заканчивается текущей группой. Укажите UNBOUNDED FOLLOWING, если вам нужен конец раздела.
Где фильтровать отчётный период? После слоя с оконным расчётом, если для первых видимых дат нужны предыдущие строки истории.
Материалы по теме
PARTITION BY и OVER в SQL: окно, группы и отличие от GROUP BY
PARTITION BY и OVER в SQL: окно и отличие от GROUP BY, доля от итога, накопительный итог, рамки ROWS и RANGE, фильтр по оконной функции.
Продвинутый SQL для аналитика: что учить после JOIN и GROUP BY
Карта продвинутого SQL после JOIN и GROUP BY: окна, временные ряды, рекурсия, JSON, история изменений и проверка данных на одной учебной базе авиакомпании.
LAG и LEAD в SQL: предыдущая и следующая строка на примерах
LAG и LEAD в SQL и PostgreSQL на учебной базе: синтаксис с offset и default, паузы между событиями, DAU к вчера и к прошлой неделе, следующий шаг после события, ничьи в ORDER BY, QUALIFY и IGNORE NULLS.