Продвинутый SQL для аналитика: что учить после JOIN и GROUP BY
Карта продвинутого SQL после JOIN и GROUP BY: окна, временные ряды, рекурсия, JSON, история изменений и проверка данных на одной учебной базе авиакомпании.
Содержание статьи
Продвинутый SQL начинается там, где запрос уже выполняется, но число всё равно не сходится: JOIN размножил сумму, окно посчитало семь строк вместо семи дней, JSON-массив выбросил покупки без допуслуг, а история клиента показала текущий уровень вместо уровня на дату сделки. После уверенных SELECT, JOIN и GROUP BY изучайте окна и зерно результата, даты и соединения, последовательности, сложную агрегацию и JSON, затем историю изменений и контроль качества. Ниже — маршрут по курсу и проверенные примеры на одной учебной базе авиакомпании.
Короткий маршрут по продвинутому SQL
Если предыдущий запрос «почти верный», не начинайте с ещё одного вложенного SELECT. Сначала назовите сущность одной строки, источник времени и правило пропуска. Затем выберите приём: окно для расчёта рядом со строкой, FULL JOIN для сверки двух наборов, CROSS JOIN для ожидаемой сетки, рекурсию для цепочки переходов, LATERAL для локального набора строк, JSON-функцию для элементов вложенного списка.
Проверять надо не только синтаксис. К каждому SQL-фрагменту задайте контрольный вопрос: сколько строк до и после, сколько разных ключей, что происходит на NULL, на пустом дне и на повторном событии. На учебной базе курса «Продвинутый SQL» 16 модулей и 48 уроков; карта курса доступна по ссылке. Этот материал помогает выбрать начало, а не заменяет задачи.
| Вопрос | Приём | Материал |
|---|---|---|
| Покупки и брони не сходятся | FULL JOIN по уникальному ключу | FULL/CROSS JOIN |
| Нужны все часы и платформы, включая нули | CROSS JOIN сетки | FULL/CROSS JOIN |
| Какие два рейса близки по времени | Self join с окном | Self join |
| За семь дней или за семь событий | RANGE против ROWS | Рамка окна |
| Что лежит в списке допуслуг | Разворот JSON-массива | Массивы JSON |
| Какие пункты достижимы с пересадками | WITH RECURSIVE | Рекурсивный запрос |
Что меняется после «SQL с нуля»
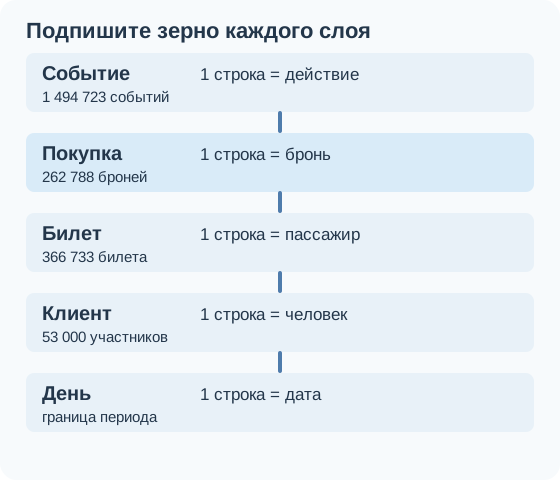
На первом этапе вы учитесь выбрать строки, сгруппировать их и соединить две таблицы по ключу. Во втором этапе исходной таблицы часто недостаточно. Нужна история значений на дату, справочник всех ожидаемых клеток, последовательность событий или набор элементов внутри JSON. Результат приходится строить по слоям, и каждый слой меняет зерно: событие, покупка, билет, клиент, день.
Если SELECT и обычный JOIN ещё требуют подсказки, пройдите маршрут «Как выучить SQL с нуля» и полку базовых конструкций. Сложный синтаксис не компенсирует ошибки в простом WHERE. Если база даётся уверенно, можно начать с окон и проверок кардинальности, даже не зная заранее все функции.
Часть той же работы удобно делать в pandas: merge сверяет наборы, rolling считает окна, pivot_table разворачивает категории. Таблица ниже — карта инструментов, а не обещание одинаковой семантики: pandas сопоставляет пустые ключи при merge, а граница временного rolling по умолчанию отличается от включительной рамки SQL. Различия разобраны в отдельных материалах.
| Задача | SQL | pandas |
|---|---|---|
| Соединить источники | JOIN | merge |
| Сохранить строку и добавить агрегат | OVER (PARTITION BY) | groupby().transform |
| Скользящая метрика | ROWS / RANGE | rolling |
| Категории в столбцы | Условная агрегация / PIVOT | pivot_table |
| Полный ряд дат | generate_series + LEFT JOIN | date_range + reindex |
Часть 1. Окна: агрегат рядом со строкой
GROUP BY signup_channel даст по одной строке на канал. Оконное sum(count(*)) OVER () добавит к каждой группе общий итог, не теряя сам канал. На 53 000 участников учебной программы лояльности канал app дал 21 053, web — 19 092, airport — 12 855; в каждой строке рядом стоит 53 000. Так вычисляют долю группы и сравнивают её с общим числом без отдельного запроса к таблице.
Дальше появляются ROW_NUMBER, RANK, LAG и рамки. Ранги помогают выбрать топ-N с ничьими, LAG — проверить паузу между событиями, рамка — определить, какие предшествующие строки участвуют в сумме. Обзор окон и PARTITION BY закрывают вход; разбор рамок показывает следующий шаг.
| Канал | Участников | Всего во всех строках |
|---|---|---|
| airport | 12 855 | 53 000 |
| app | 21 053 | 53 000 |
| web | 19 092 | 53 000 |
SELECT signup_channel, count(*) AS members,
       sum(count(*)) OVER () AS all_members
FROM loyalty_members
GROUP BY signup_channel ORDER BY signup_channel;
Часть 1. Даты, пары и сверка источников
Дата — не просто строка для сортировки. На 15 июля запланировано 548 вылетов, но запрос <= '2026-07-15' на timestamp оставит только начало дня. Для ежедневного среза используйте полуоткрытый интервал от полуночи 15-го включительно до полуночи 16-го исключительно. Та же дисциплина понадобится при соединении двух журналов по времени.
Соединение таблицы с собой помогает найти пары вылетов одного аэропорта в пределах получаса: их 375. FULL JOIN показывает три зоны сверки бронирований и покупок; CROSS JOIN достраивает пустые клетки отчёта. Если нужен ближайший связанный факт, рассмотрите LATERAL. Если путь имеет переменное число шагов, используют рекурсию. Эти приёмы нельзя заменить одним универсальным JOIN.
SELECT count(*) AS flights_on_july_15
FROM flights
WHERE scheduled_departure >= TIMESTAMP '2026-07-15'
AND scheduled_departure < TIMESTAMP '2026-07-16';Часть 2. Последовательности и структура данных
События приложения приходят потоком: всего в учебном журнале 1 494 723 строки, из них 295 791 открытие приложения. Чтобы ответить, что клиент сделал после открытия, нужно упорядочить события по клиенту и времени, а не считать один общий max(event_time). Чтобы выделить сессии, измеряют паузу между соседними событиями; чтобы найти дни подряд, выделяют начало новой серии. Здесь JOIN обычно уступает окнам и нескольким CTE.
После последовательностей курс переходит к сложной агрегации и JSON. ROLLUP и GROUPING SETS готовят подытоги, условная агрегация разворачивает категории в столбцы, массив JSON превращается в строки. Статья о развороте JSON-массивов берёт один конкретный случай: 3 563 покупки за три дня дают 5 026 элементов tickets и 3 405 элементов extras. Эти два результата нельзя складывать как два числа покупок.
У источников разное зерно; высота не означает качество или полноту.
SELECT count(*) AS all_events,
       count(*) FILTER (WHERE event_name = 'app_open') AS app_opens
FROM app_events;
Часть 3. Данные в работе: история на дату и качество
В производственном отчёте «текущий уровень клиента» и «уровень в момент покупки» — разные поля. Для второго нужен исторический интервал с границами [valid_from, valid_to). Открытая запись с NULL в valid_to может соседствовать с будущим изменением; соединение по текущей записи без даты тихо перепишет прошлое. В курсе этим заняты история уровней лояльности и история тарифов.
До истории стоит проверить зерно и пропуски. В учебной базе 53 000 участников программы и 75 695 билетов, связанных с ними. Если просто соединить эти таблицы и написать count(*) AS members, участники с несколькими билетами повторятся, а без билетов могут пропасть при INNER JOIN. Правильный ответ на вопрос о числе участников — count(DISTINCT lm.member_id) на LEFT JOIN либо прямой счёт исходной таблицы. Контроль качества данных объясняет инварианты до расчёта метрики.
| Сущность | Количество | Почему не складываются |
|---|---|---|
| Участники | 53 000 | человек может не иметь билетов |
| Билеты участников | 75 695 | человек может иметь несколько билетов |
SELECT count(DISTINCT lm.member_id) AS members,
       count(tm.ticket_no) AS member_tickets
FROM loyalty_members lm
LEFT JOIN ticket_members tm ON tm.member_id = lm.member_id;
Часть 3. Продуктовые метрики и эксперименты
После технической сверки приходит вопрос о метрике. Активный пользователь — это не любая строка журнала, а клиент с конкретным квалифицирующим действием в конкретном окне. Для конверсии нужно сохранить знаменатель всех назначенных на вариант клиентов, даже если они не совершили покупку. Для retention — дождаться, чтобы у каждой когорты было достаточно времени на возвращение.
Поэтому продвинутый SQL включает не только новые операторы, но и проверки определений. Прочитайте DAU и MAU, когда метрика врёт и A/B-тест в SQL до того, как интерпретировать изменение долей. Число после запроса не становится причинным эффектом только потому, что он сложный. В модуле экспериментов курса выбор сегмента и проверка случайного назначения предшествуют выводу.
Часть 4. Задачи с собеседований проверяют рассуждение
В задачах middle-уровня редко выигрывает самый длинный запрос. Проверяют, назвали ли вы зерно, обработали ли ничьи при ранжировании, не пропали ли нули и понимаете ли ограничения источника. Например, число рейсов и число направлений различаются: 33 121 экземпляр рейса соответствует 618 уникальным парам аэропортов. Если вопрос про сеть, сначала сведите рейсы до направлений.
Собеседование удобно проходить вслух: «исходная сущность — рейс; требуемая сущность — направление; поэтому беру DISTINCT по аэропортам; затем проверяю количество». Задачи для аналитика помогают с базовой частью, вопросы по SQL — с объяснением выбора. В курс входят отдельные задачи следующей ступени, но здесь их решения не публикуются.
SELECT count(*) AS flights,
       count(DISTINCT departure_airport || '-' || arrival_airport) AS routes
FROM flights;
Часть 5. Итоговые кейсы соединяют техники
В конце курса не просят в вакууме написать оконную функцию. Два кейса собирают несколько источников: продажи и посадку на базовых таблицах, а затем запуск одностраничного оформления на событиях, эксперименте и программе лояльности. Ошибка контроля данных меняет вывод, поэтому проверка источника входит в решение, а не оформляется сноской после красивого SQL.
Как тренировка перед кейсом полезна короткая сверка. За неделю 1–7 июля в bookings есть 38 823 броней, а в app_events — 8 292 разных номера покупки. FULL JOIN оставляет 8 292 совпадения и 30 531 бронь без события в приложении. Сказать «трекер потерял 30 531 покупку» нельзя: наборы имеют разные каналы охвата. Разбор FULL JOIN показывает весь путь от определения источников до трёх зон.
Карта тем: куда идти с конкретным вопросом
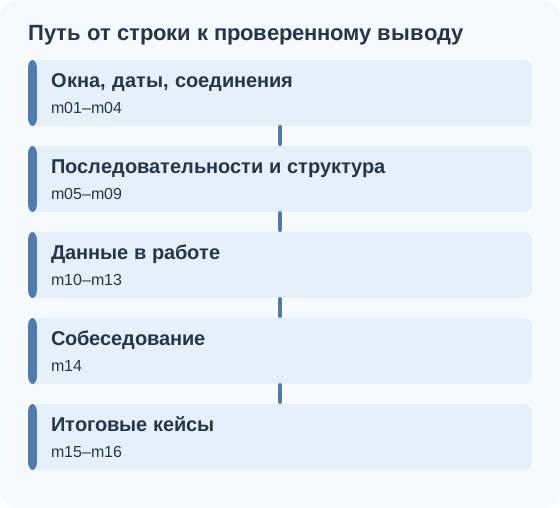
Следуйте порядку курса, если хотите цельный маршрут: окна и даты, затем последовательности и структура, далее данные в работе, задачи с собеседований и итоговые кейсы. Если задача уже стоит на работе, вход возможен по вопросу из таблицы. Но не перепрыгивайте через знание ключа, дат и зерна: рекурсия или JSON-функция не исправит неверный знаменатель.
На этой полке новые материалы дополняют существующие. Ранги с ничьими, удаление дублей событий, доли в SQL и LAG/LEAD уже раскрыты отдельно. Во второй волне добавлены ROLLUP и CUBE, PIVOT/UNPIVOT, медиана в SQL, ряд дат и 12 задач middle-уровня. Серии, сессии и SCD2 пока доступны в уроках курса; ссылки на отдельные статьи появятся после третьей волны.
| Рабочий вопрос | Приём | Где начать |
|---|---|---|
| Нужен общий итог рядом с группой | SUM(...) OVER () | окна, m01 |
| Пустые часы исчезли с графика | CROSS JOIN + LEFT JOIN | соединения, m04 |
| Повторные дни не равны неделе | ROWS / RANGE / GROUPS | рамки, m05 |
| Событие содержит список | JSON-разворот | JSON, m09 |
| Нужны подытоги по уровням | ROLLUP / GROUPING SETS | агрегация, m08 |
| Шаги события нужны в колонках | PIVOT / FILTER | развороты, m08 |
| Средняя скрывает дорогой хвост | percentile_cont / disc | перцентили, m05 |
| Пустые даты исчезли | generate_series + LEFT JOIN | ряд дат, m03 |
| Какой уровень действовал тогда | SCD2-интервал | история, m10 |
| После релиза метрика выросла | проверка события и когорты | качество и метрики, m11–m13 |
Пять ошибок, которые видны только по числам
Первая: JOIN flights b ON a.departure_airport=b.departure_airport AND a.flight_id<>b.flight_id называют уникальными парами. За 15 июля и с получасовым окном это 750 строк вместо 375, потому что пара идёт в обе стороны. Исправление — a.flight_id < b.flight_id, если порядок не важен.
Вторая: count(*) OVER (ORDER BY day ROWS BETWEEN 6 PRECEDING AND CURRENT ROW) подписывают «семь календарных дней». На первом открытии участника 605 7 июля это 2, а календарный RANGE — 4. Исправление — выбрать единицу рамки и подписать метрику соответственно.
Третья: CROSS JOIN LATERAL json_array_elements_text(...extras) используют как основу для счёта всех покупок. За 1–3 июля он оставляет лишь 2 413 покупок из 3 563; у 1 150 extras пуст. Исправление — отдельный знаменатель или LEFT LATERAL.
Четвёртая: после FULL JOIN пишут WHERE e.book_ref IS NOT NULL. Неделя 1–7 июля сжимается до 8 292 совпадений, а 30 531 бронь без записи справа исчезает. Исправление — перенести фильтр правого источника до JOIN.
Пятая: в рекурсии считают строки путей аэропортами. На третьем шаге из LED есть 1 805 простых путей, но только 7 аэропортов впервые становятся достижимыми. Исправление — сгруппировать по конечному аэропорту и взять минимальную глубину. Все пять ошибок дают правдоподобный SQL; их находят контрольным результатом, а не чтением синтаксиса.
Порядок изучения без лишних кругов
Для первой самостоятельной недели достаточно трёх контрольных задач, не совпадающих с заданиями уроков. Возьмите один день вылетов и объясните, почему половина интервала BETWEEN не подходит для timestamp. Затем сравните число строк и число разных ключей после соединения бронирований с билетами. Наконец, постройте таблицу дней с нулями для выбранного события. Если каждое число можно объяснить зерном и границей, двигайтесь к окнам и рекурсии; если нет, сначала укрепите обычные соединения и даты.
Полезно сохранять не только финальный SQL, но и три контрольные строки результата с комментариями: пограничную дату, строку без пары и строку с несколькими партнёрами. Когда источник обновится, эти примеры помогают заметить дрейф структуры. Нельзя гарантировать, что вчерашний запрос навсегда верен, но можно сделать его проверяемым без повторного чтения всех таблиц с нуля.
Начните с окон на знакомых таблицах: OVER, затем ранги, доли и соседние строки. Сразу тренируйте инвариант «столько же строк, сколько было до окна». Затем даты и соединения: полуоткрытые интервалы, пары, три зоны сверки, сетка ожидаемых комбинаций. После них рекурсия уже выглядит как повторение знакомого перехода, а не магия.
Во второй части переходите к рамкам, сериям и сессиям, затем к сложной агрегации и JSON. Там каждое преобразование явно меняет зерно: одна строка на событие превращается в строку на элемент массива или сессию. Только после этого беритесь за историю изменений и производственные метрики: интервал действия значения, поздние события, дубли и неполные когорты требуют привычки проверять слои.
Задачи с собеседований и итоговые кейсы ставьте последними, когда можете вслух объяснить ограничение результата. Курс построен именно в таком порядке по course.json; нельзя заменить этот путь заучиванием списка функций. Для конкретного рабочего затруднения возвращайтесь в нужный модуль, а остальное изучайте последовательно.
Самопроверка: с какого модуля начать
Ответы ниже намеренно короткие. Смысл не в том, чтобы вспомнить название функции, а в том, чтобы назвать проверку, которую вы сделаете до выдачи числа. Если в ответе на вопрос про FULL JOIN появляется только «поставлю FULL», но нет объяснения трёх зон и зерна ключа, начните с соединений. Если в ответе про рамку нет единицы времени, начните с окон. Если в ответе про JSON нет пустого массива, начните с структуры события.
1. После JOIN число строк выросло с 100 до 140. Какой ключ проверите первым? 2. Почему семь последних строк не обязательно составляют семь календарных дней? 3. Что означает NULL после FULL JOIN справа? 4. Как сохранить строку с пустым JSON-массивом? 5. Чем минимальная глубина отличается от числа маршрутов в рекурсии? 6. На какой момент нужен уровень клиента при исторической покупке?
Ответы: 1 — уникальность ключа на обеих сторонах и зерно соединения; начните с m04 или с кардинальности JOIN. 2 — в датах бывают пропуски и повторы; m05 и статья о рамке. 3 — строка слева не нашла пару справа; m04 и разбор сверки. 4 — LEFT JOIN LATERAL и отдельная проверка отсутствующего ключа; m09. 5 — путь может повторять конечный аэропорт, поэтому нужен min(depth) по аэропорту; m04. 6 — на дату покупки, а не сегодня; m10.
Если хотя бы первые два вопроса вызывают сомнение, вернитесь к базовым JOIN и датам. Если трудности начинаются с JSON или истории, не перечитывайте весь курс с нуля: модуль и статья по конкретному приёму дают нужный следующий шаг.
Один источник — четыре возможных зерна
Представьте отчёт о покупке билетов участниками программы лояльности. Строка app_events — событие интерфейса; одно действие может доставиться дважды. Строка bookings — бронь; она может содержать несколько билетов. Строка tickets — билет конкретного пассажира. Строка loyalty_members — человек; он может покупать повторно. Вопрос «сколько клиентов купили» требует перехода от события или билета к уникальному человеку. Вопрос «сколько продано билетов» требует обратного: сохранить несколько билетов в одной покупке.
Ошибка в зерне выглядит как ошибка в функции, хотя count, sum и avg работают правильно. Если соединить 53 000 участников с 75 695 билетами и вывести count(*) AS users, одно имя столбца не заставит базу считать людей. Нужно count(DISTINCT member_id) или отдельный слой одной строки на участника. Если после разворота массива допуслуг просуммировать сумму брони, та же покупка повторится на каждой услуге. В работе это часто дороже опечатки: SQL не падает, результат выглядит правдоподобно.
Хорошая привычка — рядом с каждым CTE в черновике записывать «одна строка = …». Затем проверять count(*) и count(DISTINCT key) до и после перехода. Если первое число выросло, а второе осталось прежним, перед вами размножение строк; оно может быть ожидаемым, но последующие агрегаты должны учитывать его. Если второе число уменьшилось, где-то пропала часть сущностей. Такую проверку легко повторить на любом рабочем наборе, даже если таблицы и домен отличаются от авиакомпании.
Как проверять сложный запрос до публикации
Не начинайте с финальной таблицы на двадцать колонок. Постройте маленький набор контрольных строк: один клиент без билетов, один с несколькими, событие с повторной доставкой, покупку с пустым массивом, два события в один день, пограничную дату. У каждого должен быть ожидаемый результат, рассчитанный руками. После этого проверяйте запрос на полном наборе и сравнивайте суммы слоёв с известными ограничениями.
Для сверки источников выпишите, какие каналы охватывает каждый. Журнал приложения и таблица всех броней могут расходиться без ошибки: во второй есть покупки через другие каналы. Для окон сформулируйте единицу: событие, календарный день или день с активностью. Для истории значений задайте момент, на который проверяется запись. Для рекурсии запишите, что считается шагом и допускается ли повторение узла. Эти предложения — часть спецификации метрики, а не комментарии к коду после его написания.
Наконец, выполните один и тот же пример в целевом диалекте. Курс использует DuckDB, но рабочая база может быть PostgreSQL: различия JSON-функций, интервальных выражений, псевдонимов и целочисленного деления не видны по одному скриншоту результата. Статьи кластера показывают PostgreSQL как основной синтаксис и называют проверенные отличия DuckDB. Если запрос ведёт в другой движок, повторите контрольные строки там до того, как перенести в него весь отчёт.
Частые вопросы
Что считается продвинутым SQL для аналитика? Задачи, где надо управлять зерном, последовательностью, временем и качеством источника: окна, рекурсия, JSON, история изменений, сверка нескольких наборов и проверка метрик.
Сначала окна или рекурсия? Сначала окна и устойчивый порядок строк. Рекурсия опирается на понимание шага, ограничения и размера промежуточного результата; в курсе она идёт после дат и соединений.
Можно ли учить всё на одном DuckDB? В тренажёре задания выполняются в DuckDB, а статьи показывают PostgreSQL-совместимый SQL и называют различия. Проверяйте диалект функций JSON, дат и операторов, прежде чем переносить запрос в рабочую БД.
Где взять данные для практики? Уроки курса используют расширенную учебную базу авиакомпании: базовые таблицы рейсов и бронирований плюс программа лояльности, события приложения и эксперимент. У каждой задачи есть редактор и проверка результата.
Сложный запрос гарантирует верную метрику? Нет. Пример с 30 531 бронью без события показывает, что даже точная сверка не доказывает потерю событий без знания охвата источников.
Материалы по теме
Рамка окна в SQL: ROWS BETWEEN, RANGE и GROUPS на примерах
ROWS, RANGE и GROUPS на восьми открытиях приложения: три разных ответа, рамка по умолчанию и граница pandas rolling против SQL RANGE.
SQL-задачи с собеседования middle-аналитика: 12 разборов
Двенадцать задач SQL на реальные данные: вторая цена, медиана, возвращение, серии, сессии, SCD2, подытоги, сверка и уникальные клиенты. Ответы и частые ошибки.
FULL JOIN и CROSS JOIN в SQL: сверка и сетка без пропусков
FULL JOIN и CROSS JOIN для сверки броней и заполнения пустых часов: запросы PostgreSQL и pandas, три зоны результата, дубли и ловушка пустого ключа.