Экспоненциальное (показательное) распределение: формула и примеры
Экспоненциальное (показательное) распределение: формула, среднее 1/λ, отсутствие памяти, связь с Пуассоном. Проверка на данных в SQL и Python и сравнение с равномерным.
Содержание статьи
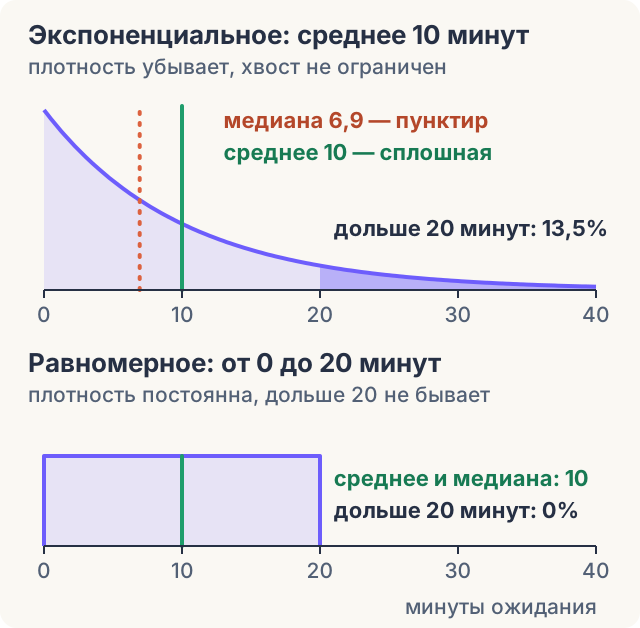
Экспоненциальное (показательное) распределение описывает время ожидания до следующего события, когда события происходят независимо и с постоянной интенсивностью λ. Плотность — f(x) = λ·e^(−λx), функция распределения — F(x) = 1 − e^(−λx), среднее и стандартное отклонение равны 1/λ, дисперсия — 1/λ², медиана — ln 2 / λ. Пример: заявки приходят в среднем раз в 10 минут, λ = 0,1 в минуту; вероятность ждать следующую дольше 20 минут — e^(−2) ≈ 13,5%. Дальше — связь с распределением Пуассона, отсутствие памяти, проверка на учебной базе, где поток визитов оказался похож на экспоненциальный, а паузы одного пользователя — нет, и раздел о равномерном распределении.
Что такое экспоненциальное распределение простыми словами
Оно отвечает на вопрос, сколько ждать следующего события — заявки, визита, сбоя, — если события приходят по одному, независимо друг от друга и в среднем с одной частотой. Параметр один: интенсивность λ, среднее число событий в единицу времени. Среднее время ожидания, оно же математическое ожидание, — обратная величина, 1/λ. «Показательное» и «экспоненциальное» — два названия одного распределения.
Плотность f(x) = λ·e^(−λx) максимальна в нуле и убывает: короткие ожидания встречаются чаще длинных. Функция распределения F(x) — вероятность дождаться события не позже x. Считать удобнее через обратную вероятность, ждать дольше x: P(X > x) = 1 − F(x) = e^(−λx), то есть e в степени «минус x, делённое на среднее».
Заявки приходят в среднем раз в 10 минут. Ждать дольше 20 минут придётся с вероятностью e^(−20/10) = e^(−2) ≈ 0,135. Медиана — 10 · ln 2 ≈ 6,9 минуты: половина ожиданий короче. Меньше среднего оказывается 1 − e^(−1) ≈ 63% ожиданий, так что «в среднем 10 минут» не означает «обычно 10 минут».
Стандартное отклонение равно среднему, поэтому коэффициент вариации (стандартное отклонение, делённое на среднее) здесь всегда 100%. Отсюда первая быстрая проверка данных: сравнить среднее со стандартным отклонением.
f(x) = λ·e^(−λx); F(x) = 1 − e^(−λx); E(X) = 1/λ; D(X) = 1/λ²; σ = 1/λ; медиана = ln 2 / λx ≥ 0 — время ожидания, λ > 0 — интенсивность: среднее число событий в единицу времени.
| x, минут | P(X > x) = e^(−x/10) |
|---|---|
| 5 | 60,7% |
| 6,9 (медиана) | 50% |
| 10 (среднее) | 36,8% |
| 20 | 13,5% |
| 30 | 5,0% |
Как экспоненциальное распределение связано с распределением Пуассона
Это два взгляда на один поток событий. Распределение Пуассона считает, сколько событий попало в интервал, экспоненциальное измеряет промежутки между соседними событиями. Если промежутки независимы и экспоненциальны со средним 1/λ, число событий за единицу времени распределено по Пуассону со средним λ, а за интервал длины t — со средним λt. Обратное верно в усиленной форме: если числа событий в любых непересекающихся интервалах независимы и распределены по Пуассону, промежутки между событиями экспоненциальны.
Проверим симуляцией: 600 000 интервалов со средним 10 минут. Среднее и стандартное отклонение — по 9,99, медиана 6,92; короче 10 минут 63,3% интервалов, длиннее 20 — 13,5%. Теперь разложим события по часам: в 99 881 полном часе в среднем 6,01 события при дисперсии 6,01. У распределения Пуассона среднее и дисперсия равны — так и вышло.
Условия у двух распределений общие: события независимы, приходят по одному, интенсивность не меняется. Ночью заявок меньше, чем днём, — значит, одной λ на сутки нет, и модель применяют внутри окна, где поток ровный.
import numpy as np

rng = np.random.default_rng(42)
gaps = rng.exponential(scale=10, size=600_000)   # интервалы в минутах; scale — это среднее 1/λ
print(round(gaps.mean(), 2), round(gaps.std(), 2), round(np.median(gaps), 2))
print(round((gaps < 10).mean(), 3), round((gaps > 20).mean(), 3))
# 9.99 9.99 6.92
# 0.633 0.135

moments = gaps.cumsum()                           # моменты событий на оси времени
per_hour = np.bincount((moments // 60).astype(int))[:-1]   # событий в каждом полном часе
print(len(per_hour), round(per_hour.mean(), 2), round(per_hour.var(), 2))
# 99881 6.01 6.01

waited = gaps[gaps > 10]                          # уже прождали 10 минут
print(round((gaps > 10).mean(), 3), round((waited > 20).mean(), 3))
# 0.367 0.368Что значит «отсутствие памяти»
Формула свойства: P(X > s + t | X > s) = P(X > t). Словами: если вы уже прождали s минут, оставшееся ожидание распределено так же, как у только что пришедшего. Прошедшее время ничего не сообщает о будущем.
В симуляции выше дольше 10 минут длятся 36,7% интервалов. Возьмём только их, то есть тех, кто уже прождал 10 минут: ещё 10 минут продлятся 36,8%. Доля та же.
Среди непрерывных распределений таким свойством обладает только экспоненциальное. На практике оно выполняется редко. Деталь изнашивается: чем дольше она работает, тем вероятнее поломка. Пользователь, наоборот, «остывает»: чем дольше его нет, тем меньше шансов, что он вернётся завтра. Ниже это видно на данных.
Похожи ли интервалы в учебной базе на экспоненциальные
В учебной базе продукта «Маяк» время событий записано с точностью до минуты. Возьмём две величины. Первая — поток визитов: интервалы между соседними открытиями приложения (app_open) любых пользователей в рабочие часы, с 10:00 до 17:00, в будни 8–12 июня 2026 года; интервалы считаем внутри дня, чтобы в них не попала ночь. Неделя взята из начала периода: средний интервал там 5,5 минуты, заметно длиннее минуты, с точностью до которой записано время. На любой из 13 рабочих недель отношение стандартного отклонения к среднему остаётся между 0,96 и 1,07, но к концу августа интервал сжимается до 1,25 минуты, 31% интервалов равны нулю, и медиану с долями хвоста начинает определять округление. Вторая — паузы между соседними действиями одного и того же пользователя за весь период, в часах.
Параметр оценивают по данным как λ = 1 / среднее. Три проверки обходятся без графиков: стандартное отклонение против среднего, медиана против ln 2 · среднее, доля значений выше одного, двух и трёх средних против e⁻¹, e⁻² и e⁻³.
Поток визитов близок к модели по всем трём: 374 интервала, среднее 5,52 минуты, стандартное отклонение 5,85, медиана 4 при расчётных 3,83, доли выше одного, двух и трёх средних отличаются от теоретических не больше чем на 2,3 процентного пункта. Отношение стандартного отклонения к среднему, 1,06, — в пределах шума: у экспоненциальных выборок такого объёма оно в 95% случаев лежит между 0,90 и 1,10. Паузы пользователя расходятся с моделью по всем трём проверкам: стандартное отклонение 130,83 часа при среднем 95,81, медиана 47 вместо 66,4, дольше трёх средних длятся 8,1% пауз вместо 5%.
Разница объяснима. Визиты разных людей почти не связаны между собой: пользователь открывает приложение не чаще раза в день, и соседние визиты в потоке принадлежат разным людям. Паузы одного человека зависят от его привычек. Так устроена учебная база; в рабочем продукте независимость потока нарушают рассылки, релизы и сбои.
| Показатель | Экспоненциальное | Поток визитов | Паузы пользователя |
|---|---|---|---|
| Стандартное отклонение / среднее | 1 | 1,06 | 1,37 |
| Медиана / среднее | 0,69 | 0,72 | 0,49 |
| Доля выше среднего | 36,8% | 34,5% | 31,5% |
| Доля выше двух средних | 13,5% | 14,4% | 15,4% |
| Доля выше трёх средних | 5,0% | 5,6% | 8,1% |
WITH visits AS (
  SELECT CAST(event_time AS date) AS day, event_time
  FROM events
  WHERE event_name = 'app_open'
    AND event_time >= TIMESTAMP '2026-06-08'
    AND event_time <  TIMESTAMP '2026-06-13'
    AND EXTRACT(hour FROM event_time) BETWEEN 10 AND 16
),
gaps AS (
  SELECT 'поток визитов, минуты' AS series,
    EXTRACT(epoch FROM event_time - LAG(event_time) OVER (
      PARTITION BY day ORDER BY event_time)) / 60 AS gap
  FROM visits
  UNION ALL
  SELECT 'паузы пользователя, часы',
    EXTRACT(epoch FROM event_time - LAG(event_time) OVER (
      PARTITION BY user_id ORDER BY event_time)) / 3600
  FROM events
),
summary AS (
  SELECT series, COUNT(*) AS n, AVG(gap) AS mean_gap, STDDEV_SAMP(gap) AS sd_gap,
    PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY gap) AS median_gap
  FROM gaps
  WHERE gap IS NOT NULL
  GROUP BY series
)
SELECT s.series, s.n,
  ROUND(CAST(s.mean_gap AS numeric), 2) AS mean_gap,
  ROUND(CAST(s.sd_gap AS numeric), 2) AS sd_gap,
  ROUND(CAST(s.median_gap AS numeric), 2) AS median_gap,
  ROUND(100.0 * COUNT(*) FILTER (WHERE g.gap > s.mean_gap) / s.n, 1) AS over_1_mean,
  ROUND(100.0 * COUNT(*) FILTER (WHERE g.gap > 2 * s.mean_gap) / s.n, 1) AS over_2_means,
  ROUND(100.0 * COUNT(*) FILTER (WHERE g.gap > 3 * s.mean_gap) / s.n, 1) AS over_3_means
FROM summary s
JOIN gaps g ON g.series = s.series
GROUP BY s.series, s.n, s.mean_gap, s.sd_gap, s.median_gap
ORDER BY s.n;
-- поток визитов, минуты       374   5.52    5.85   4.00  34.5  14.4  5.6
-- паузы пользователя, часы  30728  95.81  130.83  47.00  31.5  15.4  8.1
Можно ли доверять критерию Колмогорова — Смирнова
Критерий Колмогорова — Смирнова измеряет наибольшее расстояние D между накопленной долей значений в данных и функцией распределения модели. Маленькое p-value говорит, что при верной модели такое расстояние маловероятно. В Python модель задаёт scipy.stats.expon, и здесь легко ошибиться: параметр называется scale и равен среднему 1/λ, а первый позиционный аргумент — loc, сдвиг. Запись expon(1 / mean) вместо expon(scale=mean) даёт для доли выше двух средних 0,00002 вместо 0,1353.
Для потока визитов D = 0,097 и p = 0,0016: формально экспоненциальность отвергнута. Но время записано с точностью до минуты, и 33 интервала из 374 равны нулю, чего у непрерывной величины не бывает. Спросим критерий о заведомо экспоненциальных интервалах, записанных так же: в 2 000 симуляций медианное D — 0,095, и в 40% случаев оно не меньше нашего. Такое расхождение округление времени даёт и само по себе: отличия формы от экспоненциальной критерий не показал.
Две оговорки нужны всегда. Первая: стандартное p-value рассчитано на модель, заданную заранее. Когда λ оценена по тем же данным, кривая подогнана к ним и p завышено — это поправка Лиллиефорса: на точных экспоненциальных выборках того же объёма p ниже 0,05 получилось в 0,6% симуляций вместо 5%. Честное p дают симуляции: в блоке к этому разделу λ переоценивается на каждой выборке, поэтому доля 40% учитывает и подгонку, и округление. Вторая: на больших выборках значимым становится любое отличие. Для 30 728 пауз D = 0,195, но при таком объёме на уровне 0,05 модель отвергается уже при D = 0,008. Смотрите на размер расхождения.
Поток визитов 8–12 июня, 374 интервала. Ожидание — 374 · вероятность попасть в группу при среднем 5,52 минуты; границы групп взяты на половинах минут, потому что время записано с точностью до минуты.
import numpy as np
from scipy import stats

# интервалы между визитами в минутах и сколько раз каждый встретился (поток 8–12 июня)
minutes = np.array([0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15,
                    16, 17, 18, 19, 20, 21, 22, 23, 24, 27, 28, 29, 31, 38])
times = np.array([33, 64, 53, 36, 32, 27, 18, 15, 16, 8, 8, 10, 7, 10, 4, 9,
                  3, 3, 4, 1, 3, 1, 1, 2, 1, 1, 1, 1, 1, 1])
x = np.repeat(minutes, times)
mean = x.mean()

model = stats.expon(scale=mean)              # scale = 1/λ, то есть среднее
print(len(x), round(mean, 2), round(model.ppf(0.5), 2), round(model.sf(2 * mean), 4))
print(f"{stats.expon(1 / mean).sf(2 * mean):.5f}")   # ошибка: первый аргумент — loc (сдвиг)
# 374 5.52 3.83 0.1353
# 0.00002

ks = stats.kstest(x, model.cdf)
print(round(ks.statistic, 4), round(ks.pvalue, 4))
# 0.0972 0.0016

# тот же критерий на заведомо экспоненциальных интервалах, записанных с точностью до минуты
rng = np.random.default_rng(42)
d_sim = []
for _ in range(2000):
    moments = np.floor(rng.random() + rng.exponential(mean, size=len(x) + 1).cumsum())
    g = np.diff(moments)
    d_sim.append(stats.kstest(g, stats.expon(scale=g.mean()).cdf).statistic)
print(round(np.median(d_sim), 3), round(np.mean(np.array(d_sim) >= ks.statistic), 2))
# 0.095 0.4
Почему паузы одного пользователя не экспоненциальные
Отсутствие памяти проверяется напрямую. Будь паузы экспоненциальными со средним 95,81 часа, любая из них — и только что начавшаяся, и длящаяся две недели — продлилась бы ещё 48 часов с вероятностью e^(−48/95,81) = 60,6%.
В данных иначе. Из всех пауз дольше 48 часов длятся 47,0%, но в этом числе 18,1% пауз внутри одного визита; среди пауз между визитами — 57,4%. Из тех, что уже длятся двое суток, ещё двое суток продлятся 64,8%, из длящихся неделю — 71,6%, из длящихся две недели — 75,1%. Чем дольше пользователя нет, тем меньше вероятность, что он вернётся в ближайшие два дня. Риск — вероятность, что событие случится в ближайшее время, если до сих пор не случилось; здесь он убывает.
В расчёте только закрытые паузы. За пользователем база следит меньше 60 дней после регистрации и не дальше 30 августа, поэтому последняя пауза каждого из 4 613 человек оборвана — это 13% всех пауз, и они длиннее закрытых. Доли из-за этого занижены: с учётом оборванных пауз по методу Каплана — Мейера выходит 53% для всех пауз и 71, 79 и 83% для длящихся двое суток, неделю и две. Вывод тот же, только резче.
Причин две, и по одной форме распределения их не разделить — нужны разрезы. Первая — смесь: люди возвращаются с разной частотой, и среди длинных пауз копятся редкие посетители (средняя пауза между визитами у пришедших по рекомендации — 104 часа, из платного поиска — 140). Вторая — интерес угасает у каждого: паузы между визитами, начатые в первую неделю после регистрации, длятся в среднем 81 час, на третьей-четвёртой неделе — 173. К этому добавляется ещё одна смесь: 18,1% пауз короче 12 часов — это действия внутри одного визита, их медиана — 1 час; остальные паузы начинаются от 18 часов.
График сравнивает перцентили пауз (P90 — значение, ниже которого лежат 90% наблюдений) с перцентилями экспоненциального распределения с тем же средним. До P75 данные ниже модели, в хвосте — выше: P99 равен 625 часам против 441.
30 728 пауз, среднее 95,81 часа. Перцентиль модели — −95,81 · ln(1 − p).
WITH gaps AS (
  SELECT EXTRACT(epoch FROM event_time - LAG(event_time) OVER (
    PARTITION BY user_id ORDER BY event_time)) / 3600 AS gap_hours
  FROM events
),
model AS (
  SELECT AVG(gap_hours) AS mean_hours FROM gaps
),
steps AS (
  SELECT 0 AS waited UNION ALL SELECT 48 UNION ALL SELECT 168 UNION ALL SELECT 336
)
SELECT s.waited,
  COUNT(*) FILTER (WHERE g.gap_hours > s.waited) AS still_open,
  ROUND(100.0 * COUNT(*) FILTER (WHERE g.gap_hours > s.waited + 48)
    / COUNT(*) FILTER (WHERE g.gap_hours > s.waited), 1) AS plus_48h_pct,
  ROUND(CAST(100 * EXP(-48 / MAX(m.mean_hours)) AS numeric), 1) AS expon_pct
FROM steps s
CROSS JOIN gaps g
CROSS JOIN model m
WHERE g.gap_hours IS NOT NULL
GROUP BY s.waited
ORDER BY s.waited;
-- уже длится, ч | таких пауз | продлятся ещё 48 ч, % | по экспоненциальной модели, %
--   0  30728  47.0  60.6
--  48  14439  64.8  60.6
-- 168   5415  71.6  60.6
-- 336 1801 75.1 60.6Что такое равномерное распределение и чем оно отличается от экспоненциального
У равномерного распределения вероятность попасть в любой кусок отрезка от a до b пропорциональна длине куска. Плотность постоянна и равна 1/(b − a), среднее — середина отрезка (a + b)/2, дисперсия — (b − a)²/12.
Пример: поезд приходит ровно раз в 20 минут, а вы выходите на платформу в случайный момент. Ожидание равномерно на отрезке от 0 до 20 минут: среднее 10, стандартное отклонение 20/√12 ≈ 5,8, ждать дольше 15 минут придётся в 25% случаев, дольше 20 — никогда. У экспоненциального ожидания с тем же средним стандартное отклонение в 1,7 раза больше, и 13,5% ожиданий длиннее 20 минут.
Дискретный вариант — игральный кубик: шесть значений с вероятностью 1/6 каждое, среднее 3,5, дисперсия 35/12 ≈ 2,92.
Аналитик встречает равномерное распределение в трёх местах. Генератор случайных чисел: random() в PostgreSQL и DuckDB, rng.random() в NumPy возвращают равномерное число от 0 до 1. Разбиение на группы A/B-теста: хеш-функция превращает идентификатор пользователя в число, похожее на случайное равномерное, и по порогу пользователь попадает в вариант. P-значения: когда различий на самом деле нет, они распределены равномерно. В симуляции 10 000 сравнений двух одинаковых групп p ниже 0,05 получилось в 5,2% случаев, ниже 0,5 — в 50,4%.
f(x) = 1/(b − a); F(x) = (x − a)/(b − a); E(X) = (a + b)/2; D(X) = (b − a)²/12a ≤ x ≤ b, вне отрезка плотность равна нулю. Для n равновероятных целых значений подряд дисперсия равна (n² − 1)/12.
| Свойство | Экспоненциальное, λ = 0,1 | Равномерное на [0, 20] |
|---|---|---|
| Что описывает | время до события при постоянной интенсивности | значение, равновероятное на отрезке |
| Плотность | 0,1 · e^(−0,1x), убывает | 1/20, постоянная |
| Среднее | 10 | 10 |
| Медиана | 6,9 | 10 |
| Стандартное отклонение | 10 | 5,8 |
| P(X > 15) | 22,3% | 25% |
| P(X > 20) | 13,5% | 0% |
| Наибольшее значение | не ограничено | 20 |
Как проверить равномерность и получить экспоненциальное из равномерного
Равномерность по ячейкам проверяют критерием хи-квадрат: число наблюдений в каждой ячейке сравнивают с ожидаемым «поровну». Статистика — сумма (факт − ожидание)² / ожидание по всем ячейкам; чем она больше, тем хуже согласие.
Первая проверка — дни от регистрации до первой оплаты. Берём зрелые регистрации, до 9 августа включительно: у них до конца выгрузки прошло не меньше 20 дней. 756 оплат легли на 18 значений, от 3 до 20 дней: в ячейке от 28 до 51 оплаты при ожидаемых 42, χ² = 15,5, p = 0,56. Среднее 11,63 дня при теоретических (3 + 20)/2 = 11,5, дисперсия 26,89 (с делением на n; с n − 1 — 26,92) при теоретических (18² − 1)/12 = 26,92. Равномерность не отвергнута; p считают по распределению хи-квадрат с числом степеней свободы «ячеек минус один». Это свойство учебного генератора: в рабочих продуктах оплаты обычно сгущаются в первые дни или у конца пробного периода.
Варианты эксперимента — 1 541 и 1 527 участников, p = 0,80; последняя цифра user_id у участников — p = 0,79. А у всех 4 613 пользователей χ² = 0,005 и p = 1: идентификаторы выданы подряд, от 1 до 4 613, и остатки от деления на 10 равны по построению. Такое согласие ничего не говорит о случайности разбиения — это тождество.
Обратная задача — получить экспоненциальную величину из равномерной: x = −ln(1 − u)/λ, где u равномерно на [0, 1). Формула решает уравнение F(x) = u относительно x. В блоке ниже 200 000 таких значений при λ = 0,1 дают среднее 10,0, медиану 6,93 и 13,6% значений выше 20.
WITH cells AS (
  SELECT 'дни до первой оплаты' AS check_name,
    CAST(p.paid_at - u.signup_date AS varchar) AS cell, COUNT(*) AS cnt
  FROM payments p
  JOIN users u ON u.user_id = p.user_id
  WHERE p.payment_type = 'first' AND u.signup_date < DATE '2026-08-10'
  GROUP BY p.paid_at - u.signup_date
  UNION ALL
  SELECT 'вариант эксперимента', variant, COUNT(*)
  FROM experiment_exposures
  GROUP BY variant
  UNION ALL
  SELECT 'user_id % 10, участники теста', CAST(user_id % 10 AS varchar), COUNT(*)
  FROM experiment_exposures
  GROUP BY user_id % 10
  UNION ALL
  SELECT 'user_id % 10, все пользователи', CAST(user_id % 10 AS varchar), COUNT(*)
  FROM users
  GROUP BY user_id % 10
),
expected AS (
  SELECT check_name, cnt,
    1.0 * SUM(cnt) OVER (PARTITION BY check_name)
      / COUNT(*) OVER (PARTITION BY check_name) AS expected_cnt
  FROM cells
)
SELECT check_name, COUNT(*) AS cells, SUM(cnt) AS n,
  MIN(cnt) AS min_cnt, MAX(cnt) AS max_cnt,
  ROUND(MAX(expected_cnt), 1) AS expected_cnt,
  ROUND(SUM((cnt - expected_cnt) * (cnt - expected_cnt) / expected_cnt), 3) AS chi2
FROM expected
GROUP BY check_name
ORDER BY cells DESC, n;
-- дни до первой оплаты            18   756    28    51    42.0  15.524
-- user_id % 10, участники теста   10  3068   285   325   306.8   5.475
-- user_id % 10, все пользователи  10  4613   461   462   461.3   0.005
-- вариант эксперимента 2 3068 1527 1541 1534.0 0.064import numpy as np
from scipy import stats
rng = np.random.default_rng(42)
u = rng.random(200_000) # равномерное на [0, 1)
print(round(u.mean(), 3), round(u.var(), 4), round(1 / 12, 4))
# 0.5 0.0833 0.0833
x = -np.log(1 - u) / 0.1 # λ = 0,1: экспоненциальное со средним 10
print(round(x.mean(), 2), round(np.median(x), 2), round((x > 20).mean(), 3))
# 10.0 6.93 0.136
# p-value для четырёх строк запроса: статистика и число ячеек минус один
chi2 = np.array([15.524, 5.475, 0.005, 0.064])
print(stats.chi2.sf(chi2, df=[17, 9, 9, 1]).round(3))
# [0.558 0.791 1. 0.8 ]Где экспоненциальная модель обманывает
Формула короткая, поэтому её подставляют к любому «времени до события». Четыре ситуации, в которых она даёт неверное число.
- Среднее принимают за типичное. У экспоненциального распределения 63% значений меньше среднего, у пауз из учебной базы — 68,5%: среднее 95,81 часа при медиане 47. На вопрос «сколько обычно ждут» отвечает медиана.
- Цензурирование: время до события известно только у тех, с кем оно уже случилось. Выгрузка обрывается 30 августа. Среди зарегистрированных с 20 августа оплатили 27 человек, в среднем через 5,33 дня, а у зрелых регистраций среднее 11,63: медленные плательщики в данные ещё не попали. С паузами то же: у каждого из 4 613 пользователей последняя пауза не закрыта и в расчёт не вошла, поэтому среднее 95,81 часа — оценка снизу: с оборванными паузами как нижними границами выходит не меньше 110 часов.
- Смесь групп с разной интенсивностью. Половина интервалов со средним 5 минут и половина со средним 50 дают стандартное отклонение в 1,53 раза больше среднего и 9,6% значений выше трёх средних вместо 5%. Каждая группа экспоненциальна, смесь — нет.
- Интенсивность меняется во времени. Даже внутри окна 8–12 июня визитов в рабочие часы было 56 в понедельник и 85 в пятницу. За квартал средний интервал в тех же часах сократился с 10,1 минуты в первую неделю июня до 1,25 в последнюю неделю августа: одной λ на весь период нет.
Частые вопросы
Показательное и экспоненциальное распределение — это одно и то же? Да, два названия одного распределения с плотностью λ·e^(−λx).
Чему равны математическое ожидание и дисперсия экспоненциального распределения? Ожидание — 1/λ, дисперсия — 1/λ², стандартное отклонение — 1/λ. При λ = 0,1 в минуту это 10 минут, 100 минут² и 10 минут.
Как посчитать в Excel? =ЭКСП.РАСП(20;0,1;ИСТИНА) возвращает F(20) = 0,8647 — вероятность дождаться за 20 минут. Вероятность ждать дольше — =1-ЭКСП.РАСП(20;0,1;ИСТИНА), то есть 0,1353. Второй аргумент — λ, в отличие от scale в Python; с ЛОЖЬ в третьем аргументе функция вернёт плотность.
Может ли плотность быть больше единицы? Да. Плотность — не вероятность: при λ = 10 в нуле она равна 10. Вероятность — площадь под кривой, и она не больше 1.
Чем экспоненциальное распределение отличается от нормального? Оно несимметрично: значения неотрицательны, плотность максимальна в нуле, хвост тянется вправо, медиана составляет 69% среднего. У нормального среднее и медиана совпадают.
Что попробовать на учебной базе
SQL-блоки статьи можно выполнить в песочнице симулятора SQL-аналитика на этой же базе. Сдвиньте окно первого запроса на следующую рабочую неделю, 15–19 июня. Должно получиться 522 интервала со средним 3,97 минуты и стандартным отклонением 3,84; выше двух средних — 15,5% интервалов, выше трёх — 4,0%. Объясните, почему средний интервал стал короче, а отношение стандартного отклонения к среднему осталось около единицы.
Материалы по теме
Математическое ожидание: что это, формула и примеры
Математическое ожидание простыми словами: среднее, к которому результат сходится в долгую. Формула, пример на кубике, расчёт в SQL и Python, свойства и ловушки.
Коэффициент вариации: формула, расчёт и как читать
Коэффициент вариации — стандартное отклонение в процентах от среднего. Формула, пример на пяти числах, расчёт в SQL, Python и Excel, порог 33% для НМЦК и ловушки.
Линейная регрессия простыми словами: уравнение, наклон и R²
Что такое регрессия и линейная регрессия: уравнение y = a + b·x, наклон, свободный член и R². Пример на пяти точках, расчёт в SQL, Python и Excel, остатки, прогноз и ловушки.