Анализ выживаемости: Каплан — Мейер и удержание пользователей
Кривая Каплана — Мейера на условных данных: цензурирование, число под риском, Python с lifelines и удержание подписчиков без ошибки незрелых когорт.
Содержание статьи
Вы сравниваете удержание подписчиков, пришедших в разные недели. У старой когорты уже накопились отмены, а новая почти вся выглядит активной: она просто не успела прожить тот же срок. Удалить новых пользователей — потерять данные; считать их бессрочно удержанными — исказить результат. Анализ выживаемости учитывает незавершённые наблюдения. На синтетическом медицинском примере разберём кривую Каплана — Мейера, а затем построим её для времени до первого прекращения подписки.
Короткий ответ: когда нужен Каплан — Мейер
- Метод оценивает вероятность не испытать определённое событие к моменту t, используя время наблюдения и признак, произошло ли событие.
- Правое цензурирование означает, что до известного момента события не было, а его дальнейшее время неизвестно. Это не событие и не бесконечное удержание.
- Кривая падает только в моменты событий. Знаменатель каждого падения — участники, которые непосредственно перед этим моментом ещё находятся под риском.
- Для продуктового retention сначала определите событие ухода. Непрерывная подписка до первого прекращения и возвращение в приложение на конкретный день — разные метрики.
- Показывайте число под риском, причины цензурирования и неопределённость. Длинный плоский хвост на нескольких наблюдениях не обещает устойчивого удержания.
Три определения до первой формулы
Слово «выживаемость» описывает математическую задачу времени до события. Событием может быть повторное обращение, поломка устройства, отмена доступа или завершение сделки. Увеличение времени не обязательно хорошо: долгое ожидание успешной активации — другой управленческий смысл, чем долгое сохранение оплаченного доступа. Подпись оси должна называть конкретный исход, чтобы форма кривой не провоцировала неверную оценку результата.
Первое — начало отсчёта. В медицинском примере это включение в наблюдение, в продукте — начало первой оплаченной подписки. Нельзя начинать часы у одних с регистрации, у других с оплаты, а у третьих с первого события в доступном логе. Даже одинаковые календарные даты тогда соответствуют разному возрасту процесса. Выберите происхождение времени и восстановите его для каждой единицы.
Второе — событие. Мы будем считать первое повторное обращение в условном медицинском наборе и первое прекращение оплаченного доступа в продукте. Последующие события не добавляются в тот же анализ как независимые участники. Если вас интересуют повторные циклы, понадобится отдельная модель или иной дизайн таблицы. Простое копирование строки на каждый цикл меняет зависимость наблюдений.
Третье — конец наблюдения. Он может наступить из-за события, административной даты среза или потери связи. В первых двух случаях источник обычно понятен, в третьем причина может быть связана с интересующим исходом. В таблице храните время и отдельный индикатор: event = 1 для наблюдённого события, event = 0 для цензурирования. Значение ноль не означает «события никогда не произойдёт».
Восемь условных участников
Наши синтетические длительности в днях: 2, 3, 4, 4, 6, 7, 8, 10. Событие наблюдалось на днях 2, 4, 6 и 7; остальные строки цензурированы. Участник, цензурированный на третьем дне, точно не имел события до этой точки, но мы не знаем его состояние на седьмом. Его первые дни полезны для оценки ранней части кривой, дальнейшие он не поддерживает.
Две строки на четвёртом дне намеренно имеют разные статусы. В используемом соглашении событие учитывается среди всех, кто наблюдался непосредственно до этого времени, затем цензурированный участник исключается из следующих наборов риска. Если время округляется до суток, фактический порядок внутри дня может быть неизвестен. Зафиксируйте соглашение и по возможности используйте доступные более точные метки.
Этот маленький набор позволяет проверить алгоритм вручную. Он не является случайной клинической выборкой и не доказывает никаких медицинских закономерностей. Интервалы и тесты на таком наборе служат демонстрацией работы процедуры. Для реального исследования нужны содержательный протокол, причины выбытия, независимость единиц и достаточное количество событий, а не только достаточное количество записей.
| ID | Дни | event |
|---|---|---|
| 1 | 2 | 1 |
| 2 | 3 | 0 |
| 3 | 4 | 1 |
| 4 | 4 | 0 |
| 5 | 6 | 1 |
| 6 | 7 | 1 |
| 7 | 8 | 0 |
| 8 | 10 | 0 |
Как получаются ступени
Непосредственно перед вторым днём под риском восемь участников, событие одно. Условная вероятность пройти этот момент без события оценивается как 7/8, поэтому S(2) = 0,875. На третьем дне события нет, только цензурирование: высота остаётся прежней, но для следующего сравнения доступно меньше участников. Цензурирование влияет на будущие знаменатели, не создавая собственного падения.
Перед четвёртым днём под риском шесть человек. Одно событие даёт множитель 5/6, и S(4) = 0,875 × 5/6 ≈ 0,7292. После события и цензурирования остаются четыре. На шестом дне множитель 3/4 даёт 0,546875; на седьмом множитель 2/3 даёт примерно 0,3646. Последующие цензурирования не снижают высоту.
Общая формула перемножает 1 − dⱼ/nⱼ по временам событий не позже t. Здесь dⱼ — число событий в момент j, nⱼ — число под риском прямо перед ним. Если несколько событий совпали по времени, учитывайте их совместно соответствующим множителем. Нельзя вместо nⱼ всегда брать первоначальный размер когорты: так вы игнорируете, кто вообще наблюдался в нужном возрасте.
| День | Под риском | События | Цензурирования | S(t) |
|---|---|---|---|---|
| 2 | 8 | 1 | 0 | 0,8750 |
| 3 | 7 | 0 | 1 | 0,8750 |
| 4 | 6 | 1 | 1 | 0,7292 |
| 6 | 4 | 1 | 0 | 0,5469 |
| 7 | 3 | 1 | 0 | 0,3646 |
| 8 | 2 | 0 | 1 | 0,3646 |
| 10 | 1 | 0 | 1 | 0,3646 |
Почему доля без события даёт другой ответ
В исходной таблице четыре события на восемь участников, поэтому наивная доля без события равна 50%. Каплан — Мейер после седьмого дня даёт около 36,46%. Расхождение возникает потому, что простое деление считает цензурированных как известных участников без события на всём горизонте. На самом деле часть из них перестала наблюдаться раньше, и их поздний исход не установлен.
Противоположная ошибка — выбросить все цензурированные строки. Тогда останутся только люди с зарегистрированным событием, и оценка времени окажется смещённой в сторону ранних исходов. Такой расчёт отвечает на вопрос о наблюдённых событиях в отобранной подгруппе, а не о времени до события у исходной когорты. В обоих случаях проблема появляется до запуска статистической функции.
Каплан — Мейер использует доступные части наблюдений, но не узнаёт скрытые исходы. Его интерпретация опирается на предположение о цензурировании: оставшиеся под наблюдением должны представлять дальнейший процесс для выбывших в соответствующем смысле. Если это неверно, аккуратная ступенчатая линия останется смещённой оценкой. Красивый график не заменяет объяснение причин потерь.
Python: ручной расчёт и lifelines
Код воспроизводит таблицу событий вручную и проверяет каждую высоту через KaplanMeierFitter. Потребуются NumPy и lifelines; для следующего графика — Matplotlib. Сравнение двух реализаций здесь полезнее отдельного теста форматирования: оно проверяет именно знаменатели, обработку совпавших времён и последовательное произведение, от которых зависит вывод.
Медиана времени до события в примере равна семи дням: это первый момент, когда оценка S(t) становится не выше 0,5. Она не равна медиане длительностей в исходном массиве, потому что часть длительностей — лишь границы наблюдения. Если кривая вообще не достигает половины, медиана не достигнута; нельзя подставлять последний день или медиану наблюдённых событий.
Для седьмого дня lifelines даёт 95%-й интервал приблизительно 0,0534–0,7065. Ширина ожидаема при таком малом наборе риска. Библиотека использует преобразование для построения интервала выживаемости; мы сохраняем её результат и версию в проверке. Из этой неопределённости нельзя сделать точное обещание доли на следующий месяц, особенно за пределами реально наблюдавшихся сроков.
import numpy as np
from lifelines import KaplanMeierFitter

# Условные дни до первого повторного обращения или конца наблюдения.
duration = np.array([2,3,4,4,6,7,8,10])
event = np.array([1,0,1,0,1,1,0,0])
km = KaplanMeierFitter().fit(duration, event_observed=event)
s = 1.0
for t in sorted(set(duration)):
    n = int((duration >= t).sum())
    d = int(((duration == t) & (event == 1)).sum())
    c = int(((duration == t) & (event == 0)).sum())
    s *= 1-d/n
    assert np.isclose(s, km.predict(t))
    print("day, at risk, events, censored, survival",t,n,d,c,round(s,6))
print("median",km.median_survival_time_)
print("95% CI at day 7",km.confidence_interval_.loc[7].to_list())
print("naive no event proportion",1-event.mean())Что видно на графике, кроме падений
Горизонтальная ось — время от общего начала, вертикальная — оценка вероятности остаться без события. Вертикальные падения соответствуют событиям, отметки цензурирования не меняют высоту. Линию нужно рисовать ступенями: наклонный соединяющий отрезок создаёт впечатление постепенного наблюдаемого падения между событиями, которого в непараметрической оценке нет.
Показывайте числа под риском в выбранных точках или отдельную таблицу. Два одинаковых по высоте участка могут иметь совершенно разную информационную поддержку. В конце нашей медицинской таблицы остаётся один наблюдаемый участник, затем исчезает и он. Плоская линия до последней границы означает отсутствие новых зарегистрированных событий в доступном наблюдении, а не доказательство нулевой дальнейшей опасности.
Доверительная полоса должна читаться как неопределённость оценки, а не как область, в которой лежат индивидуальные сроки. Если вы сравниваете две группы, пересечение полос само по себе не заменяет формальную проверку различий. Оценивайте заранее выбранный параметр: вероятность к конкретному сроку, ограниченное среднее время или другую величину, соответствующую вопросу. Выбор только по тому, где кривые красивее разошлись, создаёт поиск результата.
Удержание подписчиков: тот же метод
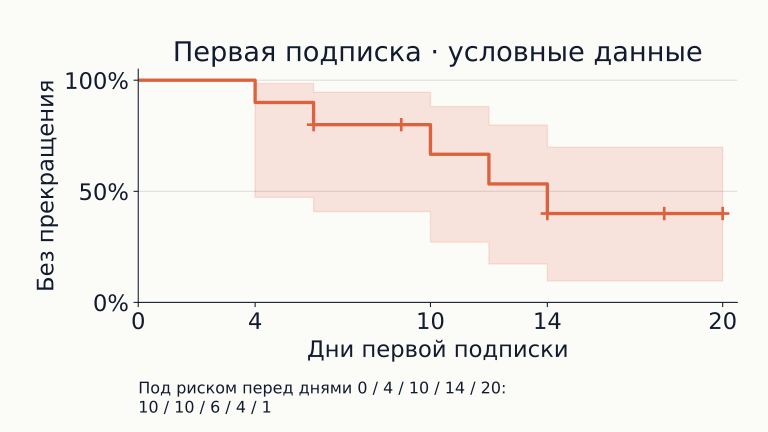
В продуктовой таблице десять синтетических пользователей первой оплаченной подписки. Длительности равны 4, 6, 6, 9, 10, 12, 14, 14, 18 и 20 дням. События зарегистрированы на днях 4, 6, 10, 12 и 14; остальные строки цензурированы на доступной дате среза. Событие — фактическое прекращение оплаченного доступа, а не нажатие кнопки «отменить автопродление» до конца оплаченного периода.
Оценка сохранения непрерывной первой подписки равна 90% после четвёртого дня, 80% после шестого, около 66,67% после десятого, 53,33% после двенадцатого и 40% после четырнадцатого. Медиана — четырнадцать дней. Простая доля пользователей без зарегистрированного прекращения опять равна 50%; она не учитывает различную продолжительность наблюдения. Все точки получаются из кода и показаны ступенчатым графиком.
Это позволяет использовать раннюю информацию новых подписчиков, не объявляя их известными удержанными на поздних сроках. Однако пользователи разных календарных периодов могут иметь разные условия: цену, канал привлечения, версию продукта. Пул всех возрастов не автоматически представляет одну однородную популяцию. При сравнении когорт сохраняйте период входа и проверяйте, не смешиваете ли изменение состава с изменением времени наблюдения.
import numpy as np
from lifelines import KaplanMeierFitter

# Синтетические подписчики: событие — первое прекращение оплаченного доступа.
duration = np.array([4,6,6,9,10,12,14,14,18,20])
event = np.array([1,0,1,0,1,1,0,1,0,0])
km = KaplanMeierFitter().fit(duration, event_observed=event,
                           label="Непрерывная первая подписка")
print(km.event_table.to_string())
for day in [4,6,10,12,14,20]:
    print(day, float(km.predict(day)))
print("median",km.median_survival_time_)
print("naive no event proportion",1-event.mean())
# Чертёж в отдельном файле: ступени, а не сглаженная линия.
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
km.plot_survival_function(ci_show=True, show_censors=True)
plt.xlabel("Дни после начала первой подписки")
plt.ylabel("Доля без первого прекращения")
plt.tight_layout()
plt.savefig("km-retention.png", dpi=160)
Почему обычный retention не всегда является выживаемостью
Пользователь может не зайти в приложение на определённый день, а затем вернуться. Day-N retention считает активность в выбранный день, а кривая времени до первого ухода относится к событию, после которого участник уже не возвращается в набор риска этого анализа. Если определить уход как первое прекращение подписки, последующая повторная покупка не отменяет уже произошедшего первого события. Это корректный вопрос, но не показатель текущей активной базы.
Для продукта без явной отмены иногда определяют уход через период отсутствия активности. Тогда появляется задержка подтверждения: по свежим пользователям ещё неизвестно, сформировался ли полный период молчания. Нужно заранее выбрать правило даты события и границы наблюдения. Нельзя считать сегодняшнюю последнюю сессию окончательным уходом, потому что завтра человек может вернуться. Иначе новая когорта всегда будет выглядеть хуже из-за незавершённой разметки.
Практический выход — договориться о конкретной метрике и использовать соответствующий метод. Для активности в отдельный день строят зрелые когорты обычного retention. Для первого прекращения доступа — время до события. Для возвратов и повторных отмен рассматривают состояния и повторяющиеся события. Одна кривая не обязана отвечать на все вопросы жизненного цикла одновременно.
Независимое цензурирование и тревожные исключения
Административный срез часто удобнее потери связи: мы знаем, почему наблюдение закончилось. Но даже он требует внимания к календарю. Если новый рекламный канал появился незадолго до среза и привёл другой тип пользователей, самые короткие наблюдения систематически отличаются от длинных. Стратификация по периоду или каналу может быть необходима для содержательного вывода, а не только для красоты отчёта.
Потеря связи из-за ухудшения состояния в медицинском исследовании или уход пользователя с удалением аккаунта в продукте могут быть связаны с событием. Простое цензурирование предполагает больше, чем известно. Начните с описания причин и долей потерь по группам, проверьте доступные предшествующие характеристики и сделайте анализ чувствительности. Сложные поправки на цензурирование тоже требуют допущений и качественных данных; они не восстанавливают неизвестную реальность автоматически.
Если исход может произойти только после другого необратимого события или конкурирует с ним, обычное цензурирование такого события меняет задачу. Например, разные причины окончательного прекращения доступа могут конкурировать за первое событие. Для вероятности конкретной причины нужен анализ конкурирующих рисков; трактовать другую причину как безобидную потерю наблюдения обычно нельзя. Определение исхода здесь важнее выбора цвета линии.
Поздний вход и интервально известное событие
Иногда участник попадает в базу уже после начала процесса. Для давно существующего подписчика дата подключения трекинга не является датой первой оплаты. Если включить только тех, кто дожил до подключения, и начать их часы с нуля, возникает отбор по выживанию. При известном истинном начале и корректном дизайне учитывают поздний вход: участник появляется в наборе риска лишь с доступного возраста.
Другая ситуация — состояние проверяют периодическими визитами, поэтому известно лишь, между какими двумя моментами произошло событие. Это интервальное цензурирование. Подстановка даты обнаружения как точного времени может сдвинуть картину. Базовый пример этой статьи использует известное время события и правое цензурирование; переносить его код на интервальные данные без изменения модели нельзя.
Перед расчётом проверьте невозможные даты: конец раньше начала, событие позже последнего подтверждённого наблюдения, разные часовые пояса и дубли идентификаторов. Исправления должны следовать источнику, а не желаемой форме кривой. В отчёте полезно указать, сколько строк исключено и почему, чтобы раннее падение не оказалось артефактом импорта.
Сравнение групп и границы причинного вывода
Логранговый тест сравнивает группы по времени до события при соответствующих предпосылках, но его p не сообщает размер и практическую ценность различия. При пересекающихся кривых один итоговый тест может плохо передавать ранний выигрыш и поздний проигрыш. Поэтому заранее выберите горизонт и содержательную меру эффекта, а график используйте для проверки формы различий и отклонений от ожиданий.
Регрессия Кокса позволяет учитывать признаки, но её стандартная интерпретация через постоянное отношение интенсивностей требует пропорциональности рисков. Каплан — Мейер сам по себе такой модели не навязывает. Не превращайте один подход в обязательное продолжение другого: иногда честная оценка доли без события к определённому сроку лучше отвечает продуктовой задаче, чем трудно объяснимый коэффициент регрессии.
Наблюдательное сравнение тарифов не доказывает эффект тарифа: пользователи выбирают его с разными потребностями. Рандомизация помогает с причинной постановкой, но не отменяет вопросы отслеживания и определения события. Для эксперимента планируйте одинаковую возможность наблюдения, анализ по назначенным группам и обращение с потерями ещё до просмотра кривых.
Проверка таблицы перед обновлением отчёта
При очередном срезе ранние времена уже подтверждённых событий обычно не должны сдвигаться без объяснения. Если вчерашняя отмена внезапно исчезла, проверьте, не перезаписал ли источник историю текущим статусом аккаунта. Для времени до первого события нужна история, а не только состояние на сегодня. Возобновление доступа создаёт новый факт, но не отменяет факт первого прекращения в выбранной метрике.
Отдельно проверьте, что длительности новых участников не превышают время от их входа до даты выгрузки. Сравните количество людей до и после соединения таблиц, причины исключения и число неопределённых статусов. Полезно вручную проследить несколько разных путей: наблюдённое событие, административный срез, потерю наблюдения и совпадение времён. Такая проверка пути исполнения данных ловит ошибки, которые не видны по итоговой медиане.
Если отчёт обновляется автоматически, сохраните дату среза в заголовке и заморозьте использованный набор. Пересчитанная завтра кривая может измениться закономерно: появились события и дозрели сроки. Без версии данных невозможно отличить это изменение знания от изменения алгоритма, а обсуждение продукта превратится в спор о разных выгрузках.
Ошибки, которые искажают кривую
- Считать цензурирование событием. Кривая искусственно падает на дате среза или потери наблюдения.
- Считать цензурированных удержанными на любом сроке. Поздняя часть выглядит лучше, чем позволяют известные данные.
- Исключить все незавершённые строки. Выбирается подгруппа с успевшим произойти исходом, сроки смещаются.
- Рисовать обычную сглаженную линию. График показывает выдуманную динамику между зарегистрированными событиями.
- Смешать регистрацию, оплату и начало трекинга как нулевую дату. Возраст процесса перестаёт быть сопоставимым.
- Назвать время до первой отмены обычным Day-N retention. Вывод начинает отвечать другому вопросу о возвращениях пользователя.
Что почитать и что сохранить в отчёте
Сохраните определение начала и события, дату среза, причины цензурирования, таблицу длительностей и индикаторов, число под риском и версию библиотеки. Для продуктовой команды подпишите, относится ли результат к первой непрерывной подписке, текущей активности или другому процессу. Тогда дальнейший пересчёт будет обновлением того же вопроса, а не незаметной сменой метрики.
В обзоре Ланга и Сесик разбираем требования к проверяемому описанию анализа. Статья об относительном риске помогает не смешивать вероятность к сроку с отношением интенсивностей. Для общего маршрута чтения пригодится обзор книг по доказательной медицине: он возвращает внимание к дизайну и применимости, которые кривая сама не проверяет.
Материал образовательный. Медицинские данные полностью синтетические; он не даёт рекомендаций по лечению, прогнозу конкретного пациента или выбору диагностических процедур.
Материалы по теме
Корреляция Спирмена и Пирсона: выбор, расчёт и ошибки
Корреляция Спирмена и Пирсона на условных медицинских данных: линейная и монотонная связь, выбросы, перестановочный тест в Python и перенос в продукт.
Относительный риск и отношение шансов: разница на примерах
Чем относительный риск отличается от отношения шансов: таблица 2×2, абсолютный эффект, доверительные интервалы, случай — контроль и A/B-тест в Python.
Чувствительность и специфичность теста: расчёт на примере
Чувствительность и специфичность теста, PPV и NPV на синтетических данных. Распространённость, пороги, интервалы и перенос в антифрод с кодом Python.