A/A-тест: как проверить систему экспериментов до первого A/B
A/A-тест проверяет назначение, экспозиции и метрики до анализа эффекта. Учебный menu_color показывает SRM 54/46 при плане 50/50 и путь расследования.
Содержание статьи
Владелец платформы хочет убедиться, что будущие A/B-тесты можно читать. Он запускает A/A: обеим группам показывает одинаковое меню, а затем сравнивает число назначенных и исходы. Разница по сессиям кажется маленькой. Но экспозиций 10 929 в одной группе и 9 350 в другой, хотя план был 50/50. Именно ради такого открытия A/A полезен: отсутствие найденного эффекта не оправдывает сломанный путь назначения.
Коротко: что проверяет A/A и чем он отличается от A/B
В A/A-тесте случайные группы получают одну и ту же версию продукта. Поэтому заранее ожидаемого продуктового эффекта между вариантами нет; опыт проверяет распределение пользователей, экспозиции, события и расчёт метрик. В A/B одна из версий меняется, и задача — оценить её влияние. A/A особенно полезен перед запуском новой платформы, после замены идентификатора пользователя или изменения логирования.
Успешный A/A не гарантирует, что каждый будущий A/B будет корректен. Он испытывает только конкретную аудиторию, путь выдачи варианта, события и временное окно. Но провалившийся A/A даёт предметный список причин для остановки до того, как команда начнёт принимать продуктовые решения по сомнительным числам.
- Назначьте одну и ту же версию двум группам по сохранённому правилу.
- Сверьте экспозиции с ожидаемым сплитом и уникальными участниками.
- Сравните полноту событий и готовность окна наблюдения.
- Проверьте, как часто исходная процедура ошибочно объявляет разницу.
- Расследуйте SRM до анализа будущего A/B.
Что именно должно совпасть до проверки метрики
Первый слой — назначение: стабильный вариант у одного пользователя и целевая доля 50/50 либо иная заранее указанная. Второй — доставка: действительно ли человек увидел назначенный экран, не поменялся ли вариант между устройствами и версиями приложения. Третий — логирование: равны ли шансы записать экспозицию и событие исхода в каждой группе.
Четвёртый слой — аналитический путь: JOIN не должен размножать пользователей, фильтр по времени не должен выбрасывать только одну сторону, а поздним когортам нужно дать дозреть. Пятый — статистический код: при многократном чистом A/A p-value должны вести себя как ожидается под нулевой моделью. Одна цифра «итоговая метрика близка» не покрывает этих проверок.
Полезно сохранять журнал: исходный hash key, долю для флага, версию конфигурации, момент первой экспозиции, выбранный вариант и версию приложения. Без него SRM превращается в гадание. С этим журналом можно локализовать расхождение по этапам, сегментам и дням.
| Слой | Проверка | Что сломается, если пропустить |
|---|---|---|
| Флаг | ожидаемая доля и постоянство варианта | разные популяции в группах |
| Экспозиция | одна запись на пользователя и доставка версии | исчезновение части участников |
| Событие | задержка и пропуски по вариантам | искажённая метрика |
| Выгрузка | дедупликация и одинаковый горизонт | ложная точность или смещение |
| Статистика | распределение p в серии | неверный уровень ложных срабатываний |
SQL-проверка начинается с exposures, не с исходов
exposures.variant — источник назначения конкретного эксперимента. В users есть другое поле ab_group, но оно не кодирует вариант menu_color; использовать его для проверки сплита нельзя. Запрос считает экспозиции и уникальных участников в каждой группе. При штатном назначении эти числа должны совпасть; если нет, сначала ищите повторные записи или меняющийся вариант.
После сверки количества сегментируйте по дню, платформе, версии приложения и каналу. Если SRM появляется только после релиза клиента, вероятна ошибка доставки или события. Если отклонение видно в исходной таблице назначений, расследуйте конфигурацию флага и ключ рандомизации. Не добавляйте в запрос только пользователей, совершивших целевое действие: такая фильтрация может сама создать асимметрию.
SELECT variant, COUNT(*) AS exposures_count,
       COUNT(DISTINCT user_id) AS users_count
FROM exposures
WHERE exp_id = 'menu_color'
GROUP BY variant ORDER BY variant
Почему близкие метрики не спасают проваленный A/A
За семь дней после экспозиции среднее число сеансов на назначенного игрока около 2,994 в control и 2,979 в test. Разница мала. Можно было бы удовлетвориться итогом «p больше 0,05, система работает», но это проверяло бы не то. Сплит нарушен, а похожие средние могут быть случайностью или следствием того, что проблема назначения не затронула именно эту метрику.
A/A не обязан давать ровно одинаковые средние. Случайные группы при чистом процессе периодически отличаются; это и есть статистический шум. Опасен обратный вывод: «нет значимой разницы, значит данные чистые». Низкая чувствительность, пропуски событий или неправильный знаменатель также способны спрятать реальное различие между составами групп.
Если A/A внезапно показал статистически заметный эффект без изменения продукта, возможны случайное ложное срабатывание, нарушение назначения, потеря событий, ошибка разреза или сезонное совпадение с запуском. Один сигнал не называет причину. Проверьте исходные counts, окна и сегменты, а затем воспроизводимость на новой серии.
Много A/A-тестов: как читать распределение p-value
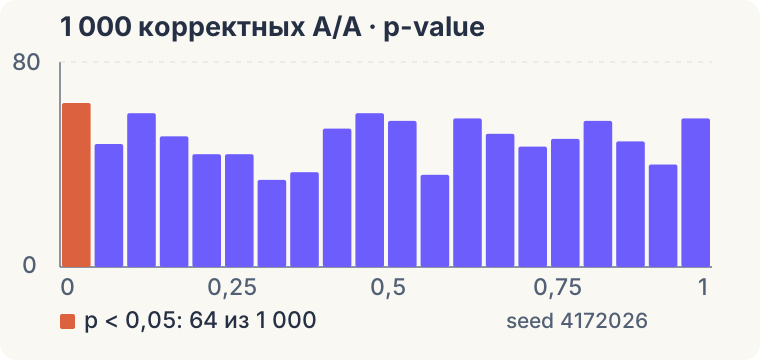
При корректной нулевой модели непрерывные p-value в большой серии примерно равномерны от 0 до 1. Значения ниже 0,05 появляются примерно в 5% корректных проверок с таким порогом; они не означают автоматической поломки. Подозрение вызывают систематический избыток маленьких p, необычные пики и различия по версиям клиента. На дискретных исходах или малых n распределение может отличаться от идеальной равномерности из-за самой процедуры.
На соседней гистограмме — 1 000 симулированных корректных A/A для бинарной активности игроков с двумя или более сеансами за неделю. По фиксированному seed 64 из 1 000 дали p < 0,05, то есть 6,4%. Это пример конечного разброса вокруг ожидаемых 5%, а не проверка исторического menu_color: симуляция использует правильный сплит, тогда как реальный флаг его нарушил.
Нельзя многократно запускать A/A, пересматривать результаты и остановиться только на «хорошем» запуске, а затем объявить платформу прошедшей проверку. Протокол серии — сколько запусков, на какой аудитории, по каким исходам, с каким правилом тревоги — нужно записать заранее. Иначе отбор удобного окна маскирует нестабильность.
Если A/A «прокрасился»: порядок расследования
Начните с назначения: для одного и того же пользователя вариант должен быть постоянным, а настройка процента — совпадать с ожидаемой. Затем проверьте, что экспозиция записывается в обоих вариантах до исхода и не теряется при ошибке интерфейса. Сопоставьте числа до и после каждого этапа: пришёл запрос, назначен флаг, доставлена версия, сохранено событие, попал в аналитическую витрину.
Разбейте путь по дню, версии приложения, платформе и каналу. Если дело в одном сегменте, общий сплит может выглядеть здоровым. Проверьте, не фильтрует ли аналитическая витрина пользователей по действию, на которое потенциально влияет тест; такой post-treatment отбор сам создаёт смещение. Исправляйте механизм, затем повторяйте A/A на новой группе: пересчёт старой выгрузки редко доказывает, что исправленная платформа работает.
У menu_color причина — конфигурация флага. У других инцидентов SRM может возникать из-за ботов, разного приёма запросов сервером, ошибок логирования и поздних событий. Поэтому нельзя лечить каждый случай переназначением веса 54/46 в статистическом тесте. Коэффициент не восстановит пользователей, которые вообще не попали в исходную таблицу.
Где A/A живёт в рабочей платформе
Платформа экспериментов может запускать A/A как обязательный этап после создания нового флага и после существенных изменений идентификатора или событий. Автоматический мониторинг сравнивает назначение с планом и поднимает сигнал до публикации дашборда эффекта. Этот сигнал должен вести к исходным этапам потока, а не просто показывать красную плашку без числа пользователей и даты начала расхождения.
Для A/A заранее выбирают чувствительную метрику, горизонт её созревания и аудиторию, похожую на будущие тесты. Опыт на небольшом внутреннем трафике может обнаружить техническую ошибку, но не гарантирует то же качество на мобильной аудитории с другой задержкой событий. Поэтому полезны и целевые A/A после изменений инфраструктуры, и непрерывная диагностика каждого A/B.
Часть проверок должна срабатывать ещё до A/A: единый вариант в логах назначения, отсутствие дублей ключа «пользователь × эксперимент», положительная доля полученных экспозиций. A/A дополняет эти инварианты проверкой всего пути до финальной таблицы. Позже отдельный материал разберёт архитектуру платформы; на этом этапе достаточно записать, кто отвечает за тревогу и кто блокирует публикацию результата.
Решение по DragonKeep: остановить причинный анализ
По menu_color действие конкретное: не использовать его как сертификат качества платформы, восстановить конфигурацию 50/50, сверить назначение с событием экспозиции и повторить A/A после исправления. Метрика сеансов 2,994 против 2,979 не является индульгенцией. Пока первичный сплит провален, запуск следующего A/B с той же конфигурацией создаст ненадёжную основу для решения.
В учебном генераторе в поведение не вводили эффекта от цвета меню. Это знание разработчика набора, а не информация, которой обычно располагает аналитик в продукте. Правильное решение опирается на видимый SRM и путь данных. Если в рабочем отчёте писать «эффекта нет» только потому, что автор знает генератор, студент научится обходить диагностику вместо расследования.
После повторного чистого A/A можно переходить к A/B, сохранив контроль SRM при каждом запуске. Но не надо требовать, чтобы одно p для одной метрики оказалось ровно около 0,5. В правильно работающей системе случайность допускает и маленькие p; качество оценивают по процедуре, серии и техническому состоянию.
Пять частых ошибок в A/A
Первая — анализировать эффект до сплита. Это может превратить проблему доставки в «влияние функции». Вторая — подменить плановую пропорцию наблюдаемой после обнаружения SRM. Так формальная проверка всегда получится удобной. Третья — считать users.ab_group назначением любого исторического опыта. Смешение вариантов делает проверку бессмысленной.
Четвёртая — объявить платформу здоровой потому, что p по сеансам больше 0,05. Низкая мощность или пропуск событий тоже дают несигнификантность. Пятая — паниковать из-за одного p < 0,05 в чистом A/A: при номинальном α такие случаи неизбежны, ищите повторяемый сигнал и технические аномалии. Шестая — делить число событий вместо уникальных участников, хотя назначение идёт по пользователям.
Седьмая — исправить источник, но оставить старую выгрузку как доказательство ремонта. Нужен новый проход данных через исправленный путь. Эта простая дисциплина отделяет диагностический эксперимент от красивого слайда «всё работает». На платформе можно автоматизировать большинство проверок, но ответственность за причину тревоги остаётся у команды.
Частые вопросы
Что такое A/A-тест простыми словами? Это опыт, где обе случайные группы видят одинаковый продукт; команда проверяет назначение, события и статистику до сравнения двух разных версий.
Должен ли A/A всегда дать p > 0,05? Нет. При верном нуле и уровне α = 0,05 примерно в 5% корректных проверок получится p < 0,05. По одному p нельзя объявить платформу исправной или сломанной.
Что такое SRM? Sample ratio mismatch — заметное несоответствие числа участников в группах заранее заданному сплиту. Это повод искать ошибку назначения, доставки или отбора в данных.
Можно ли продолжать A/B при SRM, если итоговые метрики похожи? Нет оснований считать причинный анализ надёжным до выяснения причины SRM. Похожие средние не доказывают сопоставимость групп.
Что делать после исправления флага? Повторить A/A на новых назначениях, проверить сплит и путь события до отчёта, затем сохранить автоматическую тревогу для рабочих A/B.
Материалы по теме
A/B-тестирование: как провести тест от гипотезы до решения
Пошаговый A/B-тест на учебной игре: гипотеза, метрика, MDE, сплит, D7 retention, интервал и решение. Где ломается сравнение и что проверить до раскатки.
Почему A/B-тесту нельзя доверять: SRM, подглядывание и другие ошибки
Практический чеклист качества A/B-теста: как заметить перекос трафика, подглядывание в результаты, множественные проверки и поломку трекинга.
A/B-тест в SQL: конверсия, проверка сплита и разбор по сегментам
Как посчитать A/B-тест запросом: конверсия по группам, проверка SRM, разница, z и доверительный интервал в SQL и срез по устройствам, после которого меняется решение.