Ошибки первого и второго рода в A/B-тесте: цена решения
Что такое α, β и мощность, как размер выборки меняет риск и почему p-value не доказывает отсутствие эффекта. Симуляция 1 000 экспериментов на данных DragonKeep.
Содержание статьи
Команда видит p = 0,04 и собирается выпустить новый экран. Если экран на самом деле ничего не меняет, это может быть ложный запуск — ошибка первого рода. В другом тесте p = 0,12, команду останавливают, хотя функция действительно помогает: возможно, выборка слишком мала и сработала ошибка второго рода. Эти две ошибки нельзя распознать по одной наблюдаемой таблице, но можно заранее контролировать их частоту для выбранного дизайна.
Коротко: α, β и мощность в одном решении
Ошибка первого рода — отклонить нулевую гипотезу, когда она верна: объявить изменение победителем при отсутствии эффекта. Уровень α — заранее заданная верхняя вероятность такого решения при соблюдении модели и процедуры. Ошибка второго рода — не отклонить нулевую гипотезу, когда существует указанный альтернативный эффект. Её вероятность β зависит от величины эффекта, шума, размера выборки и правила проверки; мощность равна 1 − β.
Важно слово «указанный». У теста нет одной универсальной мощности «найти всё полезное». Для прироста D7 на 0,2 п.п. вероятность обнаружения будет иной, чем для 2,37 п.п. В планировании задают минимально полезный эффект MDE и получают требуемый объём. После опыта интервал показывает, какие эффекты остаются совместимы с наблюдением, а не сообщает постфактум вероятность уже совершённой ошибки.
- α контролирует ложное открытие при истинной нулевой модели.
- β относится к конкретной альтернативе и данному объёму.
- Мощность = 1 − β; увеличение n обычно помогает заметить заданный эффект.
- Меньшее α снижает ложные запуски, но при том же n может увеличить пропуски.
- Ни α, ни β не равны вероятности истины гипотезы после просмотра данных.
Матрица «правда × действие» на продуктовых примерах
Представьте две неизвестные нам реальности: новый туториал не меняет D7 или повышает его на заранее значимую величину. Команда может объявить победу или не сделать этого. В первом случае неверный релиз расходует время разработки и может занять место хорошей идеи; во втором пропущенная полезная функция откладывает рост. Цены этих ошибок не симметричны и зависят от функции.
Для изменения кредитного скоринга ложный позитив может ухудшить риск портфеля, поэтому допустимый α выбирают осторожнее и дополняют решением по защитным метрикам. Для бесплатного текста подсказки стоимость ложного запуска ниже, но пропуск полезной функции тоже не бесплатен. Стандартные 0,05 и 80% мощности — привычные ориентиры, а не универсальные этические и финансовые правила.
| Правда | Объявили эффект | Не объявили эффект |
|---|---|---|
| Эффекта нет | Ошибка I рода: ложный запуск | Корректный отказ от заявления |
| Эффект уровня MDE есть | Обнаружили полезное изменение | Ошибка II рода: пропустили полезное изменение |
Откуда берётся пять процентов ложных «побед»
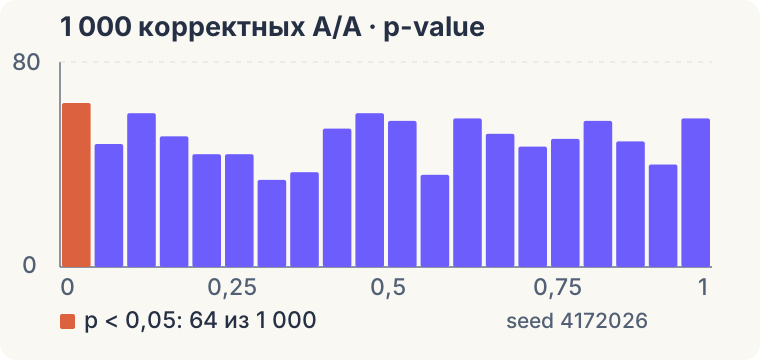
Если провести много независимых A/A-экспериментов с корректным назначением и каждый раз применять заранее выбранный двусторонний тест на уровне α = 0,05, доля ложных отклонений в долгой серии будет около 5%. Это не значит, что ровно каждый двадцатый тест станет ложным или что конкретное p = 0,04 имеет «шанс ошибки 4%». Речь о свойствах правила при повторении мира, где нулевая гипотеза верна.
Для симуляции берём базовую долю игроков с двумя или более сеансами за 7 дней в учебном menu_color: около 72,0%. Генератор создаёт две независимые группы по 10 000 пользователей с той же вероятностью, 1 000 раз, и каждый раз считает z-тест долей. При seed 4172026 критерий отклоняет ноль 64 раза, то есть 6,4%. Разница от ровно 5% — обычный шум конечной серии, а не новое значение α.
Это только симуляция идеального A/A. Реальный menu_color нельзя считать успешно прошедшим A/A: его распределение назначений 10 929/9 350 вместо плана 50/50. Имитация правильного сплита помогает объяснить статистическую ошибку; фактический SRM показывает совсем другую, инженерную поломку. Не смешивайте эти выводы.
При настоящем эффекте малая выборка чаще пропускает выигрыш
Вторая симуляция использует контрольную вероятность D7 13,358% и тестовую 15,728% — доли из onboarding_v2. Мы задаём эту разницу как известную правду модели, затем генерируем 1 000 независимых повторений для каждой пары размеров. При 500 пользователях на вариант значимость достигается в 16,0% повторов: β около 84%. При 2 000 — в 54,6%, пропуск около 45,4%. При 8 500 — в 99,0%, пропуск около 1,0%. Эти числа относятся к данной разнице +2,37 п.п. и этой модели, а не к любому будущему эффекту.
Для меньшего эффекта той же выборки может не хватить. Отсюда связь с MDE: сначала определить, какой минимальный выигрыш оправдывает внедрение, затем подобрать n при выбранных α и требуемой мощности. Нельзя запускать тест на 500 человек, получить p = 0,3 и объявить, что эффекта размером +2,37 п.п. точно нет. Выборка такого масштаба в нашей симуляции обычно пропускает даже существующий эффект.
Когда трафик фиксирован, есть три честных выхода: ждать дольше по заранее намеченному горизонту, искать более чувствительную метрику без смены цели после старта или признать, что неопределённость останется. Понижать порог эффекта в расчёте размера выборки без увеличения n нельзя. Сравнение интервала с возможным вредом помогает сформулировать ограничение даже в незначимом тесте.
| Пользователей на вариант | Обнаружили эффект | Пропустили эффект |
|---|---|---|
| 500 | 16,0% | 84,0% |
| 2 000 | 54,6% | 45,4% |
| 8 500 | 99,0% | 1,0% |
Категории — число пользователей на вариант, значения — процент симуляций с p < 0,05.
Код симуляции: один seed, одна проверка
Код ниже воспроизводит обе серии. Он использует бинарные исходы по одному назначенному игроку, z-статистику для разности долей с объединённой оценкой под нулевой гипотезой и двусторонний p. Случайный генератор один и проходит сначала A/A, затем размеры 500, 2 000 и 8 500; смена порядка изменит конкретные доли, но не смысл метода.
Базовая вероятность для A/A не вводится с потолка: её можно пересчитать по семидневным сеансам menu_color, одна строка на игрока. В настоящем проекте стоит фиксировать версии библиотек, код источника и правило включения. Репликация симуляции не превращает исторический эксперимент со сломанным флагом в чистый тест.
import numpy as np
from scipy import stats

rng = np.random.default_rng(4172026)
def rejection_rate(p0, p1, n):
    a = rng.binomial(n, p0, 1000)
    b = rng.binomial(n, p1, 1000)
    pooled = (a + b) / (2 * n)
    se = np.sqrt(pooled * (1 - pooled) * 2 / n)
    p = 2 * stats.norm.sf(np.abs((b/n - a/n) / se))
    return np.mean(p < 0.05)

print("A/A:", rejection_rate(14610/20279, 14610/20279, 10000))
for n in (500, 2000, 8500):
    print(n, rejection_rate(1140/8534, 1332/8469, n))
Ложное срабатывание и доля ложных находок — не одно число
Вопрос «сколько ложных результатов будет среди всех опубликованных побед?» отличается от вопроса «как часто правило ошибается, если эффекта нет?». Второй контролируется α в рамках фиксированной процедуры. Первый зависит ещё и от того, насколько часто тестируемые идеи действительно работают, от мощности и от отбора результатов для публикации. Если команда рассказывает только об удачных экспериментах, читатель видит не всю серию решений.
Представьте 100 заранее определённых независимых опытов, из которых 90 не имеют эффекта и 10 действительно дают выбранный MDE. При α = 0,05 среди 90 пустых в среднем будет 4,5 ложных объявлений. Если мощность против MDE равна 80%, среди десяти полезных в среднем обнаружатся восемь. В такой условной серии около 4,5 из 12,5 объявленных побед были бы ложными — примерно 36%, хотя α всего 5%. Это иллюстрация условного набора, не оценка доли работающих идей на нашем сайте или у любой компании.
Меняя предположение о числе полезных идей, получим другую долю ложных побед даже при тех же α и β. Именно поэтому нельзя пересказать p = 0,04 как «шанс, что вывод неверен, 4%». Для рабочего процесса полезно вести реестр всех запланированных и проведённых тестов, а не только красивых слайдов. Повторение результата на новой аудитории даёт дополнительную проверку, но тоже требует заранее понятного правила отбора и анализа.
| Истинное состояние | Число тестов | Среднее число объявленных побед |
|---|---|---|
| Нет эффекта | 90 | 4,5 ложных |
| Есть MDE | 10 | 8 настоящих |
Одна таблица не показывает, какой род ошибки случился
Предположим, реальный тест дал p = 0,12. Мы видим данные и решение «не объявлять эффект», но не видим истинную причинную разницу во всей будущей аудитории. Нельзя поставить в отчёте галочку «ошибка II рода»: она определена относительно недоступной нам правды. Можно сказать, что при запланированном MDE и объёме расчётная вероятность пропуска была такой-то, а наблюдаемый интервал всё ещё допускает полезный выигрыш.
Симметрично p = 0,02 не раскрывает, была ли конкретная победа ошибкой I рода. Уровень α говорит о повторяемом поведении процедуры в нулевом мире. Если проверка проводилась много раз до первого маленького p, исходная процедура изменилась и обещание α = 0,05 больше не относится к полученному решению. Если группы распределились не по плану, проверка модели тоже под вопросом.
Практический отчёт должен отделять риск, заданный до старта, от факта, наблюдаемого после. До старта записывают α, мощность для MDE и правило остановки. После показывают эффект, интервал, исполнение протокола и решение. Такое разделение не прячет неопределённость, зато не изображает недоступную истину как вычисляемую колонку в выгрузке.
Почему снижение α увеличивает требования к данным
Если команда ужесточает правило с 0,05 до 0,01, ложное отклонение при истинном нуле становится реже при правильной калибровке. Но при том же эффекте и n статистике теперь нужно пройти более высокий порог. Часть настоящих эффектов, обнаруживаемых старым правилом, перестанет достигать значимости; β увеличится. Чтобы сохранить прежнюю мощность, потребуется больше независимых участников или снижение шума без изменения вопроса.
Обратный ход — поднять α ради скорости — разрешает больше ложных побед. Выбор должен быть записан до результатов, связан с затратами на ошибку и согласован с тем, кто несёт риск. Для опасного изменения платежного процесса уместны иной порог, жёсткий guardrail и поэтапный запуск. Для дешёвой подсказки можно принять больше исследовательского риска, но нельзя задним числом объявлять послабление «стандартной статистикой».
Если тестируется несколько основных метрик или множество сегментов, семейный риск ложной находки может стать выше номинального α. Это отдельная задача множественных сравнений. Короткая проверка одного исхода в нашем коде не позволяет одновременно выбирать лучший из десятка показателей и сохранять те же 5%.
Цена двух ошибок зависит от продукта
Возьмите туториал DragonKeep. Ложный запуск может усложнить первый сеанс, отвлечь команду от улучшения уровней и ухудшить D7, если реальный эффект равен нулю или отрицателен. Пропуск настоящего эффекта на +2,37 п.п. оставит часть новых игроков без помощи. Стоимость первой и второй ошибки меняется с числом будущих игроков, сложностью отката и ценой альтернативной работы команды.
Команда может записать грубую таблицу потерь: сколько стоит внедрение, сколько игроков увидит изменение за месяц, какова ценность удержанного игрока и что придётся компенсировать при плохом опыте. Это не способ вычислить «вероятность истинной гипотезы» из p. Это способ выбрать допустимый риск и MDE до опыта. При медленном исходе стоимость ожидания также входит в решение — маленькое α любой ценой не всегда оптимально.
Guardrail не подменяет основную цель: если D7 вырос, а доля оплат сильно упала, релиз может быть нежелателен. Для опасных исходов задайте предел допустимого ухудшения и метод проверки этого предела. Фраза «по платежам незначимо» без интервала не гарантирует безопасность. Иначе команда понижает риск ложного вывода об успехе D7, но оставляет риск пропустить денежный ущерб.
После теста: что можно и чего нельзя сказать по p
Незначимый тест не доказывает равенство вариантов. При n = 500 из симуляции большинство опытов с реальным приростом +2,37 п.п. не прошли бы порог. Правильный следующий взгляд — на интервал эффекта и заранее выбранную зону полезности. Если интервал широк, исследование не разрешило решение; если узок и исключает все полезные величины, можно обоснованно отказаться от идеи.
Значимый тест тоже не гарантирует выигрыш на следующем трафике. Он мог быть ложным срабатыванием в потоке проверок, эффект может зависеть от сезона или измениться при полном релизе. Проверьте назначения, окно, сравнимость и защитные метрики; лишь затем планируйте раскатку. Номинальная частота ошибки I рода относится к заявленной процедуре, а не к произвольно выбранной финальной таблице после десятков просмотренных графиков.
Постфактум вычисленная «мощность» из наблюдаемого p не отвечает на вопрос о будущем повторе и обычно дублирует само p. Для будущего теста возьмите независимую оценку базовой доли и реально полезного изменения, затем снова рассчитайте n. Для текущего решения сообщите наблюдаемую разницу, интервал, условия и ограничения данных.
Пять ошибок, которые меняют вывод
Первая — сказать «α = 5%, значит вероятность, что наш значимый результат ложен, 5%». Это путает частоту правила при истинном нуле с вероятностью гипотезы после данных. Вторая — приписать тесту единственную мощность без указания эффекта. При одном n тест может почти всегда находить большой эффект и часто пропускать малый.
Третья — считать 1 000 симуляций магическим доказательством, что реальный SRM безопасен. Модель генерирует верный сплит, а исторический menu_color имеет иной. Четвёртая — поднять α после просмотра p = 0,07 ради выпуска. Такой выбор ломает исходную частоту ложных решений. Пятая — остановиться на втором дне, потому что p впервые упало ниже 0,05, приписав результату свойства фиксированного теста.
Шестая — трактовать p > 0,05 как доказательство нулевого эффекта при маленькой выборке. Седьмая — повышать n платежами и сессиями вместо пользователей: повторные строки одного человека не дают столько же независимой информации. Каждая из этих ошибок превращает управляемый риск в неизвестный, хотя формула теста сама по себе может быть написана верно.
Частые вопросы
Что такое ошибка первого рода простыми словами? Это объявить победу изменения, которое в изученной популяции и по выбранному вопросу не даёт эффекта. Уровень α задают до опыта для частоты таких ложных выводов в серии корректных проверок.
Что такое ошибка второго рода? Это не обнаружить заданный существующий эффект. Её вероятность β может быть очень высокой при малой выборке; в нашем примере n = 500 на вариант пропускал эффект +2,37 п.п. в 84% симуляций.
Почему 1 − β называется мощностью? Это вероятность по процедуре обнаружить указанный альтернативный эффект. Она растёт с размером n и силой эффекта, но не равна уверенности в уже увиденном результате.
Можно ли полностью избежать обеих ошибок? Нет: наблюдения конечны и случайны. Можно заранее выбрать цену рисков, размер выборки, основные метрики, правило остановки и прозрачный способ решения.
Как проверить расчёт до старта? Подставьте базовую долю, MDE, α и желаемую мощность в калькулятор размера выборки; затем проверьте, что необходимое число относится к независимым единицам назначения, а календарь даёт полное окно исхода.
Материалы по теме
Калькулятор размера выборки для A/B-теста: сколько трафика и дней нужно
Как рассчитать размер выборки и длительность A/B-теста: что такое MDE, откуда берутся уровень доверия и мощность, и почему вдвое меньший эффект стоит вчетверо большего трафика.
Центральная предельная теорема простыми словами: зачем она аналитику
Центральная предельная теорема (ЦПТ): почему среднее скошенной метрики распределено почти нормально, как считать стандартную ошибку среднего σ/√n и почему правило «n ≥ 30» не закон. Симуляция на выручке из учебной базы.
Калькулятор значимости A/B-теста: как посчитать и как прочитать результат
Как посчитать статистическую значимость A/B-теста по двум конверсиям: какие числа нужны, что означает p-value и доверительный интервал разницы, и когда расчёт вообще не применим.