Дисперсионный анализ (ANOVA) и критерий Фишера: формулы и пример
Дисперсионный анализ сравнивает средние трёх и более групп. Критерий Фишера, расчёт F вручную, в SQL и Python, таблица Фишера, эта-квадрат, критерий Тьюки и условия.
Содержание статьи
Однофакторный дисперсионный анализ (ANOVA, analysis of variance) проверяет, различаются ли средние в трёх и более группах: он сравнивает разброс между группами с разбросом внутри групп. Статистика критерия Фишера — F = MS между / MS внутри, отношение двух средних квадратов; если средние равны и выполнены условия метода (о них ниже), F подчиняется распределению Фишера с (k − 1, N − k) степенями свободы, где k — число групп, а N — число наблюдений. Дальше — расчёт руками на 15 числах, тот же расчёт в SQL и Python на учебной базе, размер эффекта, попарные сравнения после значимого F и разные критерии, которые носят имя Фишера.
Что такое дисперсионный анализ простыми словами
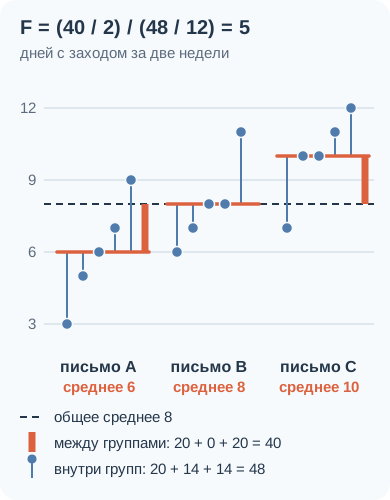
Маркетолог сравнивает три приветственных письма и видит разные средние: 6, 8 и 10 дней с заходом за первые две недели. Средние различались бы и у трёх случайных частей одной аудитории. Вопрос в том, больше ли различие, чем даёт случай.
ANOVA отвечает на него через два разброса. Разброс внутри групп показывает, насколько пользователи отличаются друг от друга при одном и том же письме, — это шум. Разброс между группами показывает, как далеко средние групп ушли от общего среднего. Если письма ничего не меняют, обе величины оценивают одну и ту же дисперсию, и их отношение F близко к единице. Чем F больше, тем хуже данные согласуются с нулевой гипотезой.
Название сбивает с толку: считают дисперсии, а вывод делают о средних. Нулевая гипотеза — все средние равны, альтернатива — хотя бы одно отличается.
F = MS между / MS внутри = (SS между / (k − 1)) / (SS внутри / (N − k))SS между = Σ nⱼ · (x̄ⱼ − x̄)²; SS внутри = Σ Σ (xᵢⱼ − x̄ⱼ)². k — число групп, N — число наблюдений, nⱼ и x̄ⱼ — размер и среднее группы j, x̄ — общее среднее.
- F = MS между / MS внутри; MS — средний квадрат, то есть сумма квадратов отклонений, делённая на число степеней свободы.
- Для двух групп ANOVA совпадает с двусторонним t-тестом Стьюдента с объединённой дисперсией (не с тестом Уэлча): F = t².
- Значимый F не говорит ни о том, какие группы различаются, ни о том, велика ли разница.
Как посчитать ANOVA вручную: пример на 15 числах
Три письма, по пять пользователей. Письмо A: 3, 5, 6, 7 и 9 дней с заходом; B: 6, 7, 8, 8 и 11; C: 7, 10, 10, 11 и 12. Средние групп — 6, 8 и 10, общее среднее — 8.
Межгрупповая сумма квадратов (в таблицах — SS, sum of squares): отклонение каждого среднего от общего возводим в квадрат и умножаем на размер группы. 5 · (6 − 8)² + 5 · (8 − 8)² + 5 · (10 − 8)² = 40. Внутригрупповая: квадраты отклонений от среднего своей группы. Для A это 9 + 1 + 0 + 1 + 9 = 20, для B и C — по 14, всего 48. Общая сумма квадратов — отклонения всех 15 чисел от 8 — равна 88, то есть 40 + 48.
Степени свободы (df): между группами k − 1 = 2, внутри N − k = 12. Средние квадраты (MS): 40 / 2 = 20 и 48 / 12 = 4. Отсюда F = 20 / 4 = 5. Средний квадрат внутри групп — это объединённая выборочная дисперсия: дисперсии групп равны 5, 3,5 и 3,5, их среднее — 4 (при разных размерах групп дисперсии взвешивают по nⱼ − 1). Степени свободы — сколько слагаемых в сумме могут меняться независимо: k − 1 для средних групп, N − k для наблюдений внутри групп.
p-value — вероятность получить F не меньше 5, если средние равны, — составляет 0,026. При пороге 0,05 нулевую гипотезу отвергаем.
| Источник разброса | SS | df | MS | F | p |
|---|---|---|---|---|---|
| Между группами | 40 | 2 | 20 | 5,0 | 0,026 |
| Внутри групп | 48 | 12 | 4 | ||
| Всего | 88 | 14 |
import numpy as np
from scipy import stats

a = np.array([3, 5, 6, 7, 9])        # письмо A: дней с заходом за две недели
b = np.array([6, 7, 8, 8, 11])       # письмо B
c = np.array([7, 10, 10, 11, 12])    # письмо C
groups = [a, b, c]
values = np.concatenate(groups)
k, n = len(groups), len(values)

ss_between = sum(len(g) * (g.mean() - values.mean()) ** 2 for g in groups)
ss_within = sum(((g - g.mean()) ** 2).sum() for g in groups)
f_stat = (ss_between / (k - 1)) / (ss_within / (n - k))
print(ss_between, ss_within, f_stat)                  # 40.0 48.0 5.0
print(round(stats.f.sf(f_stat, k - 1, n - k), 4))     # 0.0263 — p-value
print(round(stats.f.ppf(0.95, k - 1, n - k), 2))      # 3.89 — критическое значение

res = stats.f_oneway(a, b, c)                         # то же одной функцией
print(round(res.statistic, 2), round(res.pvalue, 4))  # 5.0 0.0263

t = stats.ttest_ind(a, c)                             # две группы: F = t²
print(round(t.statistic ** 2, 2), round(stats.f_oneway(a, c).statistic, 2))   # 9.41 9.41
Что такое таблица Фишера и как найти критическое значение F
Таблица Фишера — таблица критических значений F-распределения, справочник докомпьютерной эпохи. По степеням свободы числителя (столбец) и знаменателя (строка) в ней находят порог, который F превышает с вероятностью α (уровень значимости), если нулевая гипотеза верна. Для трёх писем на пересечении 2 и 12 при α = 0,05 стоит 3,89. Расчётное F = 5 больше — различие значимо. При α = 0,01 порог равен 6,93, и тот же результат уже незначим.
Сейчас таблицу заменяет функция. В Python критическое значение даёт scipy.stats.f.ppf(0.95, 2, 12), p-value — scipy.stats.f.sf(5, 2, 12). В Excel это =F.ОБР.ПХ(0,05;2;12) и =F.РАСП.ПХ(5;2;12). Весь расчёт Excel выполняет в надстройке «Пакет анализа»: команда «Анализ данных» на вкладке «Данные», инструмент «Однофакторный дисперсионный анализ».
В PostgreSQL и DuckDB функций F-распределения нет. Суммы квадратов и F считаются запросом, а p-value берут в Python или Excel.
| df внутри групп | df между = 1 | df между = 2 | df между = 3 |
|---|---|---|---|
| 12 | 4,75 | 3,89 | 3,49 |
| 30 | 4,17 | 3,32 | 2,92 |
| 120 | 3,92 | 3,07 | 2,68 |
| 2 615 | 3,85 | 3,00 | 2,61 |
Почему нельзя просто сравнить группы попарно t-тестами
Три группы — это три пары, четыре — шесть пар, шесть — пятнадцать. Когда различий нет, каждый t-тест при пороге 0,05 ошибается в 5% случаев, а шансов ошибиться хотя бы раз становится больше. Для m независимых проверок это 1 − 0,95ᵐ: 14,3% при трёх, 26,5% при шести и 53,7% при пятнадцати.
Попарные сравнения зависимы: каждая группа участвует в нескольких, поэтому ошибки случаются пачками, а вероятность хотя бы одной — ниже, чем по формуле. Оценку даёт симуляция. Сто тысяч раз берём группы по 20 значений из одного нормального распределения и считаем долю случаев, где хотя бы одна пара дала p < 0,05. Выходит около 12% для трёх групп, 20% для четырёх и 36–37% для шести; десятые доли зависят от зерна. F-критерий на тех же данных ошибается в 5,0% случаев при любом числе групп: гипотеза у него одна.
Для двух групп ANOVA и t-тест Стьюдента с равными дисперсиями — один и тот же критерий. На письмах A и C t = −3,07, t² = 9,41, и F для этих двух групп тоже равен 9,41 при том же p = 0,015.
Различий между группами нет. Формула 1 − 0,95ᵐ считает m попарных проверок независимыми; симуляция — 100 000 повторов, группы по 20 значений.
import numpy as np
from itertools import combinations
from scipy import stats

def false_alarm(k, n=20, reps=100_000):
    rng = np.random.default_rng(20261002)
    x = rng.normal(size=(reps, k, n))             # k групп из одного распределения
    mean, var = x.mean(axis=2), x.var(axis=2, ddof=1)
    t_crit = stats.t.ppf(0.975, 2 * n - 2)
    pairs = np.zeros(reps, dtype=bool)
    for i, j in combinations(range(k), 2):        # все попарные t-тесты
        t = (mean[:, i] - mean[:, j]) / np.sqrt((var[:, i] + var[:, j]) / n)
        pairs |= np.abs(t) > t_crit
    f = n * mean.var(axis=1, ddof=1) / var.mean(axis=1)
    anova = f > stats.f.ppf(0.95, k - 1, k * (n - 1))
    return round(float(pairs.mean()) * 100, 1), round(float(anova.mean()) * 100, 1)

for k in (3, 4, 6):
    print(k, false_alarm(k))
# 3 (12.2, 5.0)
# 4 (20.1, 5.0)
# 6 (36.3, 5.0)Пример на данных: одинаково ли возвращаются пользователи из разных каналов
Учебная база симулятора — продукт «Маяк»: в таблице users записаны канал привлечения, устройство и страна, в events — заходы. Метрика — число дней с заходом за первые 14 дней после регистрации, считая день регистрации. Группы — четыре канала.
У окна два ограничения. Платный поиск запущен 1 июля, поэтому берём регистрации с 1 июля: иначе каналы сравнивались бы на разных периодах. События 30 августа обрываются в середине дня, поэтому последний день регистрации — 16 августа: у всех 2 619 пользователей четырнадцать дней закрыты полностью. Одна строка — один пользователь. В учебной базе у каждого есть событие в день регистрации, поэтому минимум — 1; на своих данных замените JOIN на LEFT JOIN, иначе пользователи без заходов выпадут и средние завысятся.
Средние — от 3,21 дня у платного поиска до 5,21 у рекомендаций, стандартные отклонения — от 1,29 до 1,55. Два дня разницы при разбросе в полтора выглядят убедительно, но это пока только описание.
WITH cohort AS (
  SELECT user_id, signup_date, channel
  FROM users
  WHERE signup_date >= DATE '2026-07-01' AND signup_date < DATE '2026-08-17'
),
per_user AS (
  SELECT c.user_id, c.channel,
    COUNT(DISTINCT CAST(e.event_time AS date)) AS active_days
  FROM cohort AS c
  JOIN events AS e ON e.user_id = c.user_id
   AND e.event_time < CAST(c.signup_date + 14 AS timestamp)
  GROUP BY c.user_id, c.channel
)
SELECT channel, COUNT(*) AS users,
  ROUND(AVG(active_days), 3) AS mean_days,
  ROUND(CAST(STDDEV_SAMP(active_days) AS DECIMAL(18, 6)), 3) AS sd
FROM per_user
GROUP BY channel
ORDER BY mean_days DESC;
-- referral     545  5.213  1.551
-- organic      952  4.836  1.513
-- partner      384  3.875  1.442
-- paid_search  738  3.211  1.286
Как сделать дисперсионный анализ в SQL и Python
В SQL расчёт держится на двух оконных функциях: AVG(...) OVER (PARTITION BY channel) ставит в каждую строку среднее группы, AVG(...) OVER () — общее среднее. Остаются две суммы квадратов и арифметика ручного примера.
Результат: SS между = 1 671,1, SS внутри = 5 502,8, F = 557,03 / 2,1043 = 264,71 при 3 и 2 615 степенях свободы. Критическое значение для них — 2,61, p-value меньше 10⁻¹⁰⁰. Функция scipy.stats.f_oneway на тех же пользователях возвращает то же F = 264,71.
Чтобы блок Python был самостоятельным, пользователи в нём восстановлены из таблицы частот: сколько человек в канале зашли в 1, 2, …, 11 разных дней. Её даёт запрос GROUP BY channel, active_days к тому же per_user.
На округлении движки расходятся. CAST(x AS numeric) без точности в PostgreSQL сохраняет все знаки, а в DuckDB означает DECIMAL(18, 3): эта-квадрат устройства из следующего раздела, 0,005945, превращается в 0,006. Поэтому в запросах точность задана явно.
WITH cohort AS (
  SELECT user_id, signup_date, channel
  FROM users
  WHERE signup_date >= DATE '2026-07-01' AND signup_date < DATE '2026-08-17'
),
per_user AS (
  SELECT c.user_id, c.channel,
    COUNT(DISTINCT CAST(e.event_time AS date)) AS active_days
  FROM cohort AS c
  JOIN events AS e ON e.user_id = c.user_id
   AND e.event_time < CAST(c.signup_date + 14 AS timestamp)
  GROUP BY c.user_id, c.channel
),
dev AS (
  SELECT channel, active_days,
    AVG(active_days) OVER (PARTITION BY channel) AS group_mean,
    AVG(active_days) OVER () AS grand_mean
  FROM per_user
),
ss AS (
  SELECT COUNT(*) AS n, COUNT(DISTINCT channel) AS k,
    SUM((group_mean - grand_mean) * (group_mean - grand_mean)) AS ss_between,
    SUM((active_days - group_mean) * (active_days - group_mean)) AS ss_within
  FROM dev
)
SELECT k - 1 AS df_between, n - k AS df_within,
  ROUND(CAST(ss_between AS DECIMAL(18, 6)), 1) AS ss_between,
  ROUND(CAST(ss_within AS DECIMAL(18, 6)), 1) AS ss_within,
  ROUND(CAST(ss_between / (k - 1) AS DECIMAL(18, 6)), 2) AS ms_between,
  ROUND(CAST(ss_within / (n - k) AS DECIMAL(18, 6)), 4) AS ms_within,
  ROUND(CAST((ss_between / (k - 1)) / (ss_within / (n - k)) AS DECIMAL(18, 6)), 2) AS f_stat,
  ROUND(CAST(ss_between / (ss_between + ss_within) AS DECIMAL(18, 6)), 4) AS eta_squared
FROM ss;
-- 3 2615 1671.1 5502.8 557.03 2.1043 264.71 0.2329import numpy as np
from scipy import stats
days = np.arange(1, 12) # 1…11 дней с заходом
freq = { # сколько пользователей канала с таким числом дней
"referral": [4, 14, 48, 109, 155, 101, 78, 25, 9, 1, 1],
"organic": [6, 36, 143, 224, 237, 184, 75, 38, 7, 2, 0],
"partner": [12, 54, 94, 104, 70, 36, 9, 4, 1, 0, 0],
"paid_search": [59, 169, 219, 181, 75, 29, 5, 1, 0, 0, 0],
}
names = list(freq)
g = [np.repeat(days, f).astype(float) for f in freq.values()]
res = stats.f_oneway(*g)
print(round(res.statistic, 2), res.pvalue < 1e-100) # 264.71 True
print(round(stats.f.ppf(0.95, 3, 2615), 2)) # 2.61 — критическое значение
tukey = stats.tukey_hsd(*g) # попарные сравнения
ci = tukey.confidence_interval()
for i in range(4):
for j in range(i + 1, 4):
print(names[i], names[j], round(tukey.statistic[i, j], 2),
round(ci.low[i, j], 2), round(ci.high[i, j], 2), tukey.pvalue[i, j] < 0.001)
# referral organic 0.38 0.18 0.58 True
# referral partner 1.34 1.09 1.59 True
# referral paid_search 2.0 1.79 2.21 True
# organic partner 0.96 0.74 1.19 True
# organic paid_search 1.62 1.44 1.81 True
# partner paid_search 0.66 0.43 0.9 True
lev = stats.levene(*g) # равенство дисперсий
print(round(lev.statistic, 2), round(lev.pvalue, 4)) # 7.0 0.0001
welch = stats.f_oneway(*g, equal_var=False) # ANOVA Уэлча, SciPy 1.16+
print(round(welch.statistic, 2)) # 285.02
kw = stats.kruskal(*g) # Краскел — Уоллис
print(round(kw.statistic, 1), kw.pvalue < 1e-100) # 632.8 TrueЗначимо — не значит много: что показывает эта-квадрат
При том же различии средних F растёт вместе с числом наблюдений, и на тысячах строк значимым становится даже ничтожное различие. Размер эффекта в ANOVA — эта-квадрат: η² = SS между / SS общая, доля общего разброса, которую объясняет деление на группы. Это тот же коэффициент детерминации R², посчитанный для модели «у каждой группы своё среднее».
У каналов η² = 23,3%: почти четверть различий между пользователями в числе дней с заходом связана с каналом. Крайние каналы расходятся на 2,0 дня — это 1,4 стандартного отклонения внутри групп. Различие велико и по существу.
Тот же запрос для устройства и страны даёт другую картину. Устройство: 4,44 дня на компьютере против 4,19 на телефоне, F = 15,65, p = 0,00008 — значимо с большим запасом. Но η² = 0,59%, а разница — четверть дня (95%-й интервал от 0,13 до 0,38). Страна: размах средних тот же, 0,25 дня (от 4,16 до 4,41), а F = 1,43 и p = 0,23. Тот же разрыв в четверть дня значим между двумя группами по 1 300 человек и незначим между крайними странами, где 225 и 277 человек (30 пользователей без страны в сравнение не вошли).
У устройства есть вторая проблема. В платном поиске с телефона пришли 65,6% пользователей, в остальных каналах — 40–44%, а платный поиск возвращается хуже всех. Внутри каналов разница между устройствами не больше 0,16 дня, а в трёх каналах из четырёх среднее у телефонов даже чуть выше. В модели с двумя факторами — канал и устройство — на устройство остаётся 0,02 дня (95%-й интервал от −0,09 до 0,14, p = 0,70). Исходные 0,26 дня в этот интервал не попадают: однофакторный анализ не знает о втором факторе, и «эффект устройства» здесь — состав каналов.
WITH cohort AS (
  SELECT user_id, signup_date, channel, device, country
  FROM users
  WHERE signup_date >= DATE '2026-07-01' AND signup_date < DATE '2026-08-17'
),
per_user AS (
  SELECT c.user_id, c.channel, c.device, c.country,
    COUNT(DISTINCT CAST(e.event_time AS date)) AS active_days
  FROM cohort AS c
  JOIN events AS e ON e.user_id = c.user_id
   AND e.event_time < CAST(c.signup_date + 14 AS timestamp)
  GROUP BY c.user_id, c.channel, c.device, c.country
),
long AS (
  SELECT 'канал' AS factor, channel AS grp, active_days FROM per_user
  UNION ALL
  SELECT 'устройство', device, active_days FROM per_user
  UNION ALL
  SELECT 'страна', country, active_days FROM per_user WHERE country IS NOT NULL
),
dev AS (
  SELECT factor, grp, active_days,
    AVG(active_days) OVER (PARTITION BY factor, grp) AS group_mean,
    AVG(active_days) OVER (PARTITION BY factor) AS grand_mean
  FROM long
),
ss AS (
  SELECT factor, COUNT(*) AS n, COUNT(DISTINCT grp) AS k,
    SUM((group_mean - grand_mean) * (group_mean - grand_mean)) AS ss_between,
    SUM((active_days - group_mean) * (active_days - group_mean)) AS ss_within
  FROM dev
  GROUP BY factor
)
SELECT factor, k AS groups, n AS users,
  ROUND(CAST((ss_between / (k - 1)) / (ss_within / (n - k)) AS DECIMAL(18, 6)), 2) AS f_stat,
  ROUND(CAST(100.0 * ss_between / (ss_between + ss_within) AS DECIMAL(18, 6)), 2) AS eta_squared_pct
FROM ss
ORDER BY f_stat DESC;
-- канал       4  2619  264.71  23.29
-- устройство  2  2619   15.65   0.59
-- страна 4 2589 1.43 0.17WITH cohort AS (
SELECT user_id, signup_date, channel, device
FROM users
WHERE signup_date >= DATE '2026-07-01' AND signup_date < DATE '2026-08-17'
),
per_user AS (
SELECT c.user_id, c.channel, c.device,
COUNT(DISTINCT CAST(e.event_time AS date)) AS active_days
FROM cohort AS c
JOIN events AS e ON e.user_id = c.user_id
AND e.event_time < CAST(c.signup_date + 14 AS timestamp)
GROUP BY c.user_id, c.channel, c.device
)
SELECT channel,
ROUND(CAST(100.0 * AVG(CASE WHEN device = 'mobile' THEN 1 ELSE 0 END) AS DECIMAL(18, 6)), 1) AS mobile_pct,
ROUND(CAST(AVG(CASE WHEN device = 'desktop' THEN active_days END) AS DECIMAL(18, 6)), 2) AS desktop_days,
ROUND(CAST(AVG(CASE WHEN device = 'mobile' THEN active_days END) AS DECIMAL(18, 6)), 2) AS mobile_days
FROM per_user
GROUP BY channel
ORDER BY mobile_pct DESC;
-- paid_search 65.6 3.31 3.16
-- organic 44.2 4.77 4.92
-- referral 41.5 5.20 5.23
-- partner 40.4 3.86 3.89Какие группы различаются: что делать после значимого F
Значимый F означает только «не все средние равны». Различающиеся пары ищут попарными сравнениями с поправкой на их число. Критерий Тьюки (Tukey HSD) сравнивает все пары сразу и держит общую вероятность ложной находки не выше 5%; разброс он оценивает той же объединённой дисперсией, что и F. Простая альтернатива — попарные t-тесты с поправкой Бонферрони: каждое p-value умножают на число сравнений.
На каналах scipy.stats.tukey_hsd различает все шесть пар. Самая близкая — рекомендации и органика: разница 0,38 дня, 95%-й интервал от 0,18 до 0,58. Тьюки, как и F, опирается на общую дисперсию; при неравных дисперсиях тот же вызов с equal_var=False даёт критерий Геймса — Хауэлла, и на каналах вывод не меняется (интервал ближайшей пары — от 0,16 до 0,59).
В ручном примере картина сложнее. По Тьюки письма A и C различаются: p = 0,021, интервал разницы — от 0,6 до 7,4 дня. Бонферрони приводит к тому же выводу, но с меньшим запасом: 0,0154 · 3 = 0,046. Он строже, и дисперсию здесь оценивают по двум группам, а не по трём. Письмо B не отличается ни от A, ни от C (p = 0,29). Равным им обоим оно от этого не становится: при пяти наблюдениях в группе интервал разницы — плюс-минус 3,4 дня.
| Пара | Разница | 95%-й интервал | p |
|---|---|---|---|
| рекомендации − органика | 0,38 | 0,18 … 0,58 | < 0,001 |
| рекомендации − партнёры | 1,34 | 1,09 … 1,59 | < 0,001 |
| рекомендации − платный поиск | 2,00 | 1,79 … 2,21 | < 0,001 |
| органика − партнёры | 0,96 | 0,74 … 1,19 | < 0,001 |
| органика − платный поиск | 1,62 | 1,44 … 1,81 | < 0,001 |
| партнёры − платный поиск | 0,66 | 0,43 … 0,90 | < 0,001 |
Когда ANOVA применять нельзя: условия и их проверка
Условий три: наблюдения независимы, дисперсии в группах примерно равны, остатки (отклонения от среднего своей группы) распределены близко к нормальному закону.
Независимость проверяют устройством данных, а не тестом. У нас строка — пользователь, и каждый пришёл из одного канала. Если строками сделать события или пары «пользователь — день», один человек войдёт в выборку много раз, и критерий насчитает больше свидетельств, чем их есть.
Равенство дисперсий проверяет критерий Левена, scipy.stats.levene: это тот же дисперсионный анализ, но для модулей отклонений от центра своей группы. На каналах p = 0,0001, хотя стандартные отклонения различаются всего в 1,2 раза. На тысячах наблюдений Левен ловит мелочь так же, как F.
Опасно сочетание разных дисперсий с разными размерами групп. В симуляции без различия средних — группы из 10, 40 и 40 наблюдений со стандартными отклонениями 3, 1 и 1 — обычный F находит «различие» примерно в 27% случаев вместо 5%, при группах по 30 — в 7%. Если большой разброс, наоборот, у больших групп (отклонения 1, 3 и 3), F ошибается реже положенного — в 2% случаев — и хуже видит настоящие различия. ANOVA Уэлча не предполагает равных дисперсий и во всех трёх случаях даёт около 5%. В SciPy она включается параметром equal_var=False (с версии 1.16). На каналах Уэлч даёт F = 285,0 против 264,7 — вывод прежний.
Нормальность остатков важна на малых выборках. Число дней с заходом — счётная величина от 1 до 11 с асимметрией остатков 0,28; при группах от 384 человек средние распределены почти нормально по центральной предельной теореме. Критерий Краскела — Уоллиса, scipy.stats.kruskal, заменяет значения рангами и нормальности не требует: H = 632,8, вывод тот же. Гипотеза у него другая: распределения во всех группах одинаковы; чувствителен он к сдвигу одной группы относительно других.
Со скошенными величинами осторожнее. Выручка на пользователя среди регистраций 1 июля – 9 августа (все оплаты до конца данных, срок наблюдения у пользователей разный): у 78% — ноль, асимметрия остатков — 2,3. На десятках наблюдений исход может решить одна крупная оплата, и никакой критерий этого не исправит: нужны больше данных или другая метрика — доля плативших, медиана. На сотнях наблюдений рядом с F стоит посчитать бутстреп-интервал разницы. Метод выбирают до расчёта: на 15 числах ручного примера обычный F даёт p = 0,026, Уэлч — 0,052, Краскел — Уоллис — 0,045.
Что называют критерием Фишера: один F и другие критерии
F-критерий в дисперсионном анализе разобран выше: отношение межгруппового среднего квадрата к внутригрупповому.
F-критерий равенства двух дисперсий. Статистика — отношение двух выборочных дисперсий, F = s₁² / s₂², с (n₁ − 1, n₂ − 1) степенями свободы. Для писем A и C: 5 / 3,5 = 1,43, двусторонний p = 0,74; в Excel двусторонний p возвращает функция F.ТЕСТ. Критерий рассчитан на нормальные данные. В симуляции на двух выборках по 30 значений из одного и того же экспоненциального распределения он «находит» разные дисперсии примерно в 28% случаев вместо 5%; критерий Левена на тех же выборках — в 5%.
Точный критерий (тест) Фишера — другой метод: он проверяет связь двух признаков в таблице 2 × 2 на малых выборках и F-распределением не пользуется. В учебниках для психологов критерием Фишера называют ещё φ* — угловое преобразование для сравнения двух долей.
Все они связаны с Рональдом Фишером. По справочнику Earliest Known Uses of Some of the Words of Mathematics, слово variance (дисперсия) он ввёл в статье 1918 года о наследственности — и там же разложил дисперсию на составляющие. Статистическая процедура появилась в 1921 году в работе об урожайности на Ротамстедской опытной станции, таблица дисперсионного анализа — в публикациях 1923 года, а широко известным метод стал после книги Statistical Methods for Research Workers (1925). Букву F в 1934 году ввёл Джордж Снедекор — в честь Фишера; сам Фишер пользовался величиной z = ½ ln F. Сокращение ANOVA встречается у Джона Тьюки в 1949 году.
Частые вопросы
ANOVA и дисперсионный анализ — одно и то же? Да, ANOVA — сокращение от analysis of variance. «Однофакторный» значит, что группы заданы одним признаком; для двух признаков, как канал и устройство, есть двухфакторный анализ.
Можно ли применять ANOVA для двух групп? Можно: результат совпадёт с t-тестом Стьюдента для равных дисперсий, F = t². На практике для двух групп берут t-тест Уэлча.
Что значит F меньше единицы? Средние групп разошлись меньше, чем ожидалось бы от случайного разброса. Нулевую гипотезу не отвергают. Отрицательным F не бывает: это отношение двух неотрицательных величин.
Нужны ли группы одинакового размера? Нет, формулы работают при любых размерах. Но при равных группах критерий устойчивее к неравным дисперсиям: 7% ложных находок против 27% в симуляции выше.
Подходит ли ANOVA для конверсий? Для долей в нескольких группах берут хи-квадрат по таблице «группа × исход». ANOVA рассчитана на количественную величину: дни, рубли, минуты.
Что читать дальше
Порядок работы с несколькими группами: описать группы, проверить условия, посчитать F и размер эффекта, затем сравнить пары с поправкой. Запросы из статьи можно выполнить в песочнице симулятора SQL-аналитика на этой же базе.
Материалы по теме
Математическое ожидание: что это, формула и примеры
Математическое ожидание простыми словами: среднее, к которому результат сходится в долгую. Формула, пример на кубике, расчёт в SQL и Python, свойства и ловушки.
Ошибка выжившего: что это, примеры и как она искажает анализ
Ошибка выжившего простыми словами: вывод по тем, кто остался. История Вальда без легенд и четыре примера из аналитики продукта с SQL и Python: выручка, удержание, опрос, A/B-тест.
Коэффициент вариации: формула, расчёт и как читать
Коэффициент вариации — стандартное отклонение в процентах от среднего. Формула, пример на пяти числах, расчёт в SQL, Python и Excel, порог 33% для НМЦК и ловушки.