Парадокс Симпсона: что это, примеры и как его заметить в данных
Парадокс Симпсона простыми словами: связь в каждой группе исчезает или меняет знак в сумме. Примеры, разложение на состав и уровень, SQL и Python на учебной базе.
Содержание статьи
Парадокс Симпсона — ситуация, когда связь, которая видна в каждой группе, исчезает или меняет знак после объединения групп; бывает и наоборот: в сумме связь есть, а в группах её нет. Причина в весах: общая доля — это взвешенное среднее долей сегментов, p = Σ wᵢ · pᵢ, и когда у сравниваемых групп разный состав, итог сравнивает не только уровни, но и составы. Ниже — пример, который можно пересчитать руками, разложение разницы на состав и уровень, разбор на учебной базе симулятора SQL-аналитика (SQL для PostgreSQL и DuckDB, расчёт на Python) и главный вопрос практики: какому числу верить, общему или по сегментам.
Что такое парадокс Симпсона простыми словами?
Пример условный, числа придуманы. Отдел продаж сравнивает два скрипта звонка. По старому скрипту A обработали 100 заявок и закрыли 52 сделки, по новому B — тоже 100 заявок и 33 сделки. Новый скрипт выглядит хуже на 19 процентных пунктов (п. п.).
Теперь разделим заявки на тёплые (клиент сам оставил контакт) и холодные. На тёплых B закрыл 13 сделок из 20, это 65%, а A — 48 из 80, или 60%. На холодных B закрыл 20 из 80, то есть 25%, A — 4 из 20, или 20%. Новый скрипт лучше в каждом сегменте на 5 пунктов и хуже в сумме.
Ошибки в подсчёте нет. Старый скрипт работал в основном по тёплым заявкам, 80 из 100, а новый отдали на холодную базу, тоже 80 из 100. Общие 52% и 33% сравнивают прежде всего то, кому звонили.
p = Σ wᵢ · pᵢ, wᵢ — доля сегмента в группе, pᵢ — доля успехов внутри сегментаСкрипт A: 0,8 · 60% + 0,2 · 20% = 52%. Скрипт B: 0,2 · 65% + 0,8 · 25% = 33%. Уровни pᵢ у B выше, а веса wᵢ другие.
| Заявки | Скрипт A | Скрипт B | Кто лучше |
|---|---|---|---|
| тёплые | 48 из 80 = 60% | 13 из 20 = 65% | B, +5 п. п. |
| холодные | 4 из 20 = 20% | 20 из 80 = 25% | B, +5 п. п. |
| все | 52 из 100 = 52% | 33 из 100 = 33% | A, +19 п. п. |
- Оба числа верны: общее и сегментное отвечают на разные вопросы.
- Парадокс возможен, когда сегменты различаются уровнем показателя, а сравниваемые группы — составом.
- Быстрая проверка — держать рядом с долей каждого сегмента его вес.
Почему общий итог спорит с сегментами и как разложить разницу?
Общая доля меняется по двум причинам: сдвинулись уровни внутри сегментов или сдвинулись их веса. Сегментная таблица показывает только уровни, общий итог смешивает оба сдвига. Простое среднее сегментных долей не спасает: это то же взвешенное среднее с равными весами, которых нет ни у одной группы. О выборе весов — в статье про среднее геометрическое и гармоническое.
Разница двух общих долей раскладывается на два слагаемых без остатка, если веса и уровни брать посередине между группами. Эффект состава (mix) — сдвиг веса сегмента, умноженный на его уровень, усреднённый по двум группам. Эффект уровня (rate) — сдвиг уровня, умноженный на вес сегмента, усреднённый по двум группам. Если взять за базу первую группу, появится третье слагаемое — взаимодействие; здесь оно поделено пополам между составом и уровнем.
Для скриптов эффект уровня равен 0,5 · 5 + 0,5 · 5 = +5 п. п.: у обоих сегментов средний вес 0,5 и прирост 5 пунктов. Эффект состава: (0,2 − 0,8) · 62,5 + (0,8 − 0,2) · 22,5 = −24 п. п. В сумме −19, как в таблице: +5 пунктов приходится на уровни внутри сегментов, −24 — на раздачу заявок. Приписать эти +5 самому скрипту можно, только если кроме типа заявки группы ничем не различались: в условном примере это так по построению.
Тот же механизм работает во времени, когда между месяцами меняется состав трафика. Такой случай разобран в материале «Почему метрика обманывает», в разделе «Конверсия выросла с 13% до 32%, хотя в каждом канале она упала» и следующем за ним: два периода и запрос с фиксированными весами. Здесь речь о группах внутри одного периода.
p′ − p = Σ (w′ᵢ − wᵢ) · (pᵢ + p′ᵢ) / 2 + Σ (wᵢ + w′ᵢ) / 2 · (p′ᵢ − pᵢ)Первая сумма — эффект состава, вторая — эффект уровня. Штрих помечает вторую группу или второй период.
Правда ли, что с телефона рабочее пространство создают реже?
В учебной базе продукта «Маяк» первый шаг после регистрации — создать рабочее пространство, событие workspace_created. Менеджер спрашивает, не хуже ли мобильный онбординг десктопного. Берём регистрации с 1 июля: в этот день запустили платный поиск, до него состав каналов был другим. Событие происходит в день регистрации, так что последняя когорта, 29 августа, уже зрелая.
Итоговая строка подтверждает подозрение. На десктопе пространство создали 1 067 человек из 1 789, это 59,64%, на мобильных — 973 из 1 782, или 54,60%. Разница −5,04 п. п. при 95%-м интервале ±3,24: ноль в него не попадает.
По каналам картина другая: +1,80, +0,35, −2,32 и −2,36 п. п., и каждый интервал (от ±5,2 до ±8,6) накрывает ноль. Ни в одном канале различия между устройствами не видно.
Дело в составе. Платный поиск — это 19,3% десктопных регистраций и 37,6% мобильных, а пространство в нём создают 37% пришедших против 50–75% в остальных каналах. У мобильной группы доля слабого канала почти вдвое больше.
Перебор разрезов учебной базы — период, устройство, страна и канал против активации, оплаты и активных дней — разворота знака, выходящего за пределы шума, не дал: устройство и страна на активацию в этих данных не влияют, её уровень задаёт канал. Поэтому разворот показан на условных числах, а здесь разница после поправки на канал становится неотличимой от нуля. Та же пара разрезов для конверсии в оплату разобрана в статье о сегментации пользователей: там разрыв между устройствами сокращается с 3,5 до 1,4 п. п.
| Канал | Десктоп, чел. | Десктоп, % | Мобильные, чел. | Мобильные, % | Разница, п. п. | 95% интервал, ± п. п. |
|---|---|---|---|---|---|---|
| organic | 694 | 64,99 | 575 | 66,78 | +1,80 | 5,24 |
| paid_search | 345 | 36,81 | 670 | 37,16 | +0,35 | 6,27 |
| partner | 322 | 51,86 | 220 | 49,55 | −2,32 | 8,57 |
| referral | 428 | 75,23 | 317 | 72,87 | −2,36 | 6,38 |
| все каналы | 1 789 | 59,64 | 1 782 | 54,60 | −5,04 | 3,24 |
Учебная база, регистрации с 1 июля 2026. В каналах столбцы почти равны, в сумме десктоп выше на 5 пунктов.
WITH flags AS (
  SELECT
    u.channel,
    u.device,
    CASE WHEN w.user_id IS NULL THEN 0 ELSE 1 END AS activated
  FROM users u
  LEFT JOIN (
    SELECT DISTINCT user_id
    FROM events
    WHERE event_name = 'workspace_created'
  ) w ON w.user_id = u.user_id
  WHERE u.signup_date >= DATE '2026-07-01'
)
SELECT
  COALESCE(channel, 'все каналы') AS channel,
  SUM(CASE WHEN device = 'desktop' THEN 1 ELSE 0 END) AS desktop_users,
  SUM(CASE WHEN device = 'desktop' THEN activated ELSE 0 END) AS desktop_activated,
  ROUND(100.0 * SUM(CASE WHEN device = 'desktop' THEN activated ELSE 0 END)
    / SUM(CASE WHEN device = 'desktop' THEN 1 ELSE 0 END), 2) AS desktop_pct,
  SUM(CASE WHEN device = 'mobile' THEN 1 ELSE 0 END) AS mobile_users,
  SUM(CASE WHEN device = 'mobile' THEN activated ELSE 0 END) AS mobile_activated,
  ROUND(100.0 * SUM(CASE WHEN device = 'mobile' THEN activated ELSE 0 END)
    / SUM(CASE WHEN device = 'mobile' THEN 1 ELSE 0 END), 2) AS mobile_pct
FROM flags
GROUP BY ROLLUP (channel)
ORDER BY GROUPING(channel), channel;
Сколько в этой разнице состава, а сколько уровня?
Разложение по формуле даёт: −5,04 = −4,93 (состав) − 0,11 (уровень). Почти вся разница между устройствами — это разная доля каналов.
Второй способ сказать то же самое — прямая стандартизация: обеим группам дают один состав и пересчитывают итог. Возьмём общий состав каналов по всем регистрациям с 1 июля. На нём десктоп даёт 57,12%, мобильные — 57,02%, разница −0,11 ± 3,18 п. п. С эффектом уровня это число совпало до сотых, и не случайно: это та же сумма сегментных разниц, только веса — общий состав вместо полусуммы двух составов. Группы почти равны по размеру (1 789 и 1 782), поэтому веса отличаются в четвёртом знаке; при неравных группах числа разойдутся.
По этим данным нельзя утверждать, что мобильный онбординг хуже. Доказательства равенства тоже нет: интервал примерно от −3,3 до +3,1 п. п. не исключает разницы в три пункта в любую сторону.
Разбивка не обязана съедать разницу. Приглашение коллеги (invite_sent) на десктопе отправили 25,66%, на мобильных 23,68%: −1,98 п. п. (приглашение отправляют на следующий день после регистрации, так что у когорты 29 августа день ещё не закрыт; без неё 25,80% и 23,84%). Эффект состава здесь −0,01, после стандартизации остаётся −1,97. В учебных данных приглашения от канала не зависят, поэтому пересчёт ничего не меняет; сама разница и до него, и после неотличима от нуля (±2,83 и ±2,88).
import numpy as np
import pandas as pd

# из запроса выше: регистрации с 1 июля, всего (n) и создали пространство (a)
t = pd.DataFrame({
    'channel':   ['organic', 'paid_search', 'partner', 'referral'],
    'n_desktop': [694, 345, 322, 428],
    'a_desktop': [451, 127, 167, 322],
    'n_mobile':  [575, 670, 220, 317],
    'a_mobile':  [384, 249, 109, 231],
}).set_index('channel')

p_d, p_m = t.a_desktop / t.n_desktop, t.a_mobile / t.n_mobile              # уровень
w_d, w_m = t.n_desktop / t.n_desktop.sum(), t.n_mobile / t.n_mobile.sum()  # состав
var = p_d * (1 - p_d) / t.n_desktop + p_m * (1 - p_m) / t.n_mobile

for ch in t.index:
    print(f'{ch:12s} {(p_m[ch] - p_d[ch]) * 100:+.2f} ± {1.96 * np.sqrt(var[ch]) * 100:.2f} п. п.')

c_d, c_m = t.a_desktop.sum() / t.n_desktop.sum(), t.a_mobile.sum() / t.n_mobile.sum()
se = np.sqrt(c_d * (1 - c_d) / t.n_desktop.sum() + c_m * (1 - c_m) / t.n_mobile.sum())
mix = ((w_m - w_d) * (p_d + p_m) / 2).sum()
rate = ((w_d + w_m) / 2 * (p_m - p_d)).sum()
print(f'все каналы   {(c_m - c_d) * 100:+.2f} ± {1.96 * se * 100:.2f} п. п.'
      f' = состав {mix * 100:+.2f} + уровень {rate * 100:+.2f}')

# прямая стандартизация: обоим устройствам — общий состав каналов
w = (t.n_desktop + t.n_mobile) / (t.n_desktop.sum() + t.n_mobile.sum())
se_std = np.sqrt((w ** 2 * var).sum())
print(f'общий состав: десктоп {(w * p_d).sum():.2%}, мобильные {(w * p_m).sum():.2%},'
      f' разница {(w * (p_m - p_d)).sum() * 100:+.2f} ± {1.96 * se_std * 100:.2f} п. п.')
Какому числу верить: общему или по сегментам?
Арифметика на этот вопрос не отвечает: оба числа посчитаны верно. Выбор зависит от того, как устроены причины и о чём вы спрашиваете.
Если сегмент определён до воздействия и влияет и на попадание в группу, и на результат, смотрите внутри сегментов или стандартизуйте. Тип заявки известен до звонка, канал и устройство — до онбординга, тяжесть болезни — до лечения. В примере со скриптами прав сегментный вывод: B лучше.
Если сегмент — следствие воздействия, разбивка сама искажает сравнение. «Дослушал презентацию», «сделал экспорт», «дошёл до оплаты» случаются после, и такие группы отобраны самим воздействием. В статье про ошибку выжившего есть условный A/B-тест, где фильтр по дошедшим до шага переворачивает вывод в неверную сторону.
Общее число нужно, когда вопрос задан про итог при нынешнем составе. Какая доля мобильных регистраций дойдёт до рабочего пространства в следующем месяце, если состав каналов не изменится? Ответ — фактические 54,60%: платный поиск из мобильной аудитории никуда не денется, и стандартизованные 57,02% такого месяца не описывают.
У разбивки нет естественного конца: после канала можно делить по стране и дню недели, и знак может смениться снова — хотя бы из-за шума в мелких ячейках. Остановиться помогает список переменных, которые влияют и на попадание в группу, и на результат.
Разбивайте и стандартизуйте по тому, что было известно до воздействия и влияет и на попадание в группу, и на результат. По тому, что случилось после воздействия, итог не сравнивают: это уже его следствие. «Известно заранее» — условие необходимое, но не достаточное: признак должен быть общей причиной, а не просто ранним.
Может ли парадокс Симпсона появиться в A/B-тесте?
Рандомизация для того и нужна, чтобы составы совпали: людей распределяет жребий, и по любому признаку, известному до показа, варианты различаются только случайно. В эксперименте onboarding_checklist учебной базы десктопных пользователей 51,67% в контроле и 52,37% в тестовой группе.
При равном составе общий эффект лежит между сегментными. На десктопе чек-лист дал +19,75 п. п., на мобильных −0,16, в сумме +10,27 (по неокруглённым долям); после стандартизации по устройствам +10,20. Это неоднородность эффекта, а не парадокс: итог ничего не переворачивает, он усредняет два разных результата.
Та же арифметика возвращается, когда составы вариантов всё же разошлись, — только это уже поломка эксперимента, а не свойство данных. Первый случай — сломанное распределение, SRM (sample ratio mismatch): фактические доли групп расходятся с заданными, иногда только в одном сегменте. Условный пример с таким перекосом по устройствам есть в материале «Почему метрика обманывает».
Второй случай — доля теста менялась по ходу эксперимента. Если в первую неделю вариант получал 10% трафика, а потом 50%, то доля поздних пользователей в тестовой группе окажется заметно выше, чем в контрольной: в контроле много ранних, в тесте их почти нет. Когда конверсия по неделям разная, сравнивать нужно внутри периодов с одной долей. В учебном тесте доля чек-листа по неделям держится между 49,1% и 53,2%.
SELECT
  x.variant,
  COUNT(*) AS users,
  ROUND(100.0 * SUM(CASE WHEN u.device = 'desktop' THEN 1 ELSE 0 END) / COUNT(*), 2) AS desktop_share_pct,
  ROUND(100.0 * SUM(CASE WHEN x.converted THEN 1 ELSE 0 END) / COUNT(*), 2) AS conversion_pct,
  ROUND(100.0 * SUM(CASE WHEN u.device = 'desktop' AND x.converted THEN 1 ELSE 0 END)
    / SUM(CASE WHEN u.device = 'desktop' THEN 1 ELSE 0 END), 2) AS desktop_pct,
  ROUND(100.0 * SUM(CASE WHEN u.device = 'mobile' AND x.converted THEN 1 ELSE 0 END)
    / SUM(CASE WHEN u.device = 'mobile' THEN 1 ELSE 0 END), 2) AS mobile_pct
FROM experiment_exposures x
JOIN users u ON u.user_id = x.user_id
WHERE x.experiment_name = 'onboarding_checklist'
GROUP BY x.variant
ORDER BY x.variant DESC;Бывает ли парадокс Симпсона у наклона регрессии?
Да. Наклон — это тоже связь, и общий наклон по всем точкам может иметь другой знак, чем наклоны внутри групп. Пример условный: три сегмента клиентов, по оси x — обращения в поддержку за месяц, по оси y — выручка с клиента в тысячах рублей.
Внутри каждого сегмента линия идёт вниз: наклоны −1,20, −1,40 и −1,57. По всем 18 точкам сразу наклон равен +1,66. Крупные клиенты и обращаются чаще, и платят больше, поэтому облака выстроились лесенкой вверх. Вывод «чем больше обращений, тем выше выручка» описывает различие между сегментами. О клиенте, у которого обращений стало больше, он ничего не говорит.
На учебной базе такого примера нет. По когортам «день регистрации × канал» наклон числа экспортов по числу созданных пространств равен 0,37 по всем строкам и 0,38 внутри каналов: знак и величина совпадают. Проверка всегда одна — посчитать наклон после вычитания средних своего сегмента. И следить, чтобы в одной строке стояли одни и те же люди: экспорт в этой базе делают через два дня после регистрации, и в таблице «календарный день × канал» рядом окажутся пространства сегодняшних новичков и экспорты позавчерашних. Как считать наклон и его интервал — в статье о линейной регрессии.
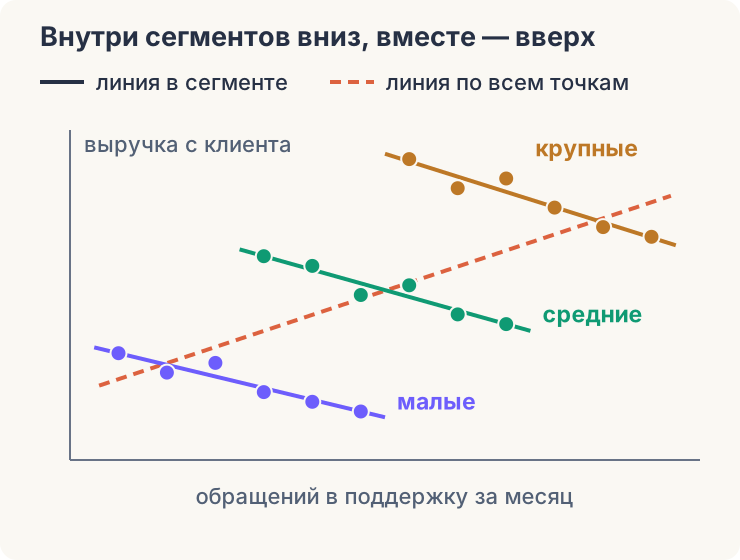
import numpy as np

# условные числа: обращений в поддержку за месяц и выручка с клиента, тыс. руб.
segments = {
    'малые':   ([1, 2, 3, 4, 5, 6],    [15, 13, 14, 11, 10, 9]),
    'средние': ([4, 5, 6, 7, 8, 9],    [25, 24, 21, 22, 19, 18]),
    'крупные': ([7, 8, 9, 10, 11, 12], [35, 32, 33, 30, 28, 27]),
}
for name, (x, y) in segments.items():
    print(f'{name:8s} наклон {np.polyfit(x, y, 1)[0]:+.2f}')

x_all = np.concatenate([x for x, _ in segments.values()])
y_all = np.concatenate([y for _, y in segments.values()])
print(f'все точки наклон {np.polyfit(x_all, y_all, 1)[0]:+.2f}')
Какие примеры парадокса Симпсона считаются классическими?
Название идёт от статьи Эдварда Симпсона «The Interpretation of Interaction in Contingency Tables» в Journal of the Royal Statistical Society (1951). Парадоксом Симпсона эффект назвал Колин Блит в 1972 году. Похожие наблюдения раньше публиковали Карл Пирсон (1899) и Удни Юл (1903), отсюда второе название — «эффект Юла — Симпсона».
Приём в аспирантуру Беркли. На осенний набор 1973 года заявки подали 8 442 мужчины и 4 321 женщина, приняли около 44% мужчин и около 35% женщин. Бикел, Хаммел и О'Коннелл в журнале Science (1975) показали, что женщины чаще подавали на программы, куда трудно поступить любому. С поправкой на это авторы нашли небольшой, но статистически значимый перевес в пользу женщин.
Камни в почках. Исследование Чарига и соавторов в British Medical Journal (1986) сравнивало способы удаления камней; как пример парадокса его разобрали Джулиус и Малли в том же журнале в 1994 году. Открытая операция успешнее и при мелких, и при крупных камнях, а в сумме выигрывает чрескожный метод. На крупные камни пришлось 75% открытых операций и 23% чрескожных. Методы не распределяли случайно: это две серии по 350 пациентов, и состав по размеру камней у них разный.
| Камни | Открытая операция | Чрескожный метод |
|---|---|---|
| меньше 2 см | 81 из 87 = 93% | 234 из 270 = 87% |
| 2 см и больше | 192 из 263 = 73% | 55 из 80 = 69% |
| все | 273 из 350 = 78% | 289 из 350 = 83% |
Как заметить парадокс Симпсона в своих данных?
Признак один: сравниваемые группы различаются составом по признаку, от которого зависит метрика.
У пересчёта две ловушки. Первая — чьи веса взяты. На составе десктопа разница между устройствами равна −0,22 п. п., на составе мобильных +0,01, на общем −0,11. Здесь все три в пределах шума, но в отчёте состав называйте явно. Вторая — простое среднее сегментных долей: 57,22% и 56,59%, разница −0,63. Это стандартизация с весами по 25% на канал, которых нет ни у одной группы.
WITH cell AS (
  SELECT
    u.channel,
    u.device,
    COUNT(*) AS users,
    COUNT(w.user_id) AS activated
  FROM users u
  LEFT JOIN (
    SELECT DISTINCT user_id
    FROM events
    WHERE event_name = 'workspace_created'
  ) w ON w.user_id = u.user_id
  WHERE u.signup_date >= DATE '2026-07-01'
  GROUP BY u.channel, u.device
),
mix AS (
  SELECT channel, 1.0 * SUM(users) / SUM(SUM(users)) OVER () AS share
  FROM cell
  GROUP BY channel
)
SELECT
  c.device,
  SUM(c.users) AS users,
  ROUND(100.0 * SUM(c.activated) / SUM(c.users), 2) AS actual_pct,
  ROUND(SUM(m.share * 100.0 * c.activated / c.users), 2) AS standardized_pct
FROM cell c
JOIN mix m ON m.channel = c.channel
GROUP BY c.device
ORDER BY c.device;- Сравните состав групп по признакам, известным до воздействия: канал, устройство, страна, тариф, месяц регистрации.
- Рядом с долей каждого сегмента поставьте его вес в каждой группе.
- Разложите разницу на эффект состава и эффект уровня.
- Пересчитайте обе группы к одному составу и укажите, чей он.
- Для сегментов считайте интервалы; мелкие сегменты объедините. У партнёрского канала на мобильных 220 человек и интервал ±8,57 п. п.
Чем парадокс Симпсона отличается от ошибки выжившего и конфаундера?
Парадокс Симпсона описывает арифметику: знак связи в группах и в сумме расходится. Смешивающая переменная, или конфаундер, — понятие причинное: она влияет и на попадание в группу, и на результат. Конфаундер — обычная причина парадокса, но искажает он и без разворота знака: в примере с устройствами канал создал разницу в 5 пунктов. Ещё два соседних понятия — в таблице.
| Понятие | В чём суть | Пример | Что помогает |
|---|---|---|---|
| Парадокс Симпсона | Связь в группах и в сумме имеет разный знак или исчезает | Скрипт лучше в каждом сегменте и хуже в целом | Вес рядом с долей, стандартизация |
| Смешивающая переменная | Третья переменная влияет и на воздействие, и на результат | От канала зависят и доля мобильных, и активация | Сравнение внутри слоёв, эксперимент |
| Ошибка выжившего | В данные попали только дошедшие до момента наблюдения | Средняя выручка по активным подпискам | Знаменатель от входа в когорту |
| Экологическая ошибка | Вывод о людях сделан по данным о группах | По средним трёх сегментов решили, что обращения повышают выручку клиента | Данные на уровне клиента |
Частые вопросы
Парадокс Симпсона — это ошибка в данных? Нет. Запрос и данные могут быть безупречны: общее число и сегментные посчитаны верно. Ошибкой становится вывод, когда общий итог читают как свойство каждого сегмента или наоборот.
Почему это называют парадоксом, если всё объясняют веса? Он спорит с интуицией «лучше в каждой части — значит, лучше в целом». Она верна при одинаковом составе групп, а о составе интуиция молчит.
Чем парадокс Симпсона опасен на практике? Решением в неверную сторону. В примере со скриптами отдел по общей таблице вернул бы старый скрипт, хотя внутри каждого типа заявок новый лучше на 5 пунктов.
Нужно ли всегда разбивать данные на сегменты? Нет. Разбивка по следствию воздействия искажает сравнение, а по десятку признаков сразу дробит выборку до ячеек, где случайность сильнее эффекта.
Что читать дальше
Все запросы статьи выполняются в песочнице симулятора SQL-аналитика на этой же базе. Упражнение: замените в первом запросе workspace_created на report_created и подставьте результат в блок на Python. Должно получиться 39,24% на десктопе и 34,74% на мобильных, разница −4,50 ± 3,16 п. п.; из неё около −3,3 — состав и −1,2 — уровень, а после стандартизации остаётся −1,21 ± 3,17.
Материалы по теме
Корреляция и причинность: как проверить связь до того, как назвали её причиной
Разбор на учебной базе курса: связь «создал отчёт — дольше остаётся» выглядит убедительно и статистически значима, но полностью объясняется каналом привлечения. Как это увидеть в SQL и что делать дальше.
Ошибка выжившего: что это, примеры и как она искажает анализ
Ошибка выжившего простыми словами: вывод по тем, кто остался. История Вальда без легенд и четыре примера из аналитики продукта с SQL и Python: выручка, удержание, опрос, A/B-тест.
Закон больших чисел простыми словами: формулировка и примеры
Закон больших чисел: почему среднее и доля стабилизируются с ростом выборки. Пример с монетой, накопленная конверсия A/B-теста в SQL, слабая и сильная форма, ошибка игрока и когда закон работает медленно.