Бутстреп в статистике: интервалы для метрик A/B-теста
Как построить процентильный бутстреп по пользователям: разница средней выручки, медиана и ARPPU на учебном A/B-тесте, код Python и ограничения метода.
Содержание статьи
Бутстреп оценивает разброс статистики повторным взятием наблюдений из имеющейся выборки с возвращением. В A/B-тесте пересэмплируйте независимо внутри каждой группы и на той единице, которую назначали: игроках, а не их платежах. Разность статистик в тысячах повторов образует эмпирическое распределение; его 2,5-й и 97,5-й процентили дают простой 95%-й процентильный интервал. Он полезен для сложных метрик, но не делает маленькую или испорченную выборку надёжной. Ниже — расчёт для средней выручки, медианы и ARPPU на учебной игре DragonKeep.
Зачем бутстреп продуктовой команде
Продакт видит: скидка на стартовый набор подняла долю покупателей. Он хочет знать, выросла ли выручка на назначенного игрока. У этой величины почти все значения нулевые, а редкие большие платежи формируют длинный хвост. Одна разница средних не показывает, сколько неопределённости принесёт следующий такой же набор игроков. Бутстреп строит приближённое распределение именно нужной статистики, сохраняя форму наблюдённых пользовательских данных.
Для простой доли можно использовать аналитическую формулу. Для суммы платежей за 14 дней, условной средней среди плательщиков и медианы она менее удобна или отвечает другому вопросу. Бутстреп помогает сравнивать оценки в общей процедуре. Его результат всё равно зависит от качества назначения, горизонта метрики, независимости игроков и того, насколько выборка представляет популяцию будущего запуска.
Сначала назовите оценку, а потом метод
В starter_pack_99 игроку назначали control с ценой 129 ₽ или test с ценой 99 ₽. Источник варианта — exposures.variant при exp_id = starter_pack_99. Платежи собираются по user_id в полуоткрытом окне от exposure_date до 14-го дня после него. Пользователь без платежей остаётся нулём в знаменателе. Группы содержат 8 690 и 8 622 назначенных игроков; покупателей 402 и 383 соответственно.
Решение о скидке разумно привязать к ARPU, то есть общей выручке на всех назначенных. ARPPU отвечает, сколько в среднем оставил тот, кто заплатил. Плательщик определяется уже после назначения, поэтому ARPPU сравнивает отобранные тестом группы и не является оценкой эффекта на всех игроков. Медиана ещё один вопрос: что случилось с типичным игроком? Если больше половины не платят, она будет нулём при совершенно разных денежных итогах.
| Статистика | Кого включает | Какое решение поддерживает |
|---|---|---|
| ARPU | всех назначенных, включая нули | окупается ли изменение цены |
| Медиана | всех назначенных | что изменилось у типичного игрока |
| ARPPU | только заплативших | как изменился чек выбранной постфактум группы |
Что происходит в одной итерации
Допустим, в контроле n игроков. Случайно выбираем n индексов из этих же n игроков с возвращением. Кто-то попадёт дважды, кого-то не будет. Из тестовой группы отдельно берём столько же индексов, сколько там было игроков. Для двух новых выборок считаем средние и разницу test минус control. Возвращаем исходные данные и повторяем. Процентили распределения разниц, а не процентили отдельных пользовательских платежей, образуют искомый интервал.
Нельзя объединить обе группы и пересэмплировать общий мешок, если цель — интервал эффекта между назначенными вариантами: это меняет структуру сравнения. Нельзя и брать отдельно платежи: игрок с пятью платежами станет пятью независимыми людьми. Если назначение было по семье или магазину, пересэмплировать нужно кластеры назначения. Бутстреп повторяет статистическую единицу дизайна, иначе точность окажется нарисованной.
Для проверки логики удобно начать с миниатюрной таблицы из четырёх игроков в каждой группе. Выпишите случайные индексы первой итерации и руками пересчитайте сумму. Один индекс может повториться, поэтому полученная выборка обычно отличается от исходной даже при той же длине. Затем удостоверьтесь, что число строк контроля и теста в каждой итерации осталось прежним. Такая ручная проверка ловит распространённую ошибку в коде: генератор индексов для контроля случайно получает длину тестовой группы. При разных размерах вариантов это не всегда вызывает исключение, но искажает процедуру.
Расчёт с фиксированным seed
Код ниже читает выгрузки учебной игры, оставляет каждого назначенного игрока и считает 2 000 пар повторных выборок. Повторы выполняются пакетами по сто, чтобы не строить огромный массив всех индексов сразу. Seed фиксирует именно этот вычислительный результат; смена seed немного сдвинет процентили, особенно у метрик с редкими дорогими платежами. Запустите из корня репозитория с зависимостями из apps/site/research/ab-testing/requirements.txt.
import numpy as np
import pandas as pd
base = 'dataset/gamedev/'
e = pd.read_csv(base+'exposures.csv', parse_dates=['exposure_date'])
p = pd.read_csv(base+'payments.csv', parse_dates=['payment_date'])
e = e.loc[e.exp_id.eq('starter_pack_99'), ['user_id','variant','exposure_date']]
j = e.merge(p, on='user_id', how='left')
j = j.loc[j.payment_date.ge(j.exposure_date) & j.payment_date.lt(j.exposure_date+pd.Timedelta(days=14))]
r = e[['user_id','variant']].merge(j.groupby('user_id').amount_rub.sum(), on='user_id', how='left').fillna({'amount_rub':0})
a = r.loc[r.variant.eq('control'),'amount_rub'].to_numpy()
b = r.loc[r.variant.eq('test'),'amount_rub'].to_numpy()
rng = np.random.default_rng(20260928)
draws, medians = [], []
for _ in range(20):
    ai = rng.integers(len(a), size=(100,len(a)))
    bi = rng.integers(len(b), size=(100,len(b)))
    draws.extend((b[bi].mean(1)-a[ai].mean(1)).tolist())
    medians.extend((np.median(b[bi],axis=1)-np.median(a[ai],axis=1)).tolist())
ci = np.quantile(draws,[.025,.975])
ap,bp = a[a>0],b[b>0]
rng = np.random.default_rng(20260928)
payer_draws=[]
for _ in range(20):
    ai=rng.integers(len(ap),size=(100,len(ap)))
    bi=rng.integers(len(bp),size=(100,len(bp)))
    payer_draws.extend((bp[bi].mean(1)-ap[ai].mean(1)).tolist())
print(len(a), len(b), round(b.mean()-a.mean(),4), np.round(ci,4))
print('median',np.quantile(medians,[.025,.975]),'ARPPU',np.round(np.quantile(payer_draws,[.025,.975]),4))
assert len(a)==8690 and len(b)==8622
assert np.allclose(ci,[-10.6029,5.7025],atol=.0001)
assert np.allclose(np.quantile(payer_draws,[.025,.975]),[-178.7869,131.675],atol=.0001)
Средняя выручка: эффект и интервал
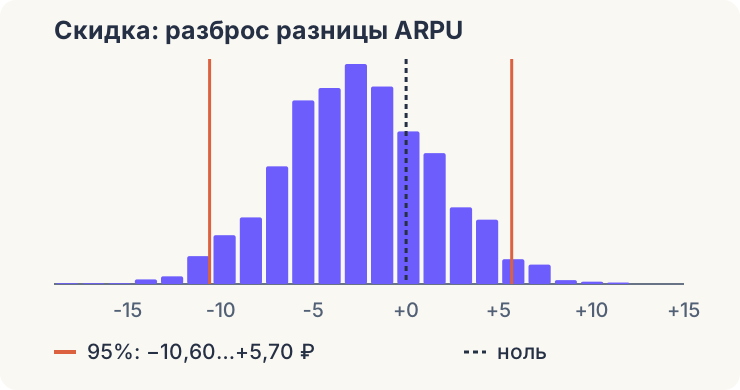
У control получилось 35,33 ₽ на игрока, у test — 32,85 ₽. Точечная разница −2,49 ₽; процентильный 95%-й интервал от −10,60 до +5,70 ₽. Интервал захватывает и ощутимый убыток, и небольшой выигрыш. Из этих данных нельзя сделать уверенный вывод, что скидка повысила общий денежный результат. Это не доказательство нулевого эффекта: отрицательные и положительные значения в разумном диапазоне по-прежнему совместимы с наблюдением.
Для решения нужны порог приемлемого снижения дохода, издержки акции и заранее обозначенный горизонт. Если доля покупок — вспомогательная метрика, её рост не заменяет денежную проверку. Научиться читать такую таблицу для менеджера поможет разбор результатов A/B-теста. При высокой цене ошибки скидку не раскатываем только потому, что конверсия выглядит лучше.
Число −2,49 ₽ нельзя превращать в «убыток 2,49 ₽ на каждом будущем игроке». Оно получено на конкретном потоке учебных установок и служит точечной оценкой разницы средних, а не гарантированным исходом. Отдельно от статистики проверьте денежную единицу: сумма платежей в выгрузке — валовая выручка, тогда как решение о цене может зависеть от комиссии магазина, себестоимости виртуальных товаров и возвратов. Если экономика учитывает другую величину, соберите её на том же назначенном игроке и том же 14-дневном горизонте. Нельзя менять определение после того, как посмотрели знак результата.
Медиана: честный интервал, бесполезный ответ
Медиана выручки в обеих группах равна нулю. В 2 000 повторных выборок разница медиан тоже нулевая; 95%-й интервал — [0; 0]. Это не означает, что эффект на выручку точно равен нулю. Более 95% игроков не совершили покупку, поэтому середина распределения не реагирует на изменения среди немногочисленных плательщиков. Статистика аккуратно отвечает на собственный вопрос, но команда спрашивала о деньгах.
Если у вас много нулей, заранее продумайте две части: вероятность покупки и условную сумму платежа. Их произведение связано с ARPU, но каждая часть в отдельности может двигаться в противоположную сторону. Не выбирайте медиану лишь потому, что её бутстреп-интервал выглядит «стабильнее» широкого интервала средней: стабильный ноль не даёт гарантии сохранения общей выручки.
ARPPU: другая популяция и длинный хвост
Среди оплативших ARPPU составляет 763,81 ₽ в control и 739,41 ₽ в test: разница −24,40 ₽. Если пересэмплировать отдельно плательщиков в группах, процентильный интервал разницы выйдет от −178,79 до +131,68 ₽. Он широк: покупки редки, а отдельные крупные суммы заметно меняют среднюю. Здесь 402 и 383 плательщика, а не тысячи независимых денежных наблюдений.
Интервал ARPPU описывает условное сравнение состава платящих; скидка может изменить сам состав. Если убрать нули из ARPU и назвать полученный показатель «эффектом на выручку», выборка будет зависеть от варианта теста. Для решения о цене оставьте основной оценкой ARPU на всех назначенных, а ARPPU используйте для диагностики механизма вместе с conversion to payer.
Удобная декомпозиция — ARPU = доля покупателей × ARPPU, если каждый платёж отнесён к тому же окну и покупатель определён хотя бы одним платежом. Но изменения множителей не независимы: скидка может привлечь тех, кто покупает только дешёвый набор, или сместить время первого платежа. Поэтому два отдельных интервала не надо механически перемножать для интервала ARPU. В каждом повторе бутстрепа можно заново вычислить долю покупателей и условную среднюю, а их произведение сверить с напрямую посчитанной пользовательской средней. Такая сверка особенно полезна, если в платежной таблице есть дубли и возвраты.
| Оценка | Control → test | Разница и 95%-й процентильный интервал |
|---|---|---|
| ARPU | 35,33 → 32,85 ₽ | −2,49 ₽; [−10,60; +5,70] |
| Медиана | 0 → 0 ₽ | 0 ₽; [0; 0] |
| ARPPU среди плательщиков | 763,81 → 739,41 ₽ | −24,40 ₽; [−178,79; +131,68] |
Почему 2 000 повторов — рабочий, а не магический выбор
Число повторов влияет на шум границ интервала. Для быстрой диагностики сотни повторов часто достаточно, но крайние процентили требуют больше: при 2 000 повторов 2,5-й процентиль находится примерно у 50-й упорядоченной оценки. При 200 повторах это около пятой; одно необычное повторение сдвинет границу сильнее. Сравните результат при 2 000 и 5 000 повторов с другим seed: если практическое решение переворачивается, вычислительная неопределённость ещё значима.
Стабильность границ можно измерить, а не оценивать на глаз. Запустите несколько независимых серий по 2 000 повторов, каждый раз с заранее назначенным seed, и посмотрите разброс нижней и верхней границ. Если границы гуляют на десятые доли рубля, а бизнес-порог отстоит на десятки рублей, дополнительных повторов почти наверняка не нужно. Если граница прыгает через порог релиза, увеличьте число повторов и сохраните все версии расчёта. Повторный запуск снижает только ошибку Монте-Карло: он не добавляет новых исходных игроков и не сужает настоящую неопределённость эксперимента.
В контрольном расчёте 2 000 повторов средней и медианы считались около 0,3 секунды на конкретной машине с пакетной векторизацией NumPy. Это не норматив для ноутбука или облака: время растёт с числом пользователей, повторов, метрик и сложностью вычисления оценки. Медленный ресэмплинг по строкам Python может занять существенно больше. Фиксируйте версию кода, seed и число повторов в отчёте, иначе результат трудно воспроизвести.
Когда процентильный бутстреп вводит в заблуждение
Процентильный интервал не является универсальным точным интервалом. При маленькой выборке крайние исходы могут вообще не попасть в неё; пересэмплирование не создаст неизвестных больших платежей. Для сильно смещённой оценки или границы параметра процентильная конструкция может иметь не тот охват, который написан на этикетке. Проверьте чувствительность к более подходящим интервалам, например BCa, и к бизнес-порогам; не объявляйте метод «непараметрическим спасением» для любой ситуации.
Другой риск — зависимость. Сеансы одного игрока, платежи одного аккаунта, магазины одного холдинга или связанные друзья не становятся независимыми от добавления случайного seed. При временных рядах нужен отдельный дизайн ресэмплинга, учитывающий структуру во времени. Если из эксперимента выпали назначенные пользователи, бутстреп аккуратно повторит и смещение. Диагностика сплита, пропусков и зрелости окна предшествует вычислению интервала.
Отдельно проверьте, что исходный набор покрывает крайние наблюдения. Если несколько «китов» оставляют почти всю выручку, полезно показать вклад верхнего одного процента и повторить расчёт после документированной проверки этих платежей на ошибки. Удалять валидных китов только потому, что интервал получился широким, нельзя: вместе с ними вы удалите часть реального бизнес-эффекта. Winsorization, логарифмирование и ограничение платежей — разные метрики с разными последствиями, и их правило нужно выбирать до открытия вариантов. Для суммы денег на игрока тяжёлый хвост — свойство продукта, которое оценка должна выдержать.
Пять ошибок, меняющих решение
Первая: пересэмплировать платежи вместо игроков. Самые активные покупатели создадут видимость гигантской выборки, интервал сузится, скидку могут раскатить преждевременно. Вторая: исключить нулевых игроков из ARPU. Результат станет ARPPU и больше не измерит доход на назначенного. Третья: брать общий мешок control и test для интервала эффекта. Такой код разрушит различие групп и оценит иную процедуру.
Четвёртая: объявить [0; 0] для медианы доказательством безвредности скидки. Денежный риск останется в хвосте. Пятая: заменить 14-дневный горизонт более длинным только для ранних участников, чтобы получить больше покупок. Это смешает эффект с разной зрелостью когорт. Шестая: выбирать seed, давший «значимый» интервал, и не показывать остальные прогоны. Это форма поиска удобного ответа; фиксируйте алгоритм до чтения результатов.
Как интерпретировать интервал без обещания
Процентильный интервал — диапазон границ бутстреп-распределения разницы. При повторении всей процедуры отбора и построения интервала корректно калиброванный метод стремится накрывать фиксированный параметр с заявленной частотой; конкретному интервалу нельзя приписывать вероятность 95%, что истинный эффект внутри. Для практики достаточно запомнить: интервал показывает совместимые с данными масштабы изменения в принятой модели и дизайне.
Если ваша цена ошибки зависит от величины убытка, сравните нижнюю границу с допустимым порогом, а не только с нулём. Интервал до +5,70 ₽ не гарантирует выгоду, нижняя граница −10,60 ₽ требует оценки риска. Сама статистика не назначит бизнес-порог. Его задают до анализа, затем решение документируют вместе с неопределённостью и ограничениями дизайна.
Полезно заранее разделить два возможных вывода. «Мы не доказали рост ARPU» означает, что интервал пересекает ноль. «Мы доказали, что потери меньше допустимых трёх рублей» требовало бы, чтобы нижняя граница была выше −3 ₽; здесь она намного ниже. Эти утверждения не взаимозаменяемы. Если цель была не заработать, а повысить доступность покупки при допустимом небольшом снижении дохода, нужен заранее названный порог нехуже: тогда сравнение с нулём даже не основной тест решения. Интервал позволяет оценить оба вопроса, но правило нельзя придумать по его конечным точкам.
Частые вопросы о бутстрепе
Бутстреп заменяет t-тест? Он может дать интервал для той же разницы средних и особенно удобен для сложной оценки. Но плохой дизайн, зависимость и смещение отбора он не исправляет. Для большой пользовательской выборки t-тест Уэлча может дать близкий ответ; сравнивайте методы под один и тот же estimand, как в разборе Манна — Уитни.
Нужно ли пересэмплировать без возвращения? Нет: обычный непараметрический бутстреп берёт с возвращением. Выбор без возвращения той же длины просто переставит исходные наблюдения и не даст нужного разброса оценки.
Почему медиана не меняется при скидке? Более половины игроков в обеих группах имеют нулевую выручку. Медиана не чувствует сдвигов среди немногих платящих, пока они не переместят середину распределения.
Можно ли брать 10 000 повторов вместо 2 000? Да, если вычисление доступно. Это уменьшит вычислительный шум процентилей, но не увеличит число реальных игроков и не исправит нарушение независимости.
Решение по скидке и следующий шаг
В учебном starter_pack_99 точечная оценка ARPU отрицательна, а интервал допускает заметный минус и небольшой плюс. На основании одной конверсии скидку на всех игроков не раскатываем. Проверьте экономику маржи, заранее определите допустимый убыток на пользователя и, если есть трафик, спланируйте следующий тест под этот порог. Положительная конверсия и нулевая медиана не перекрывают неопределённость денег.
Для обычной бинарной основной метрики начните с калькулятора значимости и проверьте соответствие единицы анализа назначению. Полный порядок от гипотезы до решения — в хабе A/B-тестирования. В практикуме SQL-аналитика можно потренировать сегментный разбор A/B: перейти к симулятору.
Материалы по теме
Центральная предельная теорема простыми словами: зачем она аналитику
Центральная предельная теорема (ЦПТ): почему среднее скошенной метрики распределено почти нормально, как считать стандартную ошибку среднего σ/√n и почему правило «n ≥ 30» не закон. Симуляция на выручке из учебной базы.
Калькулятор значимости A/B-теста: как посчитать и как прочитать результат
Как посчитать статистическую значимость A/B-теста по двум конверсиям: какие числа нужны, что означает p-value и доверительный интервал разницы, и когда расчёт вообще не применим.
p-value простыми словами: что он показывает и чего не доказывает
Что на самом деле измеряет p-value, почему 0,05 — не граница истины, как читать его вместе с доверительным интервалом и что делать, когда результат «незначим».