Коэффициент детерминации R²: формула, как читать и шкала Чеддока
Что показывает коэффициент детерминации R²: формула, связь с корреляцией, шкала Чеддока, скорректированный и отрицательный R². Расчёт в SQL, Python и Excel на примерах.
Содержание статьи
Коэффициент детерминации R² (R-квадрат) — доля разброса (дисперсии) величины y, которую описывает модель: R² = 1 − SS_res / SS_tot, где SS_res — сумма квадратов промахов модели, а SS_tot — сумма квадратов отклонений y от среднего. Для парной линейной регрессии, прямой с одним x, он равен квадрату коэффициента корреляции: R² = r². В отчёте это строка «R² = 0,77», за которой следует вопрос: много это или мало. Ниже — расчёт руками, в SQL, Python и Excel, что на самом деле написано в шкале Чеддока, и случаи, когда высокий R² ничего не обещает.
Что показывает коэффициент детерминации простыми словами
Допустим, о дневной выручке известно только её среднее. Тогда прогноз на любой день — само среднее, а квадраты его промахов в сумме дают SS_tot. Теперь появилась модель — например, прямая, которая предсказывает выручку по числу активных пользователей. Квадраты её промахов, остатков, дают SS_res.
R² сравнивает эти суммы. Модель промахивается так же, как среднее, — SS_res равна SS_tot и R² = 0. Попадает в каждую точку — SS_res = 0 и R² = 1. Значение 0,64 читают так: модель убрала 64% разброса, который остаётся при прогнозе средним, 36% осталось в остатках.
Пересчитаем руками на пяти неделях рекламы из статьи о линейной регрессии: бюджет 10, 20, 30, 40 и 50 тысяч рублей, регистраций — 30, 50, 40, 70 и 60. Среднее число регистраций — 50, квадраты отклонений от него — 400, 0, 100, 400 и 100, в сумме 1 000. Прямая 26 + 0,8 · бюджет оставляет остатки −4, 8, −10, 12 и −6, сумма их квадратов — 360. R² = 1 − 360 / 1 000 = 0,64.
Коэффициент корреляции для этих точек равен 0,8, и 0,8² — те же 0,64. Равенство R² = r² верно для прямой с одним x и свободным членом (слагаемым без x), подобранной методом наименьших квадратов. У других моделей формула через суммы квадратов остаётся, а связь с r пропадает.
R² = 1 − SS_res / SS_tot = 1 − Σ(y − ŷ)² / Σ(y − ȳ)²ŷ — значение модели, ȳ — среднее y. SS_res — сумма квадратов остатков, SS_tot — общая сумма квадратов. Для прямой с одним x и свободным членом, оценённой на данных, по которым она подобрана: R² = r².
SELECT
  round(CAST(regr_r2(y, x) AS numeric), 2) AS r2,
  regr_syy(y, x) AS ss_tot,
  regr_syy(y, x) - regr_sxy(y, x) * regr_sxy(y, x) / regr_sxx(y, x) AS ss_res,
  round(CAST(corr(y, x) AS numeric), 2) AS r
FROM (VALUES (10, 30), (20, 50), (30, 40), (40, 70), (50, 60)) AS t(x, y);
Как посчитать R² в SQL
Рабочий пример — учебная база сервиса: события пользователей и оплаты в долларах. Строка — день: DAU, число людей хотя бы с одним событием за день, и выручка, сумма оплат. Берём 90 дней с 1 июня по 29 августа 2026 года: 30 августа события обрываются в 13:00, и неполный день в расчёт не идёт. День без оплат — ноль выручки, отсюда LEFT JOIN и COALESCE.
В PostgreSQL и DuckDB есть агрегат regr_r2(y, x): сначала зависимая величина, потом фактор. Документация PostgreSQL описывает его как квадрат коэффициента корреляции, то есть это R² прямой с одним x. Запрос считает то же ещё двумя способами — через corr и по определению, через остатки линии. Все три дают 0,773.
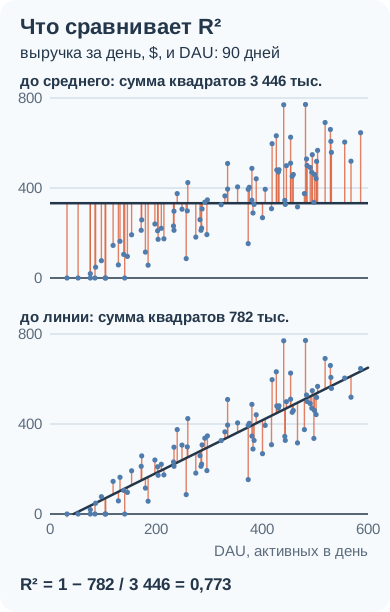
Общая сумма квадратов — 3 446 тысяч, сумма квадратов остатков — 782 тысячи: линия оставила 23% исходного разброса. На схеме это отрезки: вверху — от каждой точки до среднего, 332 доллара, внизу — до линии.
Две особенности функции. Она возвращает число с плавающей точкой, а round с двумя аргументами в PostgreSQL принимает только numeric — отсюда CAST. И если y не меняется, результат — 1: за первые пять дней июня оплат не было, и regr_r2 для них равен единице, хотя объяснять там нечего.
WITH daily AS (
  SELECT d.day, d.dau, COALESCE(r.revenue, 0) AS revenue
  FROM (SELECT CAST(event_time AS date) AS day, count(DISTINCT user_id) AS dau
        FROM events GROUP BY 1) AS d
  LEFT JOIN (SELECT paid_at AS day, sum(amount) AS revenue
             FROM payments GROUP BY 1) AS r ON r.day = d.day
  WHERE d.day < DATE '2026-08-30'
),
model AS (
  SELECT regr_slope(revenue, dau) AS b, regr_intercept(revenue, dau) AS a,
    avg(revenue) AS mean_revenue
  FROM daily
)
SELECT
  count(*) AS days,
  round(CAST(sum((revenue - mean_revenue) * (revenue - mean_revenue)) AS numeric)) AS ss_tot,
  round(CAST(sum((revenue - (a + b * dau)) * (revenue - (a + b * dau))) AS numeric)) AS ss_res,
  round(CAST(1 - sum((revenue - (a + b * dau)) * (revenue - (a + b * dau)))
    / sum((revenue - mean_revenue) * (revenue - mean_revenue)) AS numeric), 3) AS r2_by_hand,
  round(CAST(regr_r2(revenue, dau) AS numeric), 3) AS r2_regr,
  round(CAST(corr(revenue, dau) * corr(revenue, dau) AS numeric), 3) AS r_squared
FROM daily CROSS JOIN model;
Что такое шкала Чеддока и откуда она взялась
Шкала Чеддока — словесные градации силы связи для коэффициента корреляции. Нижняя ступень, «слабая», — r от 0,1 до 0,3; верхняя, «весьма высокая», — от 0,9 до 0,99. В таком виде её приводят русскоязычные учебники; все ступени — в таблице. В статье о корреляции та же шкала показана с добавленной строкой 0–0,1 и верхней ступенью до 1.
Автор — Роберт Эммет Чеддок (Robert E. Chaddock, 1879–1940), американский статистик из Колумбийского университета. Шкала есть в его учебнике «Principles and Methods of Statistics» (Houghton Mifflin, 1925): раздел об истолковании коэффициента корреляции, страницы 303–304. Скан книги есть в Internet Archive.
Оригинал отличается от пересказа в четырёх местах. Нижняя ступень у Чеддока — всё, что меньше 0,3: связь слабая и сомнительная, особенно при малом числе наблюдений; границы 0,1 в книге нет. Вторая ступень дана с условием: связь умеренная, «если вероятная ошибка мала». Верхняя — «0,9 и выше», без 0,99. И сам автор называет своё деление «rather arbitrary», довольно произвольным, а сразу за списком напоминает: смысл коэффициента зависит от числа наблюдений, и причинной зависимости он не доказывает.
За пределами бывшего СССР шкалой, по-видимому, уже не пользуются — так пишут авторы обзора градаций корреляции (Котеров и др., «Медицинская радиология и радиационная безопасность», 2019).
| |r| | В русскоязычных учебниках | У Чеддока, 1925 | R² = r² |
|---|---|---|---|
| 0,1–0,3 | слабая | низкая, сомнительная (всё ниже 0,3) | 0,01–0,09 |
| 0,3–0,5 | умеренная | умеренная — если вероятная ошибка мала | 0,09–0,25 |
| 0,5–0,7 | заметная | заметная | 0,25–0,49 |
| 0,7–0,9 | высокая | высокая | 0,49–0,81 |
| 0,9–0,99 | весьма высокая | очень тесная (0,9 и выше) | 0,81–0,98 |
Можно ли оценивать R² по шкале Чеддока
Шкала составлена для r, а R² — его квадрат, и границы при возведении в квадрат сдвигаются. «Высокая» связь начинается с r = 0,7, а это R² = 0,49: модель, которая описывает половину разброса, по шкале уже хороша. Чтобы описать 81%, нужен r = 0,9.
Отсюда типичная ошибка — приложить шкалу прямо к R². В августе линия выручки по DAU даёт R² = 0,12. Это r = 0,35, «умеренная» связь; если же искать в таблице само число 0,12, выйдет «слабая».
Но и правильное чтение даёт мало. Августовский наклон посчитан по 29 дням, и его 95%-й доверительный интервал — диапазон значений, совместимых с данными, — идёт от −0,06 до 1,94 и включает ноль. «Умеренную» связь здесь нельзя отличить от её отсутствия. По оригиналу Чеддока она и «умеренной» не считается: его условие — малая ошибка — здесь не выполнено.
Шкала не знает ни числа наблюдений, ни шума самой величины, ни цели расчёта. О первом предупреждал сам Чеддок. Словесная оценка годится как сокращение в разговоре; вывод делают из остатков, интервалов и ошибки в единицах измерения.
Высокий R² значит, что модель верна?
Нет. R² сравнивает модель с единственным соперником — средним. Обойти среднее легко, когда ряд растёт, и для этого не нужно угадывать ни форму связи, ни её причину.
Форма. Прямая «DAU по номеру дня» даёт R² = 0,962 (r = 0,98), и при этом её остатки идут дугой: на краях квартала она завышает DAU на 22–25 человек, в середине занижает на 18–19 — разбор в статье о линейной регрессии. Парабола из статьи о методе наименьших квадратов дугу убирает при R² = 0,973: разница одиннадцать тысячных, а прогнозы на осень разные.
Общий тренд. Выручка по DAU — R² = 0,773. Если вместо DAU взять номер дня, выйдет 0,785: календарь описывает выручку не хуже аудитории. Обе величины росли весь квартал, и R² измеряет прежде всего этот общий рост. Модель с двумя факторами сразу, номером дня и DAU, даёт 0,788: поверх календаря DAU добавляет 0,3 процентного пункта.
Фраза «выручку на 77% определяет DAU» из этих чисел не следует. R² говорит, какую долю разброса модель описала на этих данных, и ничего — о том, откуда взялась связь.
WITH daily AS (
  SELECT d.day, d.dau, COALESCE(r.revenue, 0) AS revenue
  FROM (SELECT CAST(event_time AS date) AS day, count(DISTINCT user_id) AS dau
        FROM events GROUP BY 1) AS d
  LEFT JOIN (SELECT paid_at AS day, sum(amount) AS revenue
             FROM payments GROUP BY 1) AS r ON r.day = d.day
  WHERE d.day < DATE '2026-08-30'
)
SELECT
  round(CAST(regr_r2(revenue, dau) AS numeric), 3) AS revenue_by_dau,
  round(CAST(regr_r2(revenue, day - DATE '2026-06-01' + 1) AS numeric), 3) AS revenue_by_day_no,
  round(CAST(regr_r2(dau, day - DATE '2026-06-01' + 1) AS numeric), 3) AS dau_by_day_no
FROM daily;Почему на узком диапазоне R² падает, а ошибка — нет
Разрежем те же 90 дней на месяцы и построим в каждом свою линию выручки по DAU. В июне R² = 0,735, в июле — 0,331, в августе — 0,121. Читать это как «связь слабеет» рано: в формуле R² делят на разброс y вокруг среднего, а он зависит от того, насколько широко в окне меняется x.
За квартал DAU вырос с 32 до 586, и выручка вместе с ним: её стандартное отклонение — 197 долларов, линия оставляет 94. В августе DAU менялся от 406 до 586, стандартное отклонение выручки — 119 долларов, линия оставляет 114. Шум вокруг линии того же порядка, а общий разброс сжался до его размеров.
Июнь показывает вторую половину формулы. По ширине окна он почти равен июлю, но шум вокруг линии там почти вдвое меньше — 57 долларов против 105, — да и сама линия круче: 1,53 доллара на пользователя против 1,15. В итоге R² выше более чем вдвое. Поэтому R² моделей, построенных на разных выборках, не сравнивают: 0,735 в июне и 0,121 в августе не означают, что в июне связь была в шесть раз сильнее.
Второй вывод из таблицы — о точности. R² — безразмерная доля: пересчитайте выручку в центы, и он не изменится. Насколько модель промахивается, показывает стандартное отклонение остатков, и с R² оно может расходиться. Июньская линия: R² 0,735, типичный промах 57 долларов. Общая: R² 0,773, промах 94 доллара. По R² лучше вторая, по ошибке — первая. Тому, кто планирует выручку, нужен ответ «плюс-минус сколько», и в R² его нет.
| Окно | Дней | DAU | R² | Разброс вокруг линии | Разброс выручки |
|---|---|---|---|---|---|
| Июнь | 30 | 32–249 | 0,735 | 57,3 | 109,4 |
| Июль | 31 | 257–480 | 0,331 | 105,1 | 126,4 |
| Август | 29 | 406–586 | 0,121 | 113,9 | 119,3 |
| Все 90 дней | 90 | 32–586 | 0,773 | 94,3 | 196,8 |
WITH daily AS (
  SELECT d.day, d.dau, COALESCE(r.revenue, 0) AS revenue
  FROM (SELECT CAST(event_time AS date) AS day, count(DISTINCT user_id) AS dau
        FROM events GROUP BY 1) AS d
  LEFT JOIN (SELECT paid_at AS day, sum(amount) AS revenue
             FROM payments GROUP BY 1) AS r ON r.day = d.day
  WHERE d.day < DATE '2026-08-30'
),
labeled AS (
  SELECT 'все 90 дней' AS period, 0 AS sort_key, dau, revenue FROM daily
  UNION ALL
  SELECT CASE WHEN day < DATE '2026-07-01' THEN 'июнь'
              WHEN day < DATE '2026-08-01' THEN 'июль'
              ELSE 'август' END,
    CAST(EXTRACT(month FROM day) AS integer), dau, revenue
  FROM daily
)
SELECT
  period,
  count(*) AS days,
  min(dau) AS dau_from,
  max(dau) AS dau_to,
  round(CAST(regr_r2(revenue, dau) AS numeric), 3) AS r2,
  round(CAST(sqrt((regr_syy(revenue, dau)
    - regr_sxy(revenue, dau) * regr_sxy(revenue, dau) / regr_sxx(revenue, dau))
    / (count(*) - 2)) AS numeric), 1) AS sd_residual,
  round(CAST(stddev_samp(revenue) AS numeric), 1) AS sd_revenue
FROM labeled
GROUP BY period, sort_key
ORDER BY sort_key;Почему R² не падает от нового фактора и что такое скорректированный R²
Модель с несколькими факторами, y = b₀ + b₁·x₁ + b₂·x₂ + …, подбирают тем же методом наименьших квадратов, и R² считают по той же формуле. От нового столбца он не уменьшается: метод может дать новому фактору нулевой коэффициент и получить прежнюю сумму квадратов остатков, а любое случайное сходство столбца с остатками её уменьшает.
Проверим на шуме. К DAU добавим столбцы случайных чисел, не связанных с выручкой. Один столбец — R² растёт с 0,773 до 0,774. Десять — 0,805, сорок — 0,887, шестьдесят — 0,934. С 88 столбцами R² равен единице: в модели 90 коэффициентов на 90 дней, и она проходит через каждую точку.
Скорректированный (adjusted, в отчётах Excel — нормированный) R² штрафует за число факторов: сумму квадратов остатков он делит на n − p − 1, а общую — на n − 1. На пяти точках: 1 − (1 − 0,64) · 4 / 3 = 0,52. На 90 днях с одним фактором поправка мала: 0,773 и 0,771.
На шуме он ведёт себя сдержаннее: пока обычный R² поднимается до 0,934, скорректированный остаётся между 0,760 и 0,791. Защитой от лишних факторов он не служит. Скорректированный R² растёт, когда F-статистика добавленных столбцов больше 1 (для одного столбца — когда |t| > 1), а чистому шуму это удаётся часто: в 1 000 повторов с десятью другими столбцами шума он оказался выше исходного в 46% случаев. По одному этому числу фактор от шума не отличить: номер дня поднял его с 0,771 до 0,783, а сорок столбцов шума из таблицы — до 0,790.
R²adj = 1 − (1 − R²) · (n − 1) / (n − p − 1)n — число наблюдений, p — число факторов без свободного члена.
По горизонтали — число случайных столбцов. Приросты посчитаны до округления и могут отличаться от разницы округлённых R² на 0,1. Шаг по горизонтали неравномерный.
import numpy as np

# DAU и выручка по дням, 1 июня – 29 августа 2026 (90 закрытых дней)
dau = np.array([
    32, 53, 76, 85, 104, 86, 76, 97, 105, 129, 141, 139, 132, 119, 146,
    154, 172, 180, 204, 185, 173, 198, 210, 233, 234, 249, 215, 203, 234, 240,
    285, 287, 297, 275, 257, 260, 283, 296, 292, 330, 286, 259, 323, 335, 374,
    418, 401, 354, 335, 383, 376, 389, 432, 385, 381, 381, 374, 427, 431, 454,
    480, 428, 406, 443, 419, 485, 499, 446, 457, 441, 444, 454, 494, 503, 498,
    491, 459, 505, 467, 531, 502, 519, 482, 495, 484, 529, 568, 556, 586, 530,
])
revenue = np.array([
    0, 0, 0, 0, 0, 48, 19, 77, 0, 58, 0, 105, 163, 145, 96,
    192, 212, 115, 172, 57, 258, 240, 221, 231, 212, 306, 174, 210, 297, 375,
    212, 307, 347, 182, 86, 424, 259, 193, 337, 365, 222, 298, 326, 395, 153,
    308, 268, 405, 509, 289, 403, 441, 481, 327, 346, 487, 394, 632, 471, 626,
    375, 480, 394, 345, 597, 500, 460, 499, 452, 770, 327, 510, 470, 518, 336,
    491, 460, 567, 316, 558, 442, 691, 771, 548, 529, 660, 519, 604, 646, 607,
])
n = len(dau)
day = np.arange(1, n + 1)                      # номер дня: 1 — это 1 июня

def r2(*factors):                              # R² и скорректированный R² для любого числа факторов
    X = np.column_stack([np.ones(n), *factors])            # столбец единиц — свободный член
    beta, *_ = np.linalg.lstsq(X, revenue, rcond=None)     # метод наименьших квадратов
    ss_res = ((revenue - X @ beta) ** 2).sum()
    ss_tot = ((revenue - revenue.mean()) ** 2).sum()
    value = 1 - ss_res / ss_tot
    p = X.shape[1] - 1                                     # факторов без свободного члена
    adjusted = 1 - (1 - value) * (n - 1) / (n - p - 1) if n - p - 1 > 0 else np.nan
    return float(value), float(adjusted)

def show(pair):
    return tuple(round(v, 3) for v in pair)

print(show(r2(dau)), show(r2(dau, day)))       # (0.773, 0.771) (0.788, 0.783)

noise = np.random.default_rng(2026).normal(size=(n, 88))   # 88 столбцов случайных чисел
for k in (1, 5, 10, 20, 40, 60, 88):
    print(k, *show(r2(dau, noise[:, :k])))
# 1 0.774 0.769
# 5 0.776 0.76
# 10 0.805 0.777
# 20 0.822 0.767
# 40 0.887 0.79
# 60 0.934 0.791
# 88 1.0 nan

# 1 000 повторов: DAU и десять новых столбцов шума
base = r2(dau)
runs = np.array([r2(dau, np.random.default_rng(seed).normal(size=(n, 10))) for seed in range(1000)])
print(round(runs[:, 0].min(), 3), round(np.median(runs[:, 0]), 3), round(runs[:, 0].max(), 3))
# 0.777 0.798 0.845
print((runs[:, 0] > base[0]).all(), round((runs[:, 1] > base[1]).mean(), 2))   # True 0.46
Когда R² бывает отрицательным
Пока прямую со свободным членом оценивают на тех же данных, по которым она подобрана, R² лежит между 0 и 1: горизонталь на уровне среднего — тоже прямая, и хуже неё метод наименьших квадратов не выберет. Минус появляется, когда одно из условий нарушено.
Первый случай — новые данные. Построим линию по июню и оценим её на августе. Сумма квадратов её промахов — 808 тысяч, а разброс августовской выручки вокруг своего среднего — 398 тысяч. R² = 1 − 808 / 398 = −1,03. Линия ошибается сильнее, чем константа на уровне августовского среднего: она завышает выручку в среднем на 123 доллара в день, на 24%, и одно это смещение даёт 54% суммы квадратов.
Августовского среднего в июне никто не знал, но вывод от этого не меняется: июньскую линию с её R² = 0,735 переносить на август нельзя.
Заодно видно, чем опасен R² «как квадрат корреляции». regr_r2(revenue, forecast) для тех же 29 дней возвращает 0,12 — ровно R² собственной августовской линии из таблицы выше. Прогноз — это a + b·DAU, а корреляция не меняется ни от сдвига, ни от растяжения: любая прямая с положительным наклоном даст те же 0,12, какими бы ни были её коэффициенты. Способы, которые возводят r в квадрат, — regr_r2, rvalue ** 2, КВПИРСОН — минуса дать не могут. Прогноз на новых данных оценивают только формулой через суммы квадратов.
Второй случай — прямая без свободного члена, y = b·x: её заставляют пройти через ноль. На пяти точках из первого раздела R² падает с 0,64 до 0,03, а если прибавить к каждому y по 20, уходит в минус: 1 − 2 284 / 1 000 = −1,28. Расчёт — в следующем разделе.
Третий случай — скорректированный R²: он отрицателен, когда R² меньше p / (n − 1), то есть модель описывает меньше, чем в среднем описал бы шум.
WITH daily AS (
  SELECT d.day, d.dau, COALESCE(r.revenue, 0) AS revenue
  FROM (SELECT CAST(event_time AS date) AS day, count(DISTINCT user_id) AS dau
        FROM events GROUP BY 1) AS d
  LEFT JOIN (SELECT paid_at AS day, sum(amount) AS revenue
             FROM payments GROUP BY 1) AS r ON r.day = d.day
  WHERE d.day < DATE '2026-08-30'
),
june AS (
  SELECT regr_slope(revenue, dau) AS b, regr_intercept(revenue, dau) AS a
  FROM daily
  WHERE day < DATE '2026-07-01'
),
august AS (
  SELECT revenue, a + b * dau AS forecast, avg(revenue) OVER () AS mean_revenue
  FROM daily CROSS JOIN june
  WHERE day >= DATE '2026-08-01'
)
SELECT
  count(*) AS days,
  round(CAST(sum((revenue - forecast) * (revenue - forecast)) AS numeric)) AS ss_res,
  round(CAST(sum((revenue - mean_revenue) * (revenue - mean_revenue)) AS numeric)) AS ss_tot,
  round(CAST(1 - sum((revenue - forecast) * (revenue - forecast))
    / sum((revenue - mean_revenue) * (revenue - mean_revenue)) AS numeric), 2) AS r2,
  round(CAST(regr_r2(revenue, forecast) AS numeric), 2) AS regr_r2_same_days,
  round(CAST(avg(forecast) AS numeric), 1) AS mean_forecast,
  round(CAST(avg(revenue) AS numeric), 1) AS mean_fact
FROM august;
Как посчитать R² в Python и Excel
В Python для прямой с одним x достаточно возвести в квадрат коэффициент корреляции: np.corrcoef(x, y)[0, 1] ** 2 или scipy.stats.linregress(x, y).rvalue ** 2. Порядок аргументов обратный SQL: сначала x. Для нескольких факторов R² считают по определению: коэффициенты — через numpy.linalg.lstsq, затем остатки и две суммы квадратов, как в блоке о столбцах шума.
В Excel квадрат корреляции возвращает КВПИРСОН(известные_значения_y; известные_значения_x): на пяти точках — 0,64. То же число показывает линия тренда на точечной диаграмме, если в её параметрах отметить «поместить на диаграмму величину достоверности аппроксимации (R^2)». ЛИНЕЙН с аргументом статистика = ИСТИНА возвращает R² в третьей строке, первом столбце массива: =ИНДЕКС(ЛИНЕЙН(y; x; ИСТИНА; ИСТИНА); 3; 1).
Теперь прямая без свободного члена. На пяти точках её наклон — 1,509, сумма квадратов остатков — 974,5, и R² = 1 − 974,5 / 1 000 = 0,03 вместо 0,64. На 90 днях учебной базы потеря мала: 0,761 против 0,773.
Здесь нужна осторожность, и не только с Excel. По справке Microsoft, ЛИНЕЙН с аргументом конст = ЛОЖЬ считает общую сумму квадратов от нуля, без вычитания среднего; так же считают линия тренда с пересечением в нуле и R (lm без свободного члена). По этой формуле те же пять точек дают 1 − 974,5 / 13 500 = 0,93 — больше, чем у линии со свободным членом, хотя модель хуже.
import numpy as np
from scipy import stats

x = np.array([10, 20, 30, 40, 50])      # бюджет, тысяч рублей
y = np.array([30, 50, 40, 70, 60])      # регистрации

fit = stats.linregress(x, y)            # сначала x, потом y
ss_res = ((y - (fit.intercept + fit.slope * x)) ** 2).sum()
ss_tot = ((y - y.mean()) ** 2).sum()
r2 = 1 - ss_res / ss_tot
print(round(ss_res, 1), round(ss_tot, 1), round(r2, 2))                    # 360.0 1000.0 0.64
print(round(fit.rvalue ** 2, 2), round(np.corrcoef(x, y)[0, 1] ** 2, 2))   # 0.64 0.64

n, p = len(x), 1                        # скорректированный R²
print(round(1 - (1 - r2) * (n - 1) / (n - p - 1), 2))                      # 0.52

b0 = (x * y).sum() / (x ** 2).sum()     # прямая без свободного члена: y = b0·x
ss_res0 = ((y - b0 * x) ** 2).sum()
print(round(b0, 3), round(ss_res0, 1))                                     # 1.509 974.5
print(round(1 - ss_res0 / ss_tot, 2))                # 0.03 — разброс от среднего
print(round(1 - ss_res0 / (y ** 2).sum(), 2))        # 0.93 — «от нуля», как ЛИНЕЙН при конст = ЛОЖЬ

y20 = y + 20                            # те же точки, поднятые на 20: прямая через ноль хуже среднего
b20 = (x * y20).sum() / (x ** 2).sum()
print(round(1 - ((y20 - b20 * x) ** 2).sum() / ss_tot, 2))                 # -1.28
Какой R² считается хорошим
Общего порога нет, и шкала Чеддока его не даёт. Один сервис, одна база: связь числа заходов с суммой оплат по отдельным пользователям — R² = 0,039, выручка по DAU по дням — 0,773. Это разные пары величин на разных уровнях: поведение одного человека шумнее суммы по дню, а дневной ряд вдобавок растёт весь квартал, и R² измеряет этот общий рост. Первое число не делает анализ плохим, второе — хорошим.
Полезнее четыре вопроса.
- С чем сравниваем? У модели с DAU R² 0,773 — меньше, чем 0,785 у одного номера дня.
- Что в остатках? Дуга, веер (разброс растёт вместе с x) или выброс важнее третьего знака R².
- Какая ошибка в единицах? Стандартное отклонение остатков — 94 доллара при средней выручке 332: в плюс-минус 94 укладываются 67 дней из 90. К концу квартала промахи крупнее — около 110 долларов в августе против 60 в июне, — так что для плана на осень лучше брать августовскую цифру.
- Что на новых данных? У июньской линии R² 0,735 на июне и −1,03 на августе.
Частые вопросы
Чем R² отличается от коэффициента корреляции? Корреляция r — число от −1 до 1 со знаком, мера линейной связи двух величин. R² относится к модели, в которой может быть несколько факторов; на данных, по которым модель подобрана, он лежит от 0 до 1, на новых может уйти в минус. Для прямой с одним x это квадрат r: 0,879² = 0,773.
Что такое множественный коэффициент детерминации? R² модели с несколькими факторами; формула та же. Корень из него — множественный коэффициент корреляции R: корреляция между фактом и значениями модели на данных, по которым она подобрана. Для выручки по DAU и номеру дня R² = 0,788, R = 0,888.
R² равен нулю — связи нет? Нет той связи, которую умеет описать модель. Для y = x² на точках от −3 до 3 прямая даёт R² = 0, хотя y полностью определяется x.
Как R² связан с p-value? Они отвечают на разные вопросы: p-value — можно ли отличить связь от нуля, R² — какую долю разброса она описывает. По 4 613 пользователям учебной базы R² = 0,039 при p-value порядка 10⁻⁴¹: связь почти наверняка есть и почти ничего не описывает.
Что читать дальше
Проверьте себя. Замените в пяти точках последнее значение 60 на 160 и пересчитайте R² первым запросом статьи: он вырастет с 0,64 до 0,71. Одна испорченная точка сделала модель «лучше».
Все запросы выполняются в песочнице симулятора SQL-аналитика: она работает на этой же учебной базе.
Материалы по теме
Линейная регрессия простыми словами: уравнение, наклон и R²
Что такое регрессия и линейная регрессия: уравнение y = a + b·x, наклон, свободный член и R². Пример на пяти точках, расчёт в SQL, Python и Excel, остатки, прогноз и ловушки.
Метод наименьших квадратов (МНК): суть, формулы и пример расчёта
Метод наименьших квадратов простыми словами: что минимизирует МНК, формулы наклона и свободного члена, нормальные уравнения, пример на пяти точках, SQL, Python и Excel.
Математическое ожидание: что это, формула и примеры
Математическое ожидание простыми словами: среднее, к которому результат сходится в долгую. Формула, пример на кубике, расчёт в SQL и Python, свойства и ловушки.