Ковариация: что это, формула и отличие от корреляции
Ковариация — среднее произведение отклонений двух величин от их средних. Формула, пример на пяти парах, расчёт в SQL, Python и Excel, ковариационная матрица и ловушки.
Содержание статьи
Ковариация — это среднее произведение отклонений двух величин от их средних: cov(X, Y) = Σ(x − x̄)(y − ȳ) / (n − 1) для выборки и та же сумма, делённая на n, для генеральной совокупности. Знак показывает, в одну ли сторону величины отклоняются от своих средних; величина зависит от единиц измерения, и по ней одной не скажешь, сильная связь или слабая. Пример: в учебной базе ковариация дневной выручки и DAU, числа активных пользователей за день, равна 25 571. Запишите выручку в центах — станет 2 557 120, хотя связь та же. В отчётах ковариацию показывают редко, но на ней стоят корреляция, наклон регрессии и дисперсия суммы. Ниже — расчёт руками, в SQL, Python и Excel и места, где число обманывает.
Что такое ковариация простыми словами
Возьмите две величины, измеренные у одних и тех же объектов: у пользователя — дни с заходами и созданные отчёты, у дня — аудиторию и выручку. Для каждого объекта посчитайте, насколько первая величина выше или ниже своего среднего и насколько вторая — своего. Перемножьте два отклонения.
Если обе величины выше среднего или обе ниже, произведение положительное. Если одна выше, а другая ниже — отрицательное. Ковариация усредняет эти произведения. Положительная означает, что произведения с плюсом в сумме перевешивают: величины отклоняются в одну сторону чаще или сильнее. Отрицательная — что перевешивают произведения с минусом. Близкая к нулю рядом с произведением стандартных отклонений — что линейной связи не видно.
Делитель зависит от того, что перед вами. Если данные — выборка, по которой судят о большей совокупности, сумму делят на n − 1: это выборочная ковариация. Если данные и есть вся совокупность — на n: это генеральная. Причина та же, что у дисперсии: средние посчитаны по тем же данным, и деление на n давало бы смещённую оценку.
cov(X, Y) = Σ(x − x̄)(y − ȳ) / (n − 1); cov_ген(X, Y) = Σ(x − x̄)(y − ȳ) / nx̄ и ȳ — средние, n — число пар. Генеральную ковариацию записывают и как E[XY] − E[X]·E[Y]: среднее произведения минус произведение средних. В статье о математическом ожидании так посчитана пара «цена тарифа и число оплат»: 6,6419 − 1,3126 = 5,3293.
Как посчитать ковариацию: пример на пяти парах
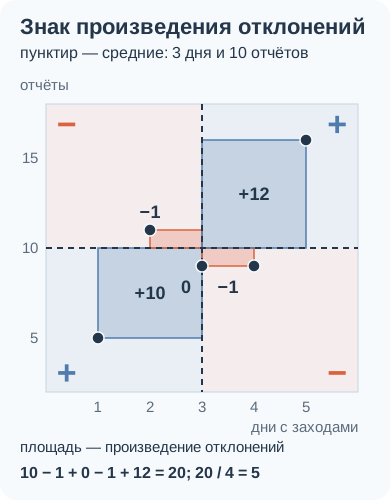
Пять пользователей сервиса отчётов. Дней с заходами за неделю — 1, 2, 3, 4 и 5, созданных отчётов — 5, 11, 9, 9 и 16. Среднее число дней — 3, среднее число отчётов — 10.
Первый пользователь заходил на 2 дня меньше среднего и сделал на 5 отчётов меньше: произведение (−2) · (−5) = 10. Второй заходил на день меньше, а отчётов сделал на один больше: (−1) · 1 = −1. Так для каждой пары; сумма произведений — 20.
Выборочная ковариация равна 20 / 4 = 5, генеральная — 20 / 5 = 4. Единица измерения — «дни × отчёты», и само число 5 ничего не сообщает, пока его не с чем сравнить.
На схеме каждое произведение — площадь прямоугольника между точкой и точкой средних. Справа вверху и слева внизу площади идут в плюс, в двух других квадрантах — в минус. Ковариация положительна, когда плюсовые площади перевешивают.
| Дни x | Отчёты y | x − x̄ | y − ȳ | Произведение |
|---|---|---|---|---|
| 1 | 5 | −2 | −5 | 10 |
| 2 | 11 | −1 | 1 | −1 |
| 3 | 9 | 0 | −1 | 0 |
| 4 | 9 | 1 | −1 | −1 |
| 5 | 16 | 2 | 6 | 12 |
| среднее 3 | среднее 10 | сумма 0 | сумма 0 | сумма 20 |
Как читать ковариацию: знак и единицы измерения
Теперь рабочие данные. В учебной базе лежат события пользователей сервиса и оплаты в долларах. Строка расчёта — день: DAU, то есть число людей хотя бы с одним событием, и выручка — сумма оплат. Окно — 90 дней с 1 июня по 29 августа 2026 года. За 30 августа события записаны только до 12:59, поэтому этот день в расчёт не идёт.
Ковариация выручки и DAU — 25 571,2. Знак положительный: дни, когда аудитория и выручка стоят по одну сторону от своих средних, в сумме перевешивают.
Величина зависит от единиц. Запишем выручку в центах — ковариация станет 2 557 120,2, в 100 раз больше, а корреляция останется 0,879. Общее правило: cov(a·X, c·Y) = a·c·cov(X, Y), прибавление константы ковариацию не меняет. Поэтому «25 тысяч» нельзя назвать ни сильной, ни слабой связью, и ковариации разных пар величин между собой не сравнивают.
WITH daily AS (
  SELECT d.day, d.dau, COALESCE(r.revenue, 0) AS revenue
  FROM (SELECT CAST(event_time AS date) AS day, count(DISTINCT user_id) AS dau
        FROM events GROUP BY 1) AS d
  LEFT JOIN (SELECT paid_at AS day, sum(amount) AS revenue
             FROM payments GROUP BY 1) AS r ON r.day = d.day
)
SELECT
  count(*) AS days,
  round(CAST(covar_samp(revenue, dau) AS numeric), 1) AS cov_dollars,
  round(CAST(covar_samp(100 * revenue, dau) AS numeric), 1) AS cov_cents,
  round(CAST(corr(revenue, dau) AS numeric), 3) AS r_dollars,
  round(CAST(corr(100 * revenue, dau) AS numeric), 3) AS r_cents
FROM daily
WHERE day < DATE '2026-08-30';
Как ковариация связана с дисперсией, корреляцией и наклоном регрессии
Ковариация величины с самой собой — её дисперсия: произведение отклонений превращается в квадрат отклонения. Для DAU covar_samp(dau, dau) и var_samp(dau) возвращают одно число, 21 844,6.
Корреляция Пирсона — это ковариация, делённая на произведение стандартных отклонений. Деление убирает единицы и ставит результат в диапазон от −1 до 1: по модулю ковариация не бывает больше s_x · s_y. Для нашей пары предел — 147,80 · 196,77 ≈ 29 083, и 25 571,2 составляет от него 0,879. Тот же r получен в статье о линейной регрессии.
Наклон регрессии выручки по DAU — ковариация, делённая на дисперсию той величины, по которой строят прогноз, здесь DAU: 25 571,2 / 21 844,6 = 1,171 доллара на одного активного пользователя. Поделите на дисперсию выручки — получится другой наклон, DAU по выручке: 0,660. Знаки ковариации, корреляции и наклона всегда совпадают, различаются единицы: у ковариации — «доллары × пользователи», у наклона — доллары на пользователя, у корреляции единиц нет.
cov(X, X) = var(X); r = cov(X, Y) / (s_x · s_y); b = cov(X, Y) / var(X)На пяти парах из примера: s_x = 1,58, s_y = 4, r = 5 / (1,58 · 4) = 0,79; наклон b = 5 / 2,5 = 2 отчёта на день с заходом. Ковариацию и стандартные отклонения берут с одним делителем — обе выборочные или обе генеральные; r и b тогда от выбора не зависят.
WITH daily AS (
  SELECT d.day, d.dau, COALESCE(r.revenue, 0) AS revenue
  FROM (SELECT CAST(event_time AS date) AS day, count(DISTINCT user_id) AS dau
        FROM events GROUP BY 1) AS d
  LEFT JOIN (SELECT paid_at AS day, sum(amount) AS revenue
             FROM payments GROUP BY 1) AS r ON r.day = d.day
)
SELECT
  round(CAST(covar_samp(revenue, dau) AS numeric), 1) AS cov_xy,
  round(CAST(covar_samp(dau, dau) AS numeric), 1) AS cov_xx,
  round(CAST(var_samp(dau) AS numeric), 1) AS var_x,
  round(CAST(stddev_samp(dau) AS numeric), 2) AS sd_x,
  round(CAST(stddev_samp(revenue) AS numeric), 2) AS sd_y,
  round(CAST(covar_samp(revenue, dau)
    / (stddev_samp(dau) * stddev_samp(revenue)) AS numeric), 3) AS r,
  round(CAST(covar_samp(revenue, dau) / var_samp(dau) AS numeric), 3) AS slope
FROM daily
WHERE day < DATE '2026-08-30';
Как посчитать ковариацию в SQL
В PostgreSQL и DuckDB есть две агрегатные функции: covar_samp(y, x) делит на n − 1, covar_pop(y, x) — на n. Порядок аргументов на результат не влияет: ковариация симметрична. На 90 днях генеральная меньше выборочной на 1,1% (25 287,1 против 25 571,2), на пяти парах из примера — на 20%.
Обе функции берут только пары, где оба значения не NULL, и это легко упустить. В семи днях из 90 оплат не было. Если присоединить оплаты через LEFT JOIN и забыть COALESCE, выручка этих дней окажется NULL вместо нуля. Запрос выполнится, но по 83 парам, и вернёт 20 265,8 — на 21% меньше. Сколько пар попало в расчёт, показывает regr_count.
Ещё две детали. Функции возвращают число с плавающей точкой, а round с двумя аргументами в PostgreSQL принимает только numeric — отсюда CAST. На одной-единственной паре covar_samp вернёт NULL, covar_pop — ноль; так ведут себя оба движка.
WITH daily AS (
  SELECT d.day, d.dau, r.revenue AS revenue_null, COALESCE(r.revenue, 0) AS revenue
  FROM (SELECT CAST(event_time AS date) AS day, count(DISTINCT user_id) AS dau
        FROM events GROUP BY 1) AS d
  LEFT JOIN (SELECT paid_at AS day, sum(amount) AS revenue
             FROM payments GROUP BY 1) AS r ON r.day = d.day
)
SELECT
  regr_count(revenue, dau) AS pairs,
  round(CAST(covar_samp(revenue, dau) AS numeric), 1) AS cov_samp,
  round(CAST(covar_pop(revenue, dau) AS numeric), 1) AS cov_pop,
  regr_count(revenue_null, dau) AS pairs_without_coalesce,
  round(CAST(covar_samp(revenue_null, dau) AS numeric), 1) AS cov_without_coalesce
FROM daily
WHERE day < DATE '2026-08-30';
Как посчитать ковариацию в Python и Excel
В numpy функция np.cov(x, y) возвращает матрицу 2 × 2, а не одно число: на диагонали дисперсии, в двух других ячейках — ковариация. Нужный элемент — [0, 1]. По умолчанию делитель n − 1; генеральную ковариацию даёт ddof=0.
Здесь легко ошибиться дважды. Первое: np.var и np.std по умолчанию делят на n, а np.cov — на n − 1, поэтому для дней из примера np.cov(x, x)[0, 1] равно 2,5, а np.var(x) — 2,0. Если поделить np.cov(x, y)[0, 1] на np.std(x) * np.std(y), на пяти парах выйдет 0,99 вместо 0,79, на 90 днях — 0,889 вместо 0,879. Пишите np.std(x, ddof=1) или берите np.corrcoef. Второе: двумерный массив np.cov читает по строкам, каждая строка считается отдельной величиной. Таблица из пяти строк и двух столбцов превратится в матрицу 5 × 5; нужен rowvar=False.
В pandas Series.cov возвращает одно число, DataFrame.cov() — матрицу с подписями, делитель тоже n − 1. Пары с пропуском pandas отбрасывает без предупреждения: на пяти парах с одним пропуском вместо 5 выйдет 7,08, посчитанное по четырём. В DataFrame.cov() это происходит отдельно для каждой пары столбцов, так что ячейки матрицы могут быть посчитаны по разным строкам. np.cov вернёт nan во всех ячейках, куда попал столбец с пропуском.
В Excel выборочную ковариацию считает КОВАРИАЦИЯ.В(массив1; массив2), генеральную — КОВАРИАЦИЯ.Г. Старая функция КОВАР считает генеральную; по справке Microsoft, она заменена двумя новыми и оставлена для совместимости. На пяти парах должны получиться 5 и 4.
import numpy as np
import pandas as pd

days = np.array([1, 2, 3, 4, 5])         # дней с заходами за неделю
reports = np.array([5, 11, 9, 9, 16])    # созданных отчётов

print(np.cov(days, reports))                      # [[ 2.5  5. ] [ 5.  16. ]]
print(np.cov(days, reports)[0, 1])                # 5.0 — делитель n − 1
print(np.cov(days, reports, ddof=0)[0, 1])        # 4.0 — делитель n
print(np.cov(days, days)[0, 1], np.var(days))     # 2.5 2.0

df = pd.DataFrame({'days': days, 'reports': reports})
print(df['days'].cov(df['reports']))              # 5.0
print(df.cov().loc['days', 'reports'])            # 5.0
print(np.cov(df.to_numpy()).shape)                # (5, 5) — строки приняты за величины
print(np.cov(df.to_numpy(), rowvar=False)[0, 1])  # 5.0
Что такое ковариационная матрица и как её читать
Когда величин больше двух, ковариации всех пар складывают в таблицу — ковариационную матрицу. Строки и столбцы в ней — одни и те же величины. На диагонали стоят дисперсии, вне диагонали — ковариации пар. Матрица симметрична, потому что cov(X, Y) = cov(Y, X).
Соберём её по пользователям учебной базы. Строка — один из 4 613 зарегистрированных, величины — число событий, сумма первой оплаты и сумма продлений в долларах; у не плативших обе суммы равны нулю. Готовой функции для матрицы в SQL нет, её собирают из var_samp и covar_samp. В pandas хватает df.cov().
Диагональ читается как разброс: 12,60 — дисперсия числа событий (стандартное отклонение 3,55), 104,41 и 58,80 — дисперсии первой оплаты и продлений. Все ковариации положительные, но о причинах это ничего не говорит. Большую часть связи событий с оплатами создаёт возраст когорты: ранние регистрации успели накопить больше и событий, и оплат, а у 1 895 августовских пользователей продлений ещё не могло быть. Среди людей с одной датой регистрации ковариация событий с первой оплатой падает с 5,77 до 2,0, с продлениями — с 5,11 до 0,9. Продления к тому же бывают только после первой оплаты.
Сравнивать недиагональные числа между собой нельзя. Ковариация первой оплаты с продлениями, 39,01, в 7,6 раза больше ковариации событий с продлениями, 5,11, а корреляции — меньше чем в три раза: 0,498 и 0,188. Порядок пар тоже может не совпасть: у событий ковариация с первой оплатой чуть больше, чем с продлениями (5,77 против 5,11), а корреляция чуть меньше (0,159 против 0,188), потому что разброс первой оплаты больше — 10,22 доллара против 7,67. Обе разницы малы и на другой выборке могут не повториться: пример показывает арифметику, а не то, что продления связаны с активностью теснее. Чтобы сопоставить пары, матрицу переводят в корреляционную — каждый элемент делят на два стандартных отклонения.
| События | Первая оплата | Продления | |
|---|---|---|---|
| События | 12,60 | 5,77 | 5,11 |
| Первая оплата | 5,77 | 104,41 | 39,01 |
| Продления | 5,11 | 39,01 | 58,80 |
WITH per_user AS (
  SELECT
    u.user_id,
    e.events,
    COALESCE(sum(CASE WHEN p.payment_type = 'first' THEN p.amount END), 0) AS first_amount,
    COALESCE(sum(CASE WHEN p.payment_type = 'renewal' THEN p.amount END), 0) AS renewals
  FROM users AS u
  JOIN (SELECT user_id, count(*) AS events
        FROM events GROUP BY user_id) AS e ON e.user_id = u.user_id
  LEFT JOIN payments AS p ON p.user_id = u.user_id
  GROUP BY u.user_id, e.events
)
SELECT 1 AS row_no, 'события' AS variable,
  round(CAST(var_samp(events) AS numeric), 2) AS events,
  round(CAST(covar_samp(events, first_amount) AS numeric), 2) AS first_amount,
  round(CAST(covar_samp(events, renewals) AS numeric), 2) AS renewals
FROM per_user
UNION ALL
SELECT 2, 'первая оплата',
  round(CAST(covar_samp(first_amount, events) AS numeric), 2),
  round(CAST(var_samp(first_amount) AS numeric), 2),
  round(CAST(covar_samp(first_amount, renewals) AS numeric), 2)
FROM per_user
UNION ALL
SELECT 3, 'продления',
  round(CAST(covar_samp(renewals, events) AS numeric), 2),
  round(CAST(covar_samp(renewals, first_amount) AS numeric), 2),
  round(CAST(var_samp(renewals) AS numeric), 2)
FROM per_user
ORDER BY row_no;
Зачем аналитику ковариация: дисперсия суммы и разности
Среднее суммы всегда равно сумме средних. С разбросом так не выходит: дисперсия суммы — это сумма дисперсий плюс удвоенная ковариация. Когда величины растут вместе, сумма колеблется сильнее, чем подсказывают её части по отдельности.
Выручка с пользователя — первая оплата плюс продления. По матрице: 104,41 + 58,80 + 2 · 39,01 = 241,23, стандартное отклонение 15,53 доллара. Если сложить дисперсии, как для независимых величин, выйдет 163,21 и отклонение 12,78 — на 18% меньше. На столько же сузится доверительный интервал средней выручки на пользователя: он выйдет уже, чем позволяют данные.
Для разности знак меняется: ковариация вычитается. В A/B-тесте группы независимы, ковариация их средних равна нулю, и дисперсия разности средних — сумма двух дисперсий. Ковариацию можно обратить в пользу: метод CUPED вычитает из метрики поправку θ · (X − X̄) по данным до эксперимента, где θ = cov(X, Y) / var(X) — та же формула, что у наклона, — и разброс метрики уменьшается. Знак ковариации не важен: θ меняет его вместе с ней, а выигрыш зависит от квадрата корреляции.
В финансах та же формула описывает диверсификацию: чем меньше ковариация доходностей двух активов, тем меньше дисперсия портфеля, а при отрицательной она ниже суммы дисперсий его частей.
Var(X + Y) = Var(X) + Var(Y) + 2·cov(X, Y); Var(X − Y) = Var(X) + Var(Y) − 2·cov(X, Y)При нулевой ковариации остаётся сумма дисперсий. Равенство для суммы — тождество: дисперсия столбца «первая оплата + продления», посчитанная напрямую, равна тем же 241,23.
import numpy as np

# события, первая оплата, продления — результат SQL-запроса выше
S = np.array([[12.60, 5.77, 5.11],
              [5.77, 104.41, 39.01],
              [5.11, 39.01, 58.80]])

sd = np.sqrt(np.diag(S))
print(sd.round(2))                         # [ 3.55 10.22  7.67]
print((S / np.outer(sd, sd)).round(3))     # корреляции: 0.159, 0.188, 0.498

var_sum = S[1:, 1:].sum()                  # четыре ячейки блока «оплата и продления»
var_naive = S[1, 1] + S[2, 2]              # как если бы ковариации не было
print(round(var_sum, 2), round(var_naive, 2))                      # 241.23 163.21
print(round(np.sqrt(var_sum), 2), round(np.sqrt(var_naive), 2))    # 15.53 12.78
Значит ли нулевая ковариация, что величины независимы
Нет. У независимых величин ковариация равна нулю, в выборке — близка к нулю. Обратное неверно: ковариация замечает только линейную связь.
Возьмём x от −3 до 3 и y = x². Зависимость полная: зная x, y вычисляют без ошибки. Но слева от нуля y убывает, справа растёт, и произведения отклонений гасят друг друга: −15, 0, 3, 0, −3, 0, 15. Ковариация и корреляция равны нулю.
Такая зависимость возможна везде, где у величины есть оптимум посередине: слишком редкие и слишком частые рассылки могут удерживать одинаково плохо. Ноль в этом случае означает «нет прямой», и диаграмму рассеяния он не заменяет.
import numpy as np

x = np.arange(-3, 4)             # -3, -2, -1, 0, 1, 2, 3
y = x ** 2                       #  9,  4,  1, 0, 1, 4, 9

products = (x - x.mean()) * (y - y.mean())
print(products.astype(int).tolist())     # [-15, 0, 3, 0, -3, 0, 15]
print(float(np.cov(x, y)[0, 1]))         # 0.0
print(round(float(np.corrcoef(x, y)[0, 1]), 3))   # 0.0
Как общий тренд и один неполный день меняют ковариацию
DAU и выручка росли весь квартал: аудитория — с 32 до 530–590 человек в день. У двух растущих рядов ранние дни лежат ниже обоих средних, поздние — выше, и произведения отклонений выходят положительными, даже если между собой ряды не связаны. Здесь положительны 79 произведений из 90.
Проверка — вычесть из каждого ряда его линейный тренд по номеру дня и посчитать ковариацию остатков. От 25 571,2 остаётся 298,8, то есть 1,2%; остальные 98,8% приходятся на произведение двух трендов. Сама доля мало что доказывает: тренд даёт 96% дисперсии DAU и 79% дисперсии выручки, и даже при идеальной связи остатков на них пришлось бы около 10% ковариации. Судить надо по корреляции и наклону остатков. Положительных произведений теперь 51 из 90, корреляция падает с 0,879 до 0,113, наклон — с 1,171 до 0,357, и его 95%-й интервал, от −0,31 до 1,02, включает ноль (интервал посчитан в статье о регрессии). Отличить собственную связь DAU с выручкой от нулевой на этих данных нельзя; исключить её тоже нельзя: интервал доходит до доллара на пользователя.
Вторая ловушка — одна далёкая точка. За 30 августа DAU посчитан по половине дня (223), а выручка — по целому (721). С этой строкой ковариация за квартал снижается на 2,9%, до 24 836,6. На коротком окне она решает всё: по 29 закрытым дням августа ковариация равна 1 828,2, с тридцатым днём — −7,1. Знак сменился из-за одной строки, так что перед расчётом проверяйте, закрыт ли последний период.
WITH daily AS (
  SELECT d.day - DATE '2026-06-01' + 1 AS day_no, d.dau, COALESCE(r.revenue, 0) AS revenue
  FROM (SELECT CAST(event_time AS date) AS day, count(DISTINCT user_id) AS dau
        FROM events GROUP BY 1) AS d
  LEFT JOIN (SELECT paid_at AS day, sum(amount) AS revenue
             FROM payments GROUP BY 1) AS r ON r.day = d.day
  WHERE d.day < DATE '2026-08-30'
),
trend AS (
  SELECT
    regr_slope(revenue, day_no) AS rev_b, regr_intercept(revenue, day_no) AS rev_a,
    regr_slope(dau, day_no) AS dau_b, regr_intercept(dau, day_no) AS dau_a
  FROM daily
),
detrended AS (
  SELECT
    dau, revenue,
    revenue - (rev_a + rev_b * day_no) AS revenue_res,
    dau - (dau_a + dau_b * day_no) AS dau_res
  FROM daily CROSS JOIN trend
)
SELECT
  round(CAST(covar_samp(revenue, dau) AS numeric), 1) AS cov_raw,
  round(CAST(covar_samp(revenue_res, dau_res) AS numeric), 1) AS cov_without_trend,
  round(CAST(100 * covar_samp(revenue_res, dau_res)
    / covar_samp(revenue, dau) AS numeric), 1) AS share_pct,
  round(CAST(corr(revenue_res, dau_res) AS numeric), 3) AS r_without_trend,
  round(CAST(covar_samp(revenue_res, dau_res) / var_samp(dau_res) AS numeric), 3) AS slope_without_trend
FROM detrended;WITH daily AS (
SELECT d.day, d.dau, COALESCE(r.revenue, 0) AS revenue
FROM (SELECT CAST(event_time AS date) AS day, count(DISTINCT user_id) AS dau
FROM events GROUP BY 1) AS d
LEFT JOIN (SELECT paid_at AS day, sum(amount) AS revenue
FROM payments GROUP BY 1) AS r ON r.day = d.day
)
SELECT
round(CAST(covar_samp(revenue, dau) FILTER (
WHERE day < DATE '2026-08-30') AS numeric), 1) AS cov_90,
round(CAST(covar_samp(revenue, dau) AS numeric), 1) AS cov_91,
round(CAST(covar_samp(revenue, dau) FILTER (
WHERE day >= DATE '2026-08-01' AND day < DATE '2026-08-30') AS numeric), 1) AS august_29,
round(CAST(covar_samp(revenue, dau) FILTER (
WHERE day >= DATE '2026-08-01') AS numeric), 1) AS august_30
FROM daily;Частые вопросы
Чем ковариация отличается от корреляции? Корреляция — это ковариация, приведённая к шкале от −1 до 1 делением на стандартные отклонения. Ковариация зависит от единиц измерения и работает внутри формул; корреляцию сообщают, когда хотят сказать, насколько тесно точки лежат вокруг прямой.
Может ли ковариация быть отрицательной или больше единицы? Да. Отрицательная означает, что в сумме перевешивают пары, где величины отклонились от средних в разные стороны. Границ вроде ±1 у неё нет: по модулю она ограничена только произведением стандартных отклонений, для DAU и выручки это 29 083.
В чём измеряется ковариация? В произведении единиц двух величин: «доллары × пользователи», «дни × отчёты». Поэтому перед показом её пересчитывают в корреляцию или наклон.
Чему равна ковариация независимых величин? Теоретическая — нулю. Выборочная ровно нулём почти не выходит: случайные совпадения дают небольшое число любого знака. В обратную сторону правило не работает — пример с y = x² выше.
Что выбрать: covar_samp или covar_pop? Для выборки — covar_samp; тот же делитель n − 1 стоит по умолчанию в np.cov и pandas. covar_pop подходит, когда данные — вся совокупность, о которой идёт речь. С ростом n разница уменьшается: на 90 днях это 1,1%.
Что читать дальше
Ковариация — промежуточное число: из неё получают корреляцию, наклон регрессии и дисперсию суммы. Все запросы выполняются в песочнице симулятора SQL-аналитика на этой же учебной базе.
Материалы по теме
Математическое ожидание: что это, формула и примеры
Математическое ожидание простыми словами: среднее, к которому результат сходится в долгую. Формула, пример на кубике, расчёт в SQL и Python, свойства и ловушки.
Коэффициент вариации: формула, расчёт и как читать
Коэффициент вариации — стандартное отклонение в процентах от среднего. Формула, пример на пяти числах, расчёт в SQL, Python и Excel, порог 33% для НМЦК и ловушки.
Линейная регрессия простыми словами: уравнение, наклон и R²
Что такое регрессия и линейная регрессия: уравнение y = a + b·x, наклон, свободный член и R². Пример на пяти точках, расчёт в SQL, Python и Excel, остатки, прогноз и ловушки.