Равномерное распределение: формула, свойства и примеры
Равномерное распределение: плотность, функция распределения, математическое ожидание и дисперсия. Генераторы в SQL, Python и Excel, проверка данных на равномерность и ловушки.
Содержание статьи
Равномерное распределение на отрезке от a до b — непрерывное распределение, у которого все значения отрезка одинаково возможны: вероятность попасть в любой кусок отрезка пропорциональна длине куска. Плотность f(x) = 1/(b − a), функция распределения F(x) = (x − a)/(b − a), математическое ожидание и медиана — (a + b)/2, дисперсия — (b − a)²/12, стандартное отклонение — (b − a)/√12. Пример: автобус ходит ровно раз в 20 минут, вы выходите на остановку в случайный момент — ждать в среднем 10 минут, дольше 15 минут придётся с вероятностью 25%.
Что такое равномерное распределение простыми словами
У непрерывного равномерного распределения два параметра — концы отрезка a и b. Внутри отрезка плотность постоянна, снаружи равна нулю, поэтому её график — прямоугольник с основанием b − a, высотой 1/(b − a) и площадью 1. Пишут U(a, b).
Вероятность — площадь над нужным куском отрезка: P(c < X < d) = (d − c)/(b − a). Ожидание автобуса равномерно на отрезке от 0 до 20 минут. Ждать дольше 15 минут — (20 − 15)/20 = 25%, от 5 до 12 минут — 7/20 = 35%. Ровно 7 минут — вероятность нулевая: у куска нулевой длины нет площади.
Функция распределения F(x) — вероятность получить значение не больше x. Внутри отрезка она растёт по прямой от 0 до 1: F(15) = 15/20 = 0,75. Среднее и медиана совпадают в середине отрезка — 10 минут, стандартное отклонение — 20/√12 ≈ 5,77 минуты. Моды нет: плотность везде одинакова.
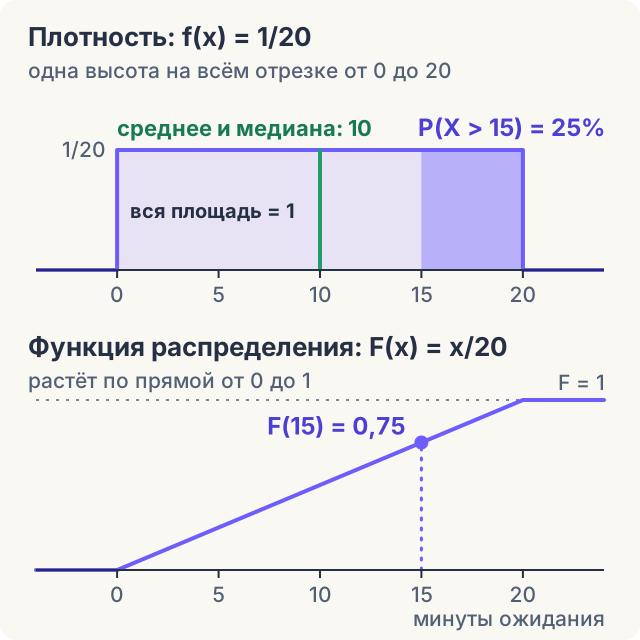
f(x) = 1/(b − a); F(x) = (x − a)/(b − a); E(X) = медиана = (a + b)/2; D(X) = (b − a)²/12; σ = (b − a)/√12a ≤ x ≤ b; вне отрезка плотность равна нулю.
Чем дискретное равномерное распределение отличается от непрерывного
У дискретного равномерного распределения значений конечное число, и вероятности у них равны. Игральный кубик — шесть граней по 1/6. Для n целых значений от 1 до n среднее равно (n + 1)/2, дисперсия — (n² − 1)/12: у кубика это 3,5 и 35/12 ≈ 2,92.
Формулы дисперсии не взаимозаменяемы. В учебной базе продукта «Маяк» первая оплата приходит через 3–20 дней после регистрации: 18 равновероятных значений. У регистраций до 9 августа включительно — у них 20 дней до конца выгрузки заведомо прошли — 756 первых оплат, среднее 11,63 дня, дисперсия 26,89. Дискретная формула даёт (18² − 1)/12 = 26,92. Непрерывная — (20 − 3)²/12 = 24,08, на 10,5% меньше: она берёт длину отрезка, 17, а значений 18.
| Свойство | Непрерывное на [a, b] | Дискретное: целые от a до b |
|---|---|---|
| Значения | любое число отрезка | n = b − a + 1 целых |
| Вероятность | плотность 1/(b − a); у отдельного значения 0 | 1/n у каждого значения |
| Среднее | (a + b)/2 | (a + b)/2 |
| Дисперсия | (b − a)²/12 | (n² − 1)/12 |
| Пример | ожидание автобуса, 0–20 минут: 10 и 33,3 | кубик, 1–6: 3,5 и 2,92 |
Откуда в формуле дисперсии число 12
Дисперсия — средний квадрат отклонения от среднего; считать её удобно как D(X) = E(X²) − (E(X))². На отрезке от 0 до 1 средний квадрат — интеграл x² от 0 до 1, то есть 1/3. Квадрат среднего — (1/2)² = 1/4. Разность 1/3 − 1/4 и есть 1/12.
Любой отрезок получается из единичного растяжением в b − a раз и сдвигом на a. Сдвиг дисперсию не меняет, растяжение умножает её на квадрат множителя — отсюда (b − a)²/12. Для автобуса это 20²/12 ≈ 33,3 минуты в квадрате, корень — те же 5,77 минуты.
D(X) = E(X²) − (E(X))² = ∫₀¹ x² dx − (1/2)² = 1/3 − 1/4 = 1/12Для отрезка [a, b] результат умножается на (b − a)².
Как получить равномерное случайное число в SQL, Python и Excel
Чаще всего аналитик встречает равномерное распределение в генераторе случайных чисел. random() в PostgreSQL и DuckDB возвращает число от 0 до 1: ноль возможен, единица нет. Так же устроены rng.random() в NumPy и СЛЧИС() в Excel. Число на отрезке от a до b — a + (b − a) * random().
Целое от 1 до 6 — FLOOR(random() * 6) + 1. Округлять нельзя. Запрос ниже берёт тысячу равноотстоящих чисел от 0,0005 до 0,9995: ROUND(u * 10) выдаёт 0 и 10 по 50 раз, а значения от 1 до 9 — по 100. Края выпадают вдвое реже, и значений одиннадцать вместо десяти. FLOOR(u * 10) даёт десять значений по 100.
Границы у целочисленных генераторов разные. СЛУЧМЕЖДУ(1; 6) в Excel и random(1, 6) в PostgreSQL 17 включают оба конца. rng.integers(1, 6) в NumPy верхний не включает: это кубик без шестёрки со средним 3,0 вместо 3,5. Правильно — rng.integers(1, 7).
В SciPy stats.uniform(loc, scale) принимает левый конец и ширину отрезка: loc = a, scale = b − a. Курьер приезжает с 10 до 14 часов: uniform(loc=10, scale=4) даёт среднее 12 и вероятность приехать до 11 часов 25%. Запись uniform(10, 14) — это отрезок от 10 до 24: среднее 17, до 11 часов 7,1%. При a = 0 ошибка не видна, поэтому она и живёт.
Результат random() при каждом запуске новый, а после setseed(0.42) последовательности у PostgreSQL и DuckDB разные, поэтому проверяемые расчёты здесь сделаны в Python с зерном.
| Инструмент | Число | Границы |
|---|---|---|
| PostgreSQL, DuckDB: random() | вещественное | 0 ≤ x < 1 |
| PostgreSQL 17: random(1, 6) | целое | оба конца включены |
| NumPy: rng.uniform(a, b) | вещественное | a ≤ x < b |
| NumPy: rng.integers(1, 7) | целое | верхний конец не включён |
| Excel: СЛЧИС() | вещественное | 0 ≤ x < 1 |
| Excel: СЛУЧМЕЖДУ(1; 6) | целое | оба конца включены |
WITH grid AS (
  SELECT (g + 0.5) / 1000.0 AS u FROM generate_series(0, 999) AS t(g)
)
SELECT v.value,
  (SELECT COUNT(*) FROM grid WHERE ROUND(u * 10) = v.value) AS by_round,
  (SELECT COUNT(*) FROM grid WHERE FLOOR(u * 10) = v.value) AS by_floor
FROM generate_series(0, 10) AS v(value)
ORDER BY v.value;
-- value | by_round | by_floor
--   0        50        100
--   1       100        100
--   …  значения 2–8: по 100 и 100
--   9       100        100
-- 10 50 0import numpy as np
from scipy import stats
rng = np.random.default_rng(42)
u = rng.random(100_000) # как random() в SQL: от 0 до 1, единица не включена
cells = np.bincount(np.floor(u * 10).astype(int), minlength=10) # десять ячеек шириной 0,1
print(cells.min(), cells.max(), round(u.mean(), 3), round(u.var(), 4), round(1 / 12, 4))
# 9844 10125 0.501 0.0832 0.0833
wait = rng.uniform(0, 20, size=1_000_000) # ожидание автобуса: отрезок от 0 до 20 минут
print(round(wait.mean(), 2), round(wait.var(), 2), round(wait.std(), 2), round((wait > 15).mean(), 3))
# 10.0 33.32 5.77 0.25
courier = stats.uniform(loc=10, scale=4) # отрезок [10, 14]: loc = a, scale = b − a
wrong = stats.uniform(10, 14) # ошибка: это отрезок [10, 24]
print(courier.mean(), courier.cdf(11), wrong.mean(), round(wrong.cdf(11), 3))
# 12.0 0.25 17.0 0.071
dice = rng.integers(1, 7, size=1_000_000) # кубик: верхняя граница не включается
no_six = rng.integers(1, 6, size=1_000_000) # ошибка: шестёрка не выпадет никогда
print(round(dice.mean(), 2), round(dice.var(), 2), round(no_six.mean(), 2), no_six.max())
# 3.5 2.92 3.0 5Как проверить, равномерно ли распределены данные
Основной инструмент — критерий хи-квадрат. Диапазон делят на ячейки и сравнивают число наблюдений в каждой с ожидаемым «поровну»: χ² = Σ (факт − ожидание)² / ожидание. P-value — вероятность получить такое же или большее расхождение, если данные равномерны; его считают по распределению хи-квадрат с числом степеней свободы «ячеек минус один».
Ячейки задают заранее, по гипотезе. Пустая ячейка при ожидании в сотни наблюдений — самое сильное свидетельство против равномерности, а GROUP BY по данным её не вернёт. В запросе список ячеек строит generate_series, данные присоединены через LEFT JOIN.
Время событий в учебной базе записано с точностью до минуты. Минута первого визита у 4 613 пользователей: в ячейках от 55 до 99 человек при ожидании 76,9, χ² = 53,17, p = 0,69 — равномерность не отвергнута. Час первого визита, от 8 до 18: χ² = 19,36, p = 0,036. Формально равномерность отвергнута. Но здесь виден генератор базы: час — остаток от деления хеша на 11, закономерность в него не заложена. Это ложная тревога: когда данные действительно равномерны, при пороге 0,05 она случается в одной проверке из двадцати. В рабочих данных генератора не видно — такой результат перепроверяют на другом периоде.
Для непрерывных величин есть критерий Колмогорова — Смирнова: он измеряет наибольшее расстояние D между накопленной долей значений в данных и F(x). В SciPy это kstest(x, 'uniform', args=(a, b − a)) — снова loc и scale. На времени, записанном до минуты, критерий ошибается: отброшенные секунды сдвигают накопленную долю на 1/60 ≈ 0,017, а при 4 613 наблюдениях он отвергает равномерность уже при D = 0,020. Для минуты первого визита D = 0,033 и p = 0,00008 при p = 0,69 у хи-квадрат. На 2 000 выборок заведомо равномерного времени p ниже 0,05 выпало в 5% случаев, а после отбрасывания секунд — в 86%; D не меньше нашего получилось в 6% таких выборок. Доля ложных отказов растёт с объёмом: при 500 наблюдениях — 12%.
WITH first_open AS (
  SELECT user_id, MIN(event_time) AS t FROM events GROUP BY user_id
),
obs AS (
  SELECT 1 AS check_id, CAST(EXTRACT(minute FROM t) AS integer) AS cell FROM first_open
  UNION ALL
  SELECT 2, CAST(EXTRACT(hour FROM t) AS integer) FROM first_open
  UNION ALL
  SELECT 3, CAST(EXTRACT(minute FROM event_time) AS integer) FROM events
  UNION ALL
  SELECT 4, CAST(EXTRACT(hour FROM event_time) AS integer) FROM events
  UNION ALL
  SELECT 5, CAST(EXTRACT(isodow FROM signup_date) AS integer) FROM users
),
cells AS (  -- ячейки заданы гипотезой, а не данными
  SELECT 1 AS check_id, 'минута первого визита' AS check_name, g AS cell
  FROM generate_series(0, 59) AS t(g)
  UNION ALL
  SELECT 2, 'час первого визита, 8–18', g FROM generate_series(8, 18) AS t(g)
  UNION ALL
  SELECT 3, 'минута любого события', g FROM generate_series(0, 59) AS t(g)
  UNION ALL
  SELECT 4, 'час любого события, 0–23', g FROM generate_series(0, 23) AS t(g)
  UNION ALL
  SELECT 5, 'день недели регистрации', g FROM generate_series(1, 7) AS t(g)
),
counted AS (
  SELECT c.check_id, c.check_name, c.cell, COUNT(o.cell) AS cnt
  FROM cells c
  LEFT JOIN obs o ON o.check_id = c.check_id AND o.cell = c.cell
  GROUP BY c.check_id, c.check_name, c.cell
),
expected AS (
  SELECT check_id, check_name, cnt,
    1.0 * SUM(cnt) OVER (PARTITION BY check_id)
      / COUNT(*) OVER (PARTITION BY check_id) AS expected_cnt
  FROM counted
)
SELECT check_name, COUNT(*) AS cells, SUM(cnt) AS n,
  MIN(cnt) AS min_cnt, MAX(cnt) AS max_cnt,
  ROUND(MAX(expected_cnt), 1) AS expected_cnt,
  ROUND(SUM((cnt - expected_cnt) * (cnt - expected_cnt) / expected_cnt), 2) AS chi2
FROM expected
GROUP BY check_id, check_name
ORDER BY check_id;
-- минута первого визита      60   4613   55    99    76.9     53.17
-- час первого визита, 8–18   11   4613  370   469   419.4     19.36
-- минута любого события      60  35341  396   739   589.0    405.59
-- час любого события, 0–23   24  35341    0  3268  1472.5  29831.85
-- день недели регистрации 7 4613 283 828 659.0 506.64import numpy as np
from scipy import stats
chi2 = np.array([53.17, 19.36, 405.59, 29831.85, 506.64]) # строки запроса
cells = np.array([60, 11, 60, 24, 7])
print(stats.chi2.sf(chi2, df=cells - 1).round(3))
# [0.689 0.036 0. 0. 0. ]
# минута первого визита: сколько пользователей пришлось на каждую минуту от 0 до 59
counts = np.array([76, 89, 70, 72, 55, 64, 93, 99, 73, 87, 80, 81, 90, 78, 81,
78, 73, 88, 80, 86, 81, 70, 67, 77, 80, 82, 88, 83, 82, 79,
76, 71, 80, 78, 75, 69, 68, 70, 77, 76, 71, 70, 74, 72, 74,
70, 72, 76, 77, 67, 77, 66, 92, 67, 67, 66, 81, 94, 77, 81])
minute = np.repeat(np.arange(60), counts)
ks = stats.kstest(minute, 'uniform', args=(0, 60)) # args = (a, b − a)
print(len(minute), round(ks.statistic, 3), f"{ks.pvalue:.5f}")
# 4613 0.033 0.00008
# тот же критерий на заведомо равномерном времени: точном и с отброшенными секундами
rng = np.random.default_rng(42)
p_exact, p_cut, d_cut = [], [], []
for _ in range(2000):
t = rng.uniform(0, 60, size=4613)
p_exact.append(stats.kstest(t, 'uniform', args=(0, 60)).pvalue)
cut = stats.kstest(np.floor(t), 'uniform', args=(0, 60))
p_cut.append(cut.pvalue)
d_cut.append(cut.statistic)
print(round(np.mean(np.array(p_exact) < 0.05), 3), round(np.mean(np.array(p_cut) < 0.05), 3))
# 0.05 0.858
print(round(1 / 60, 3), round(stats.kstwo.isf(0.05, 4613), 3), round(np.mean(np.array(d_cut) >= ks.statistic), 3))
# 0.017 0.02 0.06 — сдвиг от секунд, граница D при пороге 0,05, доля выборок с D не меньше наблюдаемогоГде равномерности в данных нет и почему
Остальные три строки запроса равномерность отвергают. Час любого события: из 24 ячеек семь пустых, χ² = 29 832: события в базе идут только с 6:00 до 22:59 — это свойство учебных данных. С ячейками из самих данных, которых 17, χ² был бы 10 823, почти втрое меньше: пустые часы в расчёт не попали бы.
День недели регистрации: 763–828 в будни, 350 в субботу и 283 в воскресенье, χ² = 506,64 (воскресений в окне 12, остальных дней по 13; с поправкой χ² = 460,39). Регистрации в учебной базе заданы формулой с недельным циклом.
Минута любого события: χ² = 405,59, хотя минута первого визита равномерна. Причина — зависимые строки. На пользователя приходится в среднем 7,66 события и всего 1,6 разных значения минуты: повторные визиты наследуют минуту первого. Критерий считает 35 341 строку независимыми наблюдениями, а независимых здесь не больше, чем пользователей, — 4 613. Проверять нужно по одной строке на пользователя. По той же причине завышены и статистики для часа любого события; там вывод не меняется: семь часов пусты.
Как равномерное распределение делит пользователей на группы A/B
Группу эксперимента назначают хешем, а не генератором: random() при следующем визите мог бы отправить того же человека в другую группу. Хеш-функция превращает строку «идентификатор и название теста» в число, которое ведёт себя как равномерное случайное, но для одного пользователя всегда одинаково.
В запросе хеш — md5 от user_id и названия теста, группа — по первому шестнадцатеричному знаку: от 0 до 7 — A, остальные — B. Из 4 613 пользователей в A попали 2 325, в B — 2 288. Все 16 значений знака встречаются от 261 до 308 раз при ожидании 288,3: χ² = 7,94, p = 0,93. Два теста с разными названиями делят людей независимо: на каждое из четырёх сочетаний групп приходится 24,7–25,6% пользователей. Название теста в строке нужно именно для этого: хеш от одного user_id в любом тесте отправит в группу A одних и тех же людей.
То же происходит с остатком от деления: user_id % 2 делит ещё ровнее — 2 306 и 2 307, но группы в любом тесте те же: эффекты двух одновременных экспериментов не разделить. Ровность здесь — тождество: идентификаторы выданы подряд.
В эксперименте учебной базы onboarding_checklist группы — 1 541 и 1 527 человек; хи-квадрат перекоса не находит ни в целом, ни по устройствам (p от 0,65 до 0,92).
WITH buckets AS (
  SELECT user_id,
    CASE WHEN substr(md5(CAST(user_id AS varchar) || ':new_pricing'), 1, 1) < '8'
      THEN 'A' ELSE 'B' END AS hash_pricing,
    CASE WHEN substr(md5(CAST(user_id AS varchar) || ':new_checkout'), 1, 1) < '8'
      THEN 'A' ELSE 'B' END AS hash_checkout,
    CASE WHEN user_id % 2 = 0 THEN 'A' ELSE 'B' END AS mod_group
  FROM users
)
SELECT 'хеш с названием теста' AS method, hash_pricing AS test_1, hash_checkout AS test_2,
  COUNT(*) AS users,
  ROUND(100.0 * COUNT(*) / SUM(COUNT(*)) OVER (), 1) AS pct
FROM buckets
GROUP BY hash_pricing, hash_checkout
UNION ALL
SELECT 'user_id % 2', mod_group, mod_group, COUNT(*),
  ROUND(100.0 * COUNT(*) / SUM(COUNT(*)) OVER (), 1)
FROM buckets
GROUP BY mod_group
ORDER BY method DESC, test_1, test_2;
-- хеш с названием теста  A  A  1182  25.6
-- хеш с названием теста  A  B  1143  24.8
-- хеш с названием теста  B  A  1148  24.9
-- хеш с названием теста  B  B  1140  24.7
-- user_id % 2            A  A  2306  50.0
-- user_id % 2 B B 2307 50.0Почему p-value распределены равномерно
Если взять непрерывную случайную величину X и подставить её в собственную функцию распределения, результат F(X) равномерен на отрезке от 0 до 1: ниже уровня u оказывается ровно доля u значений. P-value — та же операция над статистикой критерия. Поэтому, когда эффекта нет, p-value равномерны: ниже 0,05 — в 5% проверок, ниже 0,5 — в половине.
В симуляции 10 000 сравнений двух одинаковых групп по 200 человек в каждый из десяти интервалов шириной 0,1 попало от 978 до 1 045 значений p, ниже 0,05 — 5,2%; критерий Колмогорова — Смирнова равномерности не отвергает, p = 0,93. Это верно для непрерывных статистик: у долей на малых выборках p-value принимает лишь несколько значений и равномерно только приблизительно.
Следствие для отчётов: если в тесте 20 метрик и ни на одну изменение не влияет, хотя бы одно p ниже 0,05 появится с вероятностью 1 − 0,95²⁰ = 64,2%; в симуляции — в 64,4% отчётов. Так же стоит читать p = 0,036 выше: уже при пяти независимых проверках верной гипотезы хотя бы одно p ниже 0,05 выпадает в 22,6% случаев, а проверок в статье больше.
import numpy as np
from scipy import stats

rng = np.random.default_rng(42)
a = rng.normal(100, 20, size=(10_000, 200))      # 10 000 сравнений двух групп по 200
b = rng.normal(100, 20, size=(10_000, 200))      # из одного распределения: эффекта нет
p = stats.ttest_ind(a, b, axis=1).pvalue
print(np.histogram(p, bins=10, range=(0, 1))[0])
print(round((p < 0.05).mean(), 3), round(p.var(), 4), round(stats.kstest(p, 'uniform').pvalue, 2))
# [1045  978  999 1011 1007  985  989 1013  980  993]
# 0.052 0.0838 0.93

reports = p.reshape(500, 20)                     # 500 отчётов по 20 метрик без эффекта
print(round((reports.min(axis=1) < 0.05).mean(), 3), round(1 - 0.95 ** 20, 3), round(1 - 0.95 ** 5, 3))
# 0.644 0.642 0.226Как из равномерного числа получить взвешенный выбор
Метод обратного преобразования идёт в обратную сторону: берут равномерное u и находят x, для которого F(x) = u; у дискретной величины — первое значение, на котором накопленная доля превысила u. Так из одного числа получают взвешенный выбор. Тарифы с долями 55%, 32% и 13% дают накопленные пороги 0,55 и 0,87: u ниже первого — basic, ниже второго — pro, иначе team. На 200 000 чисел вышло 55,0%, 32,0% и 13,0%.
Частая ошибка в SQL — CASE WHEN random() < 0.55 … WHEN random() < 0.87 …: каждое условие вызывает random() заново. До второго условия доходят 45% строк, и 87% из них получают pro: доли выходят 55%, 0,45 · 0,87 ≈ 39% и 0,45 · 0,13 ≈ 6% вместо 55, 32 и 13. Число получают один раз в подзапросе и сравнивают с порогами уже его.
import numpy as np

rng = np.random.default_rng(42)
shares = np.array([0.55, 0.32, 0.13])            # basic, pro, team
u = rng.random(200_000)
plan = np.searchsorted(shares.cumsum(), u, side='right')   # пороги 0,55 и 0,87
print((np.bincount(plan) / len(u)).round(3))
# [0.55 0.32 0.13]

u2 = rng.random(200_000)                         # ошибка: второе условие получило своё число
wrong = np.where(u < 0.55, 0, np.where(u2 < 0.87, 1, 2))
print((np.bincount(wrong) / len(u)).round(3), round(0.45 * 0.87, 4), round(0.45 * 0.13, 4))
# [0.55  0.392 0.059] 0.3915 0.0585 — доли в симуляции и расчётные доли pro и team
Что получится, если сложить равномерные величины
Сумма двух независимых равномерных чисел от 0 до 1 распределена по треугольнику на отрезке от 0 до 2 с вершиной в единице. Между 0,5 и 1,5 лежит 75% значений суммы; у равномерного на отрезке от 0 до 2 — 50%. Дисперсии складываются: 2/12 ≈ 0,167.
В учебной базе так устроен час повторного визита: час первого, от 8 до 18, плюс сдвиг от −2 до +2, оба распределены почти поровну. У 24 080 визитов выходит трапеция: 2,1% в 6 часов и 8,8–9,5% с 10 до 16.
У суммы двенадцати чисел от 0 до 1 среднее 6 и дисперсия 12/12 = 1, поэтому сумма минус 6 похожа на стандартную нормальную величину: на миллионе симуляций в пределах ±1,96 — 95,1% значений. Отличие в хвостах: дальше ±3 оказалось 0,20% значений против 0,27% у нормального распределения, а дальше ±6 сумма не уходит. Так работает центральная предельная теорема: сумма независимых слагаемых приближается к нормальной, хотя каждое слагаемое плоское.
Миллион симуляций. По горизонтали — середина интервала шириной 0,2.
Где равномерное распределение обманывает
Ошибки округления, границ и параметров разобраны выше. Ещё три связаны с выборкой.
- На малой выборке равномерные данные выглядят неровно. Минуты первого визита у первых 100 пользователей по десяти шестиминутным ячейкам: от 5 до 14 человек при ожидании 10, χ² = 10,2, p = 0,33. В 10 000 симуляций самая полная из десяти ячеек набирала в среднем 15,1 наблюдения, самая пустая — 5,4.
- Выборка по дням перекашивает выборку по людям: «случайный день, затем случайный человек из зарегистрированных в этот день» отдаст июню 30 дней из 90, то есть 33,3% мест, хотя в июне пришли 1 042 пользователя из 4 613, меньше четверти. В день регистрируются от 14 до 100 человек, так что шансы попасть в выборку различаются до 7,1 раза.
- В случайной строке чаще оказывается активный пользователь. У владельца случайно выбранной строки
eventsсобытий в среднем 9,31 против 7,66 на пользователя: активные занимают больше строк и чаще попадают в выборку.
Частые вопросы
Как найти математическое ожидание и дисперсию равномерного распределения? На отрезке [2, 8] ожидание — (2 + 8)/2 = 5, дисперсия — (8 − 2)²/12 = 3, стандартное отклонение — √3 ≈ 1,73.
Чему равна плотность и может ли она быть больше единицы? Плотность — 1/(b − a): на отрезке [2, 8] это 1/6, на отрезке от 0 до 0,5 — 2. Плотность — высота прямоугольника, вероятность — его площадь, и она не больше единицы.
Что такое стандартное равномерное распределение? Распределение на отрезке от 0 до 1 со средним 0,5 и дисперсией 1/12 ≈ 0,083. Его и возвращают random() и СЛЧИС().
Чем равномерное распределение отличается от нормального? У равномерного плотность плоская и значения ограничены отрезком, у нормального — колокол с бесконечными хвостами. В пределах одного стандартного отклонения от среднего у равномерного лежит 57,7% значений, у нормального — 68,3%.
Что попробовать на учебной базе
Запросы статьи выполняются в песочнице симулятора SQL-аналитика: база там та же. В запросе с проверками замените ячейки часа первого визита: generate_series(0, 23) вместо generate_series(8, 18). Ячеек станет 24, а χ² вырастет с 19,36 до 5 493,97. Объясните, почему те же данные дали другой ответ и какую гипотезу проверяет каждый вариант.
Материалы по теме
Экспоненциальное (показательное) распределение: формула и примеры
Экспоненциальное (показательное) распределение: формула, среднее 1/λ, отсутствие памяти, связь с Пуассоном. Проверка на данных в SQL и Python и сравнение с равномерным.
Математическое ожидание: что это, формула и примеры
Математическое ожидание простыми словами: среднее, к которому результат сходится в долгую. Формула, пример на кубике, расчёт в SQL и Python, свойства и ловушки.
Коэффициент вариации: формула, расчёт и как читать
Коэффициент вариации — стандартное отклонение в процентах от среднего. Формула, пример на пяти числах, расчёт в SQL, Python и Excel, порог 33% для НМЦК и ловушки.