Когортный анализ: что это, как построить и читать таблицу
Когортный анализ простыми словами: как построить когортную таблицу в SQL, pandas и Excel, читать её по строкам, столбцам и диагоналям и что делать с незрелыми когортами.
Содержание статьи
Когортный анализ — это способ смотреть на метрику по группам пользователей, которые начали в один период, и сравнивать эти группы на одинаковом сроке жизни. Его результат — когортная таблица: строка — когорта, столбец — возраст, в клетке — удержание, выручка или доля оплативших. Ниже метод целиком на учебной базе симулятора SQL-аналитика: как построить таблицу в SQL, pandas и Excel, как читать её по строкам, столбцам и диагоналям, что делать с незрелыми когортами и каких выводов из неё делать нельзя.
Как выглядит когортная таблица и что в ней написано?
Когорта — группа людей с общим стартовым событием в одном периоде: например, все, кто зарегистрировался с 20 по 26 июля. Состав когорты не меняется. Само понятие разобрано в статье «Когорта: что это простыми словами», здесь речь о методе.
В таблице ниже три недельные когорты учебной базы. В клетке — доля когорты, заходившая в продукт на этой неделе жизни. Вторая неделя жизни — дни с 7-го по 13-й после регистрации, у каждого человека свои.
Читается она так. Из 377 человек, пришедших 20–26 июля, на второй неделе заходили 71,6%, на пятой — 44,3%. У двух следующих когорт вторая и третья недели почти такие же: 70,0 и 72,8%, 56,7 и 56,3%. Прочерк — срок, до которого когорта ещё не дожила: выгрузка кончается 30 августа.
Учебная база симулятора SQL-аналитика. Когорта — неделя регистрации, под ней размер. Первой недели нет: в день регистрации заходил каждый, там всегда 100%. Шкала цвета — от 40 до 80%.
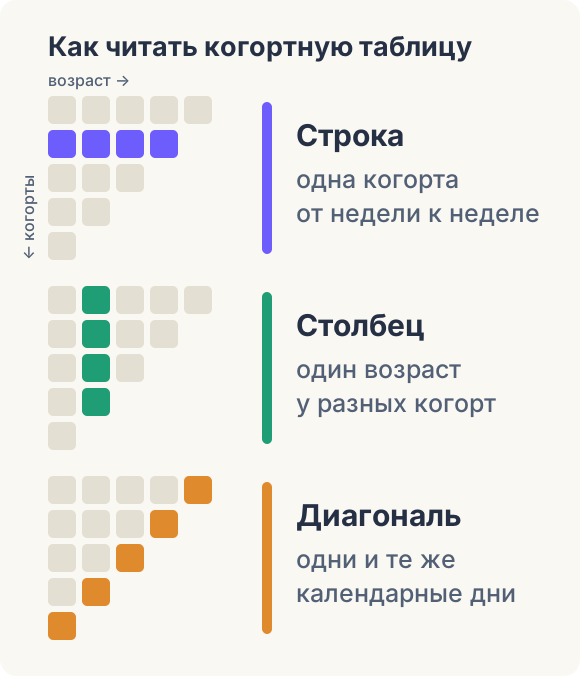
- Строка — одна когорта во времени, столбец — один срок жизни у разных когорт, диагональ — один календарный период.
- Когорты сравнивают на одинаковом и уже закрытом сроке жизни; недожитые клетки остаются пустыми.
- Рядом с процентом стоит размер когорты, рядом с разницей — интервал.
- Упавший столбец сначала проверяют на состав: в учебной базе июльские когорты слабее июньских из-за нового канала.
Как построить когортную таблицу: три решения и один запрос
До запроса решают три вещи. Что считать стартом и каким периодом резать когорты: здесь это регистрация и календарная неделя. Как мерить возраст. И что стоит в клетке.
Возраст считают двумя способами. Календарный — «следующая неделя после недели регистрации»: диагональ таблицы тогда ровно одна календарная неделя, но у пришедшего в воскресенье нулевая неделя длится день. Второй способ — окна от даты регистрации: дни 0–6, 7–13, 14–20. Срок у всех одинаковый, зато диагональ размывается на две календарные недели. В этой статье окна от регистрации, недели считаются с единицы (дни 0–6 — неделя 1), а заход — событие app_open.
В статье о когорте та же база посчитана иначе: недели календарные и нумеруются с нуля, так что тамошней «неделе 1» здесь соответствует «неделя 2». Числа всё равно расходятся: у когорт 6 июля – 10 августа там 76,1–80,5%, здесь 69,6–72,8%. Календарная неделя начинается в среднем на два-три дня жизни раньше, а в первые дни возвращаются чаще. Событие возврата почти ни при чём: всё, кроме app_open, случается в первые три дня.
Запрос помечает каждого пользователя флагами «заходил на неделе N» и считает долю по когорте. Условие cohort_week + 19 <= DATE '2026-08-29' оставляет клетку пустой, пока её окно не закрылось у пришедшего в последний день когорты: 6 дней до конца недели регистрации и ещё 13 дней жизни. 29 августа — последний полный день событий. Приём с флагами, дневные окна и три определения удержания разобраны в статье «Когорты и retention в SQL».
В ноутбуке ту же таблицу собирает pivot_table из длинной выгрузки «когорта, неделя, число заходивших». Строк для незрелых клеток в выгрузке нет, и pandas ставит там NaN.
WITH flags AS (                       -- зерно: один пользователь
  SELECT
    u.user_id,
    CAST(date_trunc('week', u.signup_date) AS date) AS cohort_week,
    MAX(CASE WHEN CAST(e.event_time AS date) - u.signup_date BETWEEN 7 AND 13 THEN 1 ELSE 0 END) AS w2,
    MAX(CASE WHEN CAST(e.event_time AS date) - u.signup_date BETWEEN 14 AND 20 THEN 1 ELSE 0 END) AS w3,
    MAX(CASE WHEN CAST(e.event_time AS date) - u.signup_date BETWEEN 21 AND 27 THEN 1 ELSE 0 END) AS w4,
    MAX(CASE WHEN CAST(e.event_time AS date) - u.signup_date BETWEEN 28 AND 34 THEN 1 ELSE 0 END) AS w5
  FROM users u
  LEFT JOIN events e ON e.user_id = u.user_id AND e.event_name = 'app_open'
  WHERE u.signup_date >= DATE '2026-07-20' AND u.signup_date < DATE '2026-08-10'
  GROUP BY u.user_id, u.signup_date
)
SELECT
  cohort_week,
  COUNT(*) AS cohort_size,
  CASE WHEN cohort_week + 19 <= DATE '2026-08-29' THEN ROUND(100.0 * SUM(w2) / COUNT(*), 1) END AS week_2,
  CASE WHEN cohort_week + 26 <= DATE '2026-08-29' THEN ROUND(100.0 * SUM(w3) / COUNT(*), 1) END AS week_3,
  CASE WHEN cohort_week + 33 <= DATE '2026-08-29' THEN ROUND(100.0 * SUM(w4) / COUNT(*), 1) END AS week_4,
  CASE WHEN cohort_week + 40 <= DATE '2026-08-29' THEN ROUND(100.0 * SUM(w5) / COUNT(*), 1) END AS week_5
FROM flags
GROUP BY cohort_week
ORDER BY cohort_week;import pandas as pd
# длинная выгрузка из SQL: когорта, неделя жизни, заходили, размер когорты — только зрелые клетки
long = pd.DataFrame(
[('2026-07-20', 2, 270, 377), ('2026-07-20', 3, 212, 377), ('2026-07-20', 4, 210, 377), ('2026-07-20', 5, 167, 377),
('2026-07-27', 2, 283, 404), ('2026-07-27', 3, 229, 404), ('2026-07-27', 4, 209, 404),
('2026-08-03', 2, 313, 430), ('2026-08-03', 3, 242, 430)],
columns=['cohort_week', 'week_no', 'active_users', 'cohort_size'],
)
long['retention_pct'] = (100 * long.active_users / long.cohort_size).round(1)
table = long.pivot_table(index=['cohort_week', 'cohort_size'], columns='week_no', values='retention_pct')
print(table)Какие бывают когорты и чем опасны поведенческие?
Когорту задаёт стартовое событие или признак, известный на старте. От выбора зависит вопрос, на который ответит таблица.
Каналы и поведение в таблице посчитаны по регистрациям с 1 июля по 2 августа: платный поиск запущен 1 июля, а четвёртая неделя закрыта у пришедших по 2 августа включительно. Тарифы — по 502 первым оплатам по 31 июля включительно: срок продления у них уже наступил.
С поведенческими когортами нужна осторожность. Человек попадает в них по событию после входа, и отбирает себя сам. Разница 57,0 против 48,2% (по неокруглённым долям 8,7 ± 4,7 процентного пункта, п. п.; после ± здесь и дальше — половина 95%-го доверительного интервала) похожа на эффект: создал пространство — остался. Но пространство чаще создают пришедшие из сильных каналов: платный поиск — это 43,1% не создавших и 18,2% создавших. Внутри каналов разница — от 0,2 до 4,8 п. п. при интервалах ± 8–12, а взвешенная по каналам — 2,8 ± 4,9 п. п.: втрое меньше исходной и неотличима от нуля. В учебной базе ответ известен точно: шанс возврата задан каналом и днём жизни, создание пространства на него не влияет.
Поведенческая когорта описывает, кто остаётся, но не доказывает, что действие удерживает. Здесь работает смешивающая переменная: канал влияет и на создание пространства, и на возврат. Как делить такую разницу на состав и уровень — в статье о парадоксе Симпсона; причинные гипотезы проверяют экспериментом.
| Когорта | Как собрана | Что показала |
|---|---|---|
| По дате первого действия | месяц регистрации | июньская регистрация принесла 6,64 доллара за 30 дней, июльская — 5,47 |
| По каналу | период регистрации и канал | на четвёртой неделе заходили 64,6% пришедших по рекомендации и 38,1% из платного поиска |
| По тарифу или продукту | первая оплата и тариф | через 30 дней продлили 57,3% на basic, 58,2% на pro, 58,9% на team |
| Поведенческая | действие в первые дни | создавшие рабочее пространство: 57,0% на четвёртой неделе против 48,2% у остальных |
Метрики когортного анализа: что ставить в клетки?
Удержание отвечает на вопрос «возвращаются ли». Классическое считает тех, кто заходил хотя бы раз за неделю N (в статье о retention в SQL это bracket). Вариант «на неделе N или позже» растёт, пока когорта живёт, и для сравнения когорт не годится. У когорт 15 июня, 20 и 27 июля классическая четвёртая неделя — 57,8, 55,7 и 51,7%. «Четвёртая или позже» — 97,2, 82,0 и 67,1%. Когорта 15 июня при том же сроке наблюдения, что у когорты 27 июля, показала бы 69,9%: из тридцати пунктов разницы двадцать семь дал срок.
Доля оплативших и выручка на человека считаются накопленным итогом: в клетке всё, что случилось с начала жизни до конца периода. Такая строка только растёт. Выручка накопленным итогом на одного зарегистрированного — это исторический LTV когорты к этому сроку (возвратов в учебной базе нет, поэтому выручка равна чистой); как его считать и продлевать, разобрано в статье про LTV по когортам.
В учебной базе первая оплата приходит на 3–20-й день после регистрации, поэтому доля оплативших набирается за три недели и дальше не меняется.
Знаменатель у всех трёх метрик один — размер когорты на старте. Он должен стоять рядом с процентом: 24% от 429 человек и 24% от 40 — числа разной надёжности.
Метрику выбирают по решению, которое предстоит принять: для онбординга — удержание первых недель, для закупки — выручку на человека к сроку окупаемости, для цен и тарифов — долю оплативших и продления.
| Метрика | На какой вопрос отвечает | Как ведёт себя строка |
|---|---|---|
| Удержание на неделе N | возвращаются ли на этом сроке | падает и выравнивается, местами подрастает |
| Удержание «N или позже» | ушёл ли человек совсем | с возрастом не растёт; каждая клетка дорастает, пока когорту наблюдают |
| Доля оплативших | доходят ли до первой оплаты | растёт до потолка |
| Выручка на человека, LTV к сроку | сколько денег приносит регистрация | растёт, пока идут продления |
Учебная база симулятора SQL-аналитика. Клетка заполнена, если срок закрыт у всех участников когорты.
Как читать когортную таблицу: строка, столбец, диагональ
У когортной таблицы три направления чтения. Ниже схема и полная таблица удержания учебной базы: одиннадцать недельных когорт, недели жизни со второй по шестую.
Учебная база симулятора SQL-аналитика. Когорта — неделя регистрации, начинается в указанный понедельник. Платный поиск запущен 1 июля: в когорте 29 июня его 59 человек из 300, в следующих — 26–31%. Шкала цвета — от 40 до 80%, шаг 6,7 п. п.: примерно полуширина 95%-го интервала одной клетки (± 4–7 п. п.).
Что видно по строке, столбцу и диагонали
Строка — одна когорта во времени. Когорта 22 июня: 73,3% на второй неделе, 59,0% на четвёртой, 53,5% на шестой. По строке видно, как быстро люди уходят и где кривая выравнивается.
Столбец — один возраст у разных когорт. Это главное сравнение: стали ли новые пользователи вести себя иначе. В столбце «Неделя 4» у четырёх июньских когорт 57,8–60,1%, у четырёх июльских — 51,2–55,7%: каждая июльская ниже каждой июньской. В сумме 59,0% (555 из 941) против 53,3% (818 из 1 536), разница −5,7 ± 4,0 п. п.
Диагональ — одни и те же календарные дни. Последние заполненные клетки строк — шестая неделя у когорты 13 июля, пятая у 20 июля и так до второй у 10 августа — приходятся на 17–29 августа. Сбой или релиз задевает все когорты сразу и ложится полосой по диагонали.
В учебной базе на диагонали лежит край данных. События обрываются 30 августа в 12:59, и без проверки зрелости в первых пустых клетках четырёх последних строк стояли бы 40,5, 30,9, 31,4 и 27,6% — на 12–20 пунктов ниже худшего зрелого значения в своём столбце. Похоже на аварию в конце августа, а это недожитые недели.
Есть здесь и провал по столбцу. На девятой неделе у июньских когорт 19,7–29,1% после 39,0–50,2% на восьмой. Причина — в данных: в учебной базе у каждого пользователя есть события только за дни 0–59 после регистрации — так она сгенерирована. От девятой недели, дней 56–62, осталось четыре дня из семи. Провал, привязанный к возрасту, ищут в продукте или, как здесь, в том, как собраны данные.
Пример когортного анализа: почему июльские когорты слабее июньских?
Тот же разрыв виден в деньгах. За первые 30 дней июньская регистрация принесла 6,64 доллара на человека, июльская — 5,47; разница по неокруглённым средним 1,16 ± 0,87. Сравнение честное: срок одинаковый и закрыт у обеих когорт.
Столбец «за всё время» так сравнивать нельзя: 11,81, 7,22 и 3,29 — это три разных срока жизни. Августовская когорта не втрое хуже июньской, ей меньше месяца.
Причина разрыва — состав. С 1 июля в базе появился платный поиск, это 28,8% июльских регистраций, и его пользователи приносят 2,59 доллара за 30 дней. Июльская когорта без платного поиска — 6,64, ровно как июньская. С удержанием то же: без платного поиска четвёртая неделя июльских когорт — 58,9% против 59,0% у июньских (разница 0,0 ± 4,3 п. п.), у самого платного поиска — 39,3%.
Отсюда решение: причину в продукте не искать — у прежних каналов ничего не изменилось. Канал оценить отдельно: окупают ли 2,59 доллара за 30 дней цену привлечения. Расходов в учебной базе нет, и дальше она не отвечает. Таблица показала, что столбец упал; почему он упал, показал разрез когорты по каналам.
| Месяц регистрации | Размер когорты | За 14 дней | За 30 дней | За 60 дней | За всё время |
|---|---|---|---|---|---|
| июнь | 1 042 | 3,89 | 6,64 | 10,64 | 11,81 |
| июль | 1 676 | 3,31 | 5,47 | — | 7,22 |
| август | 1 895 | — | — | — | 3,29 |
WITH revenue AS (                     -- зерно: один пользователь
  SELECT
    u.user_id,
    CAST(date_trunc('month', u.signup_date) AS date) AS cohort_month,
    CAST(date_trunc('month', u.signup_date) + INTERVAL '1 month' AS date) - 1 AS month_end,
    COALESCE(SUM(CASE WHEN p.paid_at - u.signup_date < 14 THEN p.amount END), 0) AS rev_14,
    COALESCE(SUM(CASE WHEN p.paid_at - u.signup_date < 30 THEN p.amount END), 0) AS rev_30,
    COALESCE(SUM(CASE WHEN p.paid_at - u.signup_date < 60 THEN p.amount END), 0) AS rev_60,
    COALESCE(SUM(p.amount), 0) AS rev_all
  FROM users u
  LEFT JOIN payments p ON p.user_id = u.user_id
  GROUP BY u.user_id, u.signup_date
)
SELECT
  cohort_month,
  COUNT(*) AS cohort_size,
  CASE WHEN month_end + 13 <= DATE '2026-08-29' THEN ROUND(SUM(rev_14) / COUNT(*), 2) END AS per_user_14d,
  CASE WHEN month_end + 29 <= DATE '2026-08-29' THEN ROUND(SUM(rev_30) / COUNT(*), 2) END AS per_user_30d,
  CASE WHEN month_end + 59 <= DATE '2026-08-29' THEN ROUND(SUM(rev_60) / COUNT(*), 2) END AS per_user_60d,
  ROUND(SUM(rev_all) / COUNT(*), 2) AS per_user_all_time
FROM revenue
GROUP BY cohort_month, month_end
ORDER BY cohort_month;
Что делать с незрелыми когортами?
Незрелые клетки образуют правый нижний треугольник: чем моложе когорта, тем меньше у неё заполненных столбцов. Правило одно: клетка получает число, только если её срок закрылся у всех участников когорты до конца полных данных. Иначе в ней пусто, а не ноль.
Что будет, если правило нарушить, видно на столбце «Неделя 4». Сложить всех заходивших на четвёртой неделе и поделить на всех зарегистрированных — 36,1%. Усреднить клетки столбца, отбросив нули трёх последних когорт, но оставив недожитые 30,9% когорты 3 августа, — 53,3% (совпадение с 53,3% июльских когорт случайно). Простое среднее девяти зрелых клеток — 55,8%. По зрелым когортам через суммы, до 27 июля включительно, — 55,2%. Первая ошибка занижает удержание на 19 пунктов, вторая — на 2,5 против такого же среднего по зрелым клеткам. На шестой неделе первая ошибка даёт 23,2% вместо 48,5%. В статье о когорте та же ловушка показана на календарных неделях, поэтому числа там другие: 31,7% вместо 53,4%.
С деньгами так же. Выручка за 30 дней по всем 4 613 регистрациям — 4,84 доллара на человека, по зрелым июньской и июльской когортам — 5,92. Незрелый август занизил оценку на 18%.
Честное сравнение когорт держится на трёх условиях: одинаковый срок жизни, срок закрыт у всех участников обеих когорт, состав по каналам сопоставим. Средние по столбцу считайте по зрелым когортам и через суммы — заходивших делить на размер, — чтобы большая когорта весила больше маленькой.
Если ждать зрелости некогда, незавершённые наблюдения умеет учитывать анализ выживаемости: молодая когорта участвует в оценке на том сроке, который успела прожить.
| Как посчитано | Расчёт | Результат |
|---|---|---|
| Все регистрации; у молодых когорт недожитое считается нулём | 1 665 / 4 613 | 36,1% |
| Простое среднее клеток вместе с недожитой клеткой 3 августа | десять клеток | 53,3% |
| Простое среднее зрелых клеток | девять клеток | 55,8% |
| Зрелые когорты, через суммы | 1 532 / 2 777 | 55,2% |
Как сделать когортный анализ в Excel, SQL и BI?
В SQL когортная таблица — это флаги на пользователя и группировка, как в запросах выше. Выгружать удобнее длинный формат: когорта, возраст, размер, значение. Такую выгрузку возвращает запрос из статьи о когорте, только недели там календарные. Широкий вид с неделями в столбцах делают последним шагом: в SQL через CASE, в pandas через pivot_table, в Excel сводной таблицей.
В Excel вставьте выгрузку на лист и постройте сводную таблицу: когорту — в область «Строки», неделю жизни — в «Столбцы», долю — в «Значения». Строк для незрелых клеток в выгрузке быть не должно, тогда клетки останутся пустыми. Тепловую карту даёт «Главная» → «Условное форматирование» → «Цветовые шкалы»: по справке Microsoft, в Excel для Windows оно применяется и к отчёту сводной таблицы. Общие итоги отключите — на вкладке «Конструктор» в меню «Общие итоги»: сумма процентов по неделям ничего не значит, а цветовая шкала, захватив итоги, растянется на них. О самом инструменте — статья о сводных таблицах в Excel.
В Metabase сводная таблица, по документации, строится только для вопросов из конструктора запросов. Для вопроса на SQL верните широкую таблицу прямо из запроса и включите в настройках таблицы условное форматирование с цветовой шкалой (Conditional Formatting, правило Color range). В Yandex DataLens у чарта «Сводная таблица» есть секции «Строки», «Столбцы» и «Показатели», заливка ячеек градиентом настраивается у показателя; в QL-чартах этот тип не поддерживается.
Какие выводы делают по когортной таблице и где ошибаются?
Каждое направление чтения ведёт к своей проверке: слабая строка — к составу когорты, просевший столбец — к шагу продукта на этом сроке жизни, полоса по диагонали — к журналу релизов и полноте данных (пример на условных числах — в статье «Retention по когортам и каналам»). Ниже четыре частые ошибки на числах той же базы.
Общая метрика вместо когорт. Выручка по месяцу оплаты растёт: 3 983, 10 868, 15 788 долларов, вчетверо от июня к августу. Ценность новой регистрации за 30 дней при этом упала с 6,64 до 5,47. Календарный отчёт складывает когорты разного возраста и размера: выручка растёт, потому что платящих когорт стало три и старые продлевают подписку, а новая регистрация при этом подешевела.
Эффект возраста, принятый за календарный. Доля активных за неделю среди всех зарегистрированных упала с 90,5% на второй неделе июня до 45,9% на последней, неполной, неделе августа. В продукте ничего не сломалось: база стареет, старые когорты заходят реже, а у 853 человек, пришедших до 26 июня, записи о событиях к последней неделе закончились — без них было бы 56,3%. Обратная ошибка — принять полосу по диагонали за поведение когорт.
Маленькие когорты без интервалов. Недельная когорта 20 июля на второй неделе — 71,6% ± 4,6 п. п. Дневные когорты той же недели дают от 60,9% (64 человека, ± 12,0) до 80,3% (66 человек, ± 9,6), и оба интервала накрывают 71,6. Разброс в двадцать пунктов создан размером группы.
Охота за яркой клеткой. В таблице из 45 клеток пара соседей разойдётся и случайно: 73,1 и 62,7% на третьей неделе у когорт 8 и 15 июня, разница 10,4 ± 8,4 п. п. При этом возврат в учебной базе зависит только от канала и дня жизни, а каналы у обеих когорт одни и те же. Чем больше клеток сравнивают, тем чаще такие находки — см. множественные сравнения.
import numpy as np

def share(x, n):
    p = x / n
    return p * 100, 1.96 * np.sqrt(p * (1 - p) / n) * 100

def diff(x1, n1, x2, n2):
    p1, p2 = x1 / n1, x2 / n2
    se = np.sqrt(p1 * (1 - p1) / n1 + p2 * (1 - p2) / n2)
    return (p2 - p1) * 100, 1.96 * se * 100

# заходили / размер когорты — из когортной таблицы
for name, (x, n) in {
    'неделя 2, когорта 20 июля': (270, 377),
    'неделя 2, пришли 21 июля':  (39, 64),
    'неделя 2, пришли 24 июля':  (53, 66),
}.items():
    p, half = share(x, n)
    print(f'{name}: {p:.1f}% ± {half:.1f} п. п.')

for name, args in {
    'неделя 4, июнь → июль':          (555, 941, 818, 1536),
    'то же без платного поиска':      (555, 941, 643, 1091),
    'неделя 3, когорты 8 и 15 июня':  (163, 223, 156, 249),
    'неделя 4, без пространства → с ним': (365, 757, 557, 978),
}.items():
    d, half = diff(*args)
    d = round(d, 1) + 0.0             # иначе −0,04 напечатается как «-0.0»
    print(f'{name}: {d:+.1f} ± {half:.1f} п. п.')
Частые вопросы
Когортный анализ — это что простыми словами? Пользователей делят на группы по времени старта и смотрят, что стало с каждой группой через неделю, две, месяц. Так новые сравниваются с новыми и не тонут в общей сумме.
Зачем когортный анализ в маркетинге? Чтобы оценивать канал по тому, что стало с привлечёнными, а не по числу регистраций. Когорты по каналу и месяцу показывают, сколько денег закупка принесла к 30-му дню и когда она окупилась. В учебной базе платный поиск дал 28,8% июльских регистраций и 2,59 доллара на человека за 30 дней против 6,64 у остальных каналов.
Какие метрики смотрят в когортном анализе? Удержание, долю оплативших, выручку на человека накопленным итогом, число повторных покупок, отток. Подойдёт любая метрика, у которой знаменатель — размер когорты на старте.
Как связаны когортный анализ и LTV? LTV — это строка когортной таблицы с выручкой накопленным итогом: у июньской когорты 3,89 доллара к 14-му дню, 6,64 к 30-му, 10,64 к 60-му. Прогноз LTV продолжает эту строку за пределы прожитого срока.
Когда когортный анализ не нужен? Когда вопрос задан про текущее состояние: выручка месяца, нагрузка на поддержку, план продлений — тут хватит календарного отчёта. И когда когорты слишком малы: при десятках человек в строке интервалы шире любых различий, и когорты укрупняют до недели или месяца.
Что читать дальше
Запросы из статьи можно выполнить в песочнице симулятора SQL-аналитика: там та же учебная база.
Упражнение: соберите когорты по каналу для июльских регистраций и посчитайте выручку за 30 дней на человека. Должно получиться 7,83 доллара у referral, 6,70 у organic, 4,78 у partner и 2,59 у paid_search.
Материалы по теме
Когорта: что это простыми словами, виды когорт и пример на данных
Когорта — группа пользователей с общим стартовым событием в одном периоде. Какие бывают когорты, чем когорта отличается от сегмента, пример на учебной базе и почему последние когорты нельзя сравнивать с остальными.
Когорты и retention в SQL: как считать возвращаемость по датам
Разбираем когортный retention в SQL: как определить дату старта, посчитать D1 и D7, собрать матрицу возвращаемости и сравнить каналы без самообмана.
Unit-экономика продукта: CAC, LTV и срок окупаемости
Как связать стоимость привлечения, маржинальную выручку и поведение когорт: разбираем CAC, LTV, payback period и типичные ошибки в unit-экономике.