Ящик с усами (boxplot): как читать и как найти выбросы
Ящик с усами — график медианы, квартилей и выбросов по правилу 1,5·IQR. Как его читать, почему pandas, R и Excel рисуют его по-разному и что он скрывает.
Содержание статьи
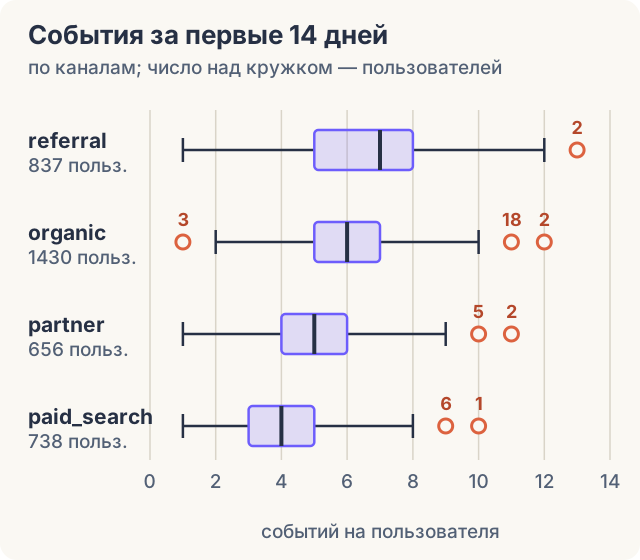
Продакт просит сравнить, насколько активны в первые две недели пользователи из четырёх каналов. Коллега присылает из ноутбука картинку: четыре прямоугольника с отростками и россыпь кружков по краям. И вопрос в чате: «Выбросы убрать перед расчётом?» На учебной базе «Маяк» кружками отмечены 39 пользователей из 3 661. Ошибок среди них нет: верхние 36 заходили в продукт в среднем 8 дней из 14. Ниже — как читать ящик с усами (boxplot), откуда взялось правило 1,5·IQR, почему один и тот же ящик в pandas, R и Excel получается разным и чего на этом графике не видно совсем.
Коротко
- Ящик с усами (boxplot, диаграмма размаха) рисует распределение пятью числами: ящик от первого квартиля Q1 до третьего Q3, линия медианы внутри, усы по бокам и отдельные точки за ними.
- Длина ящика — межквартильный размах IQR = Q3 − Q1. В нём лежит средняя половина наблюдений.
- По правилу Джона Тьюки ус доходит до самого дальнего значения, которое отстоит от края ящика не больше чем на 1,5·IQR. Всё, что дальше, рисуют точками. В matplotlib это
whis=1.5по умолчанию. - Точка за усом — повод проверить строку, а не приговор. В продуктовых данных так чаще всего выглядят самые активные пользователи.
- Квартили считают разными способами. Для одной когорты из 20 человек pandas,
percentile_disc, Excel и R находят 3, 4, 0 и 0 выбросов. - Двух пиков, массы нулей и размера группы ящик не показывает. Рядом нужна гистограмма, violin или хотя бы подпись n.
Из чего состоит ящик с усами
Отсортируйте значения. Медиана делит их пополам, квартили — на четыре равные по числу части: ниже Q1 лежит четверть наблюдений, ниже Q3 — три четверти. Что такое квартиль и как он связан с перцентилем, разобрано в отдельном материале; здесь важно, как эти числа ложатся на рисунок.
Ящик занимает отрезок от Q1 до Q3, жирная линия внутри — медиана. От краёв ящика откладывают по 1,5·IQR: получаются границы, которые на графике обычно не рисуют. Ус тянется не до самой границы, а до последнего реального значения перед ней. Точки за усами — кандидаты в выбросы.
Таблица показывает это на канале organic: 1 430 пользователей, у каждого — число событий за первые 14 дней после регистрации. Рисунок под ней — все четыре канала на одной оси.
| Элемент | Как считается | organic |
|---|---|---|
| Медиана | середина отсортированного ряда | 6 |
| Нижний край ящика | Q1, 25-й перцентиль | 5 |
| Верхний край ящика | Q3, 75-й перцентиль | 7 |
| Длина ящика | IQR = Q3 − Q1 | 2 |
| Границы (не рисуются) | Q1 − 1,5·IQR и Q3 + 1,5·IQR | 2 и 10 |
| Нижний ус | наименьшее значение не ниже нижней границы | 2 |
| Верхний ус | наибольшее значение не выше верхней границы | 10 |
| Точки | всё, что за усами | 3 человека с 1 событием, 18 с 11, 2 с 12 |
Правило 1,5·IQR: откуда оно и почему именно полтора
Ящик с усами придумал Джон Тьюки. Впервые он описал его в предварительном издании «Exploratory Data Analysis» в 1970 году, а широко график разошёлся после книги 1977 года. Тьюки называл шагом полтора межквартильных размаха. Внутренние границы стоят в одном шаге от краёв ящика, внешние — в двух, то есть в 3·IQR. Значения между ними он относил к «outside», за внешними — к «far out». Большинство библиотек сегодня рисует только внутренние границы, а все точки за ними — одинаково.
Почему полтора, видно на нормальном распределении. Его квартили отстоят от среднего на 0,674 стандартного отклонения, значит, внутренние границы лежат на ±2,70σ. За ними остаётся 0,70% значений — примерно семь на тысячу. За внешними границами (±4,72σ) — около двух на миллион. На симметричных данных правило отмечает редкость, а не каждое заметное значение.
На скошенных продуктовых данных доля помеченных намного больше. В материале о перцентилях то же правило на паузах между действиями пользователей отмечает 8,7% пауз: у величины без верхнего предела длинный правый хвост — её нормальное состояние.
IQR = Q3 − Q1; кандидат в выбросы, если x < Q1 − 1,5·IQR или x > Q3 + 1,5·IQRДля organic: 5 − 1,5 · 2 = 2 и 7 + 1,5 · 2 = 10. Пользователи с 1, 11 и 12 событиями за 14 дней — за границами.
Как рисуют усы в matplotlib, R и Excel
Частая ошибка ручных рисунков — ус до самой границы. У канала referral верхняя граница 12,5 события, а ус кончается на 12: дальше просто нет пользователей, которые попали бы в пределы. Ус всегда стоит на реальном значении.
Вторая ловушка — соглашения. Одни инструменты по умолчанию рисуют усы по Тьюки, другие разрешают растянуть их до минимума и максимума, третьи — до заданных перцентилей. Ящики с двух дашбордов сравнивают, только убедившись, что усы на них означают одно и то же.
| Инструмент | Квартили | Усы по умолчанию | Как поменять |
|---|---|---|---|
matplotlib, Axes.boxplot | np.percentile, линейная интерполяция | 1,5·IQR (whis=1.5) | whis=(5, 95) — перцентили, whis=(0, 100) — от минимума до максимума |
R, boxplot() | шарниры Тьюки (fivenum), при чётном n отличаются от квартилей | 1,5·IQR (range = 1.5) | range = 0 — усы до крайних значений |
| Excel 2016+, «Прямоугольник с усами» | «Инклюзивная» или «Исключающая медиана» | точки выбросов включаются флажком | формат ряда данных |
| SQL (PostgreSQL, DuckDB) | percentile_cont или percentile_disc | графика нет: границы считают сами | см. запрос ниже |
Если Q1 = Q3, у ящика нет высоты, а все значения, кроме самого частого, улетают в точки. В matplotlib на этот случай есть autorange=True: усы растягиваются до минимума и максимума. Пример — в разделе о нулях ниже.
Пример: пятичисловая сводка и выбросы по каналам в SQL
Графика в SQL нет, но все числа ящика считаются одним запросом. Зерно — один пользователь. Берём только тех, у кого 14-дневное окно закрыто: выгрузка обрывается 30 августа в 12:59, поэтому регистрации по 16 августа включительно. Квартили — percentile_cont, так же как в matplotlib. Усы — минимум и максимум среди значений внутри границ, выбросы — счётчики за ними.
Медиана растёт от paid_search (4 события) к referral (7). Ящики этих двух каналов касаются только краями: Q3 у paid_search равен 5, Q1 у referral — тоже 5. Различие видно без всяких тестов, и это главное, ради чего ящики ставят рядом.
Выбросов немного: 39 пользователей из 3 661, 1,1%. Важнее, что правило меряет каждую группу её собственной линейкой. Девять событий за две недели в paid_search — выброс (6 человек), а в referral таких 81, и они спокойно сидят внутри уса. Одно событие в organic — нижний выброс (3 человека), в paid_search таких 42, и это обычный край распределения. Поэтому, сравнивая каналы, спорьте о положении ящиков, а не о числе точек.
По устройствам картинка скучнее: у desktop и mobile одинаковые квартили, 4 и 7, а семь точек достались desktop только потому, что там максимум 13 событий, а у mobile — 11, ровно под границей 11,5.
with activity as (
  select u.user_id, u.channel, count(e.event_id) as events_14d
  from users as u
  left join events as e
    on e.user_id = u.user_id
   and e.event_time < u.signup_date + interval '14 days'
  where u.signup_date <= date '2026-08-16'
  group by u.user_id, u.channel
),
box as (
  select channel, count(*) as users,
    percentile_cont(0.25) within group (order by events_14d) as q1,
    percentile_cont(0.5)  within group (order by events_14d) as median,
    percentile_cont(0.75) within group (order by events_14d) as q3
  from activity
  group by channel
)
select b.channel, b.users, b.q1, b.median, b.q3,
  b.q3 + 1.5 * (b.q3 - b.q1) as upper_fence,
  min(a.events_14d) filter (where a.events_14d >= b.q1 - 1.5 * (b.q3 - b.q1)) as whisker_low,
  max(a.events_14d) filter (where a.events_14d <= b.q3 + 1.5 * (b.q3 - b.q1)) as whisker_high,
  count(*) filter (where a.events_14d < b.q1 - 1.5 * (b.q3 - b.q1)) as below,
  count(*) filter (where a.events_14d > b.q3 + 1.5 * (b.q3 - b.q1)) as above
from box as b
join activity as a on a.channel = b.channel
group by b.channel, b.users, b.q1, b.median, b.q3
order by b.median desc;
-- channel      users  q1  median  q3  upper_fence  whisker_low  whisker_high  below  above
-- referral       837   5       7   8         12.5            1            12      0      2
-- organic       1430   5       6   7           10            2            10      3     20
-- partner        656   4       5   6            9            1             9      0      7
-- paid_search 738 3 4 5 8 1 8 0 7Как найти выбросы и что с ними делать
Правило дало список. Дальше нужно понять, кто в нём. Первым делом проверяют источник: дубли событий, тестовые и служебные аккаунты, ботов, повторную загрузку одного дня. Запрос ниже делит пользователей на три зоны и смотрит, как распределены их события по дням.
Картина однозначная. 36 человек над верхней границей сделали в среднем 10,7 события и были активны 7,9 дня из 14, у остальных — 5,6 события за 4,4 дня. Больше трёх событий за день не бывает ни у кого, дублей по паре «пользователь — время — событие» в таблице нет. Это не всплеск и не сбой трекера, а люди, которые пользуются продуктом через день. Трое снизу зашли один раз и за две недели не вернулись — тоже реальное поведение.
Что делать с такими значениями, зависит от вопроса. Если считаете медиану и квартили — ничего: они к паре десятков крайних значений почти не чувствительны. Если нужно среднее или A/B-тест на скошенной метрике — ограничьте значения сверху (винзоризация, например на P99 или на верхнем усе) или работайте с логарифмом. Правило и порог записывают в методику заранее, а не подбирают после того, как увидели результат. Если крайние значения интересны сами по себе — выделите их в сегмент «активное ядро» и смотрите отдельно: в нём часто сидят будущие платящие или чемпионы продукта.
Чего делать нельзя — удалять строки молча. «Данные очищены от выбросов» без правила и числа удалённых строк через неделю превращается в спор о том, куда делась часть пользователей. Подробный разбор решений на деньгах — в материале о выбросах.
with daily as (
  select e.user_id, cast(e.event_time as date) as day, count(*) as events
  from events as e
  join users as u on u.user_id = e.user_id
  where e.event_time < u.signup_date + interval '14 days'
  group by e.user_id, cast(e.event_time as date)
),
activity as (
  select u.user_id, u.channel,
    sum(d.events) as events_14d,
    count(*) as active_days,
    max(d.events) as busiest_day
  from users as u
  join daily as d on d.user_id = u.user_id
  where u.signup_date <= date '2026-08-16'
  group by u.user_id, u.channel
),
fences as (
  select channel,
    percentile_cont(0.25) within group (order by events_14d) as q1,
    percentile_cont(0.75) within group (order by events_14d) as q3
  from activity
  group by channel
)
select
  case
    when a.events_14d > f.q3 + 1.5 * (f.q3 - f.q1) then 'выше верхней границы'
    when a.events_14d < f.q1 - 1.5 * (f.q3 - f.q1) then 'ниже нижней границы'
    else 'внутри границ'
  end as zone,
  count(*) as users,
  round(cast(avg(a.events_14d) as numeric(18, 6)), 1) as avg_events,
  round(cast(avg(a.active_days) as numeric(18, 6)), 1) as avg_active_days,
  max(a.busiest_day) as max_events_per_day
from activity as a
join fences as f on f.channel = a.channel
group by 1
order by avg_events desc;
-- выше верхней границы    36  10.7  7.9  3
-- внутри границ         3622   5.6  4.4  3
-- ниже нижней границы 3 1.0 1.0 1- Не удалять по порогу: сначала посмотреть строки, потом решать.
- Проверить источник: дубли, тестовые аккаунты, боты, повторная загрузка дня.
- Для среднего и тестов — ограничение сверху или логарифм, правило записать заранее.
- Интересные крайние значения — в отдельный сегмент.
- В отчёте назвать правило, порог и число затронутых строк.
Почему ящик в pandas, R и Excel получается разным
Квантиль выборки можно определить несколькими способами. Хайндман и Фан в 1996 году насчитали девять распространённых в статистических пакетах; numpy поддерживает все девять через параметр method. На тысяче пользователей разница исчезает: у всех четырёх каналов выше любой способ даёт те же Q1 и Q3. На маленькой группе она меняет выводы.
Возьмём 20 пользователей organic, зарегистрированных в пятницу, 19 июня. pandas, numpy и matplotlib интерполируют между соседними значениями и находят Q3 = 7,25: три пользователя с четырьмя событиями — нижние выбросы. percentile_disc берёт реальное значение, Q3 = 7, ящик уже, и в выбросы попадает ещё и пользователь с девятью событиями. КВАРТИЛЬ.ИСКЛ в Excel даёт 7,75, а R строит ящик по шарнирам Тьюки — медианам половин ряда, Q3 = 7,5. В обоих случаях граница отодвигается, и выбросов нет вовсе.
Отсюда правило: сравнивая ящики из двух инструментов, сначала сверьте способ расчёта квартилей. А на группах из нескольких десятков человек не обсуждайте отдельные точки за усами — их число зависит от библиотеки больше, чем от пользователей.
with cohort as (
  select u.user_id, count(e.event_id) as events_14d
  from users as u
  left join events as e
    on e.user_id = u.user_id
   and e.event_time < u.signup_date + interval '14 days'
  where u.signup_date = date '2026-06-19' and u.channel = 'organic'
  group by u.user_id
),
quartiles as (
  select 'percentile_cont' as method,
    percentile_cont(0.25) within group (order by events_14d) as q1,
    percentile_cont(0.75) within group (order by events_14d) as q3
  from cohort
  union all
  select 'percentile_disc',
    percentile_disc(0.25) within group (order by events_14d),
    percentile_disc(0.75) within group (order by events_14d)
  from cohort
)
select q.method, q.q1, q.q3,
  q.q1 - 1.5 * (q.q3 - q.q1) as lower_fence,
  q.q3 + 1.5 * (q.q3 - q.q1) as upper_fence,
  count(*) filter (where c.events_14d < q.q1 - 1.5 * (q.q3 - q.q1)
                      or c.events_14d > q.q3 + 1.5 * (q.q3 - q.q1)) as outliers
from quartiles as q
cross join cohort as c
group by q.method, q.q1, q.q3
order by q.method;
-- percentile_cont  6  7.25  4.125  9.125  3
-- percentile_disc 6 7 4.5 8.5 4import numpy as np
import pandas as pd
from matplotlib.cbook import boxplot_stats
# 20 пользователей organic с регистрацией 19 июня: события за первые 14 дней
x = np.array([4, 4, 4, 5, 6, 6, 6, 6, 6, 6, 7, 7, 7, 7, 7, 8, 8, 8, 8, 9])
def report(name, q1, q3):
step = 1.5 * (q3 - q1)
flagged = x[(x < q1 - step) | (x > q3 + step)]
print(f"{name:<24} Q1={q1:<4g} Q3={q3:<5g} границы {q1 - step:g}…{q3 + step:g} выбросы: {flagged.tolist()}")
q1, q3 = pd.Series(x).quantile([0.25, 0.75]) # как percentile_cont
report("pandas, numpy", q1, q3)
report("percentile_disc", *np.percentile(x, [25, 75], method="inverted_cdf"))
report("КВАРТИЛЬ.ИСКЛ", *np.percentile(x, [25, 75], method="weibull"))
s = np.sort(x)
half = (len(s) + 1) // 2 # шарниры Тьюки: медианы половин
report("R, boxplot()", np.median(s[:half]), np.median(s[-half:]))
print("matplotlib рисует точками:", boxplot_stats(x)[0]["fliers"].tolist())
# pandas, numpy Q1=6 Q3=7.25 границы 4.125…9.125 выбросы: [4, 4, 4]
# percentile_disc Q1=6 Q3=7 границы 4.5…8.5 выбросы: [4, 4, 4, 9]
# КВАРТИЛЬ.ИСКЛ Q1=6 Q3=7.75 границы 3.375…10.375 выбросы: []
# R, boxplot() Q1=6 Q3=7.5 границы 3.75…9.75 выбросы: []
# matplotlib рисует точками: [4, 4, 4]Когда ящик ломается: нули и редкие покупки
Выручка на пользователя — типичная продуктовая метрика, на которой ящик с усами бесполезен. В канале organic 1 747 пользователей, платили 410 из них, 23,5%. Меньше четверти — значит, и Q1, и медиана, и Q3 равны нулю. Ящик схлопывается в линию, а каждый платящий, даже с минимальной оплатой в 19 долларов, оказывается «выбросом»: 410 точек.
В referral платят 278 из 1 037, 26,8%. Это чуть больше четверти, и Q3 сдвигается на 19. Ящик появляется, ус доходит до 39, за ним остаются 46 человек. Между каналами разница в три процентных пункта доли платящих, а на картинке — совершенно разные фигуры.
Параметр autorange=True в matplotlib прячет точки, растягивая усы от минимума до максимума. Это лечит рисунок, но не метрику. Правильнее разделить вопрос надвое: доля платящих — отдельным числом, сумма на платящего — отдельным ящиком или гистограммой. Так же поступают с длительностью сессии, где много нулевых визитов, и с любым счётчиком, который у большинства равен нулю.
import numpy as np
from matplotlib.cbook import boxplot_stats

# Выручка на пользователя канала organic за всё время: сумма → число пользователей
dist = {0: 1337, 19: 153, 29: 91, 38: 55, 39: 32, 57: 11, 58: 46, 78: 11, 87: 7, 117: 4}
revenue = np.repeat(list(dist), list(dist.values()))

for autorange in (False, True):
    st = boxplot_stats(revenue, autorange=autorange)[0]
    print(f"autorange={autorange}: Q1={st['q1']:g}, медиана={st['med']:g}, Q3={st['q3']:g}, "
          f"усы {st['whislo']:g}–{st['whishi']:g}, точек за усами: {len(st['fliers'])}")
# autorange=False: Q1=0, медиана=0, Q3=0, усы 0–0, точек за усами: 410
# autorange=True: Q1=0, медиана=0, Q3=0, усы 0–117, точек за усами: 0Одинаковые ящики — разные распределения
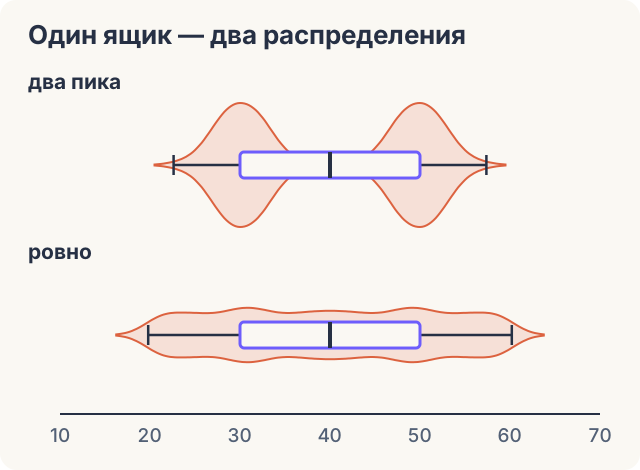
Ящик описывает данные пятью числами, и всё, что между ними, теряется. Самая неприятная потеря — форма. Сгенерируем две синтетические выборки по 401 значению с фиксированным зерном генератора. Первая состоит из двух горбов, вторая разложена ровно. Половины выборок отражены зеркально, а масштаб подобран так, что у обеих Q1 = 30, медиана 40 и Q3 = 50 точно.
Ящики совпадают, усы почти совпадают: 23–57 и 20–60. По гистограмме это разные миры. У первой выборки возле медианы, от 35 до 45, всего 15 значений из 401, у второй — 95. Медиана «двугорбой» выборки описывает значение, которого почти ни у кого нет.
В продукте два горба — обычное дело: смесь двух сегментов, двух тарифов, новых и старых пользователей. Ящик с усами смешает их в один аккуратный прямоугольник. Поэтому перед тем как сравнивать группы ящиками, хотя бы раз посмотрите на гистограмму каждой.
Вторая потеря — размер группы. Ящик по 20 пользователям выглядит так же солидно, как по 1 430. Есть три средства: подписывать n рядом с названием группы, как на рисунке по каналам; делать ширину ящика пропорциональной корню из n — так предложили Макгилл, Тьюки и Ларсен в 1978 году; при небольших группах накладывать на ящик сами точки.
import numpy as np
from matplotlib.cbook import boxplot_stats

rng = np.random.default_rng(2026)
halves = {                                     # по 200 положительных значений
    "два пика": np.abs(rng.normal(2, 0.5, 200)),
    "ровно": rng.uniform(0, 1, 200),
}
for name, h in halves.items():
    x = np.concatenate([-h, [0], h])           # зеркально: 401 значение, медиана ровно 0
    y = 40 + 10 * x / np.percentile(x, 75)     # сдвиг и масштаб: Q1 = 30, медиана 40, Q3 = 50
    st = boxplot_stats(y)[0]
    counts, _ = np.histogram(y, bins=range(15, 70, 5))
    print(f"{name}: Q1={st['q1']:g}, медиана={st['med']:g}, Q3={st['q3']:g}, "
          f"усы {st['whislo']:.0f}–{st['whishi']:.0f}, точек за усами: {len(st['fliers'])}")
    print("  гистограмма, шаг 5 от 15 до 65:", counts.tolist())
# два пика: Q1=30, медиана=40, Q3=50, усы 23–57, точек за усами: 0
#   гистограмма, шаг 5 от 15 до 65: [0, 6, 94, 93, 7, 8, 92, 95, 6, 0]
# ровно: Q1=30, медиана=40, Q3=50, усы 20–60, точек за усами: 0
#   гистограмма, шаг 5 от 15 до 65: [4, 47, 49, 53, 47, 48, 52, 50, 47, 4]
Ящик, гистограмма или violin: что выбрать
Ящик с усами силён в сравнении: десять групп на одной оси читаются за секунды, и положение медиан и ящиков видно сразу. Гистограмма показывает форму одного распределения — пики, нули, обрывы, — но десять гистограмм рядом уже не сравнить. Violin plot (Хинтце и Нельсон, 1998) — компромисс: вокруг ящика рисуют сглаженную плотность, отражённую зеркально.
У violin своя цена. Сглаживание рисует плотность там, где данных нет: между целыми значениями счётчика, ниже нуля у неотрицательной величины. Ширина сглаживания меняет картинку так же, как ширина корзин меняет гистограмму. Поэтому для отчёта руководителю часто хватает ящиков с подписанным n, а форму вы проверяете сами, перед тем как ящики рисовать.
| Задача | График | На что смотреть |
|---|---|---|
| Сравнить несколько групп по центру и разбросу | ящики с усами на одной оси | n каждой группы, одинаковые правила усов |
| Увидеть форму одной величины: пики, нули, хвост | гистограмма | ширина корзин, доля нулей |
| Сравнить форму нескольких групп | violin или гистограммы друг под другом | сглаживание за пределами реальных значений |
| Группа из нескольких десятков наблюдений | сами точки поверх ящика | выбросы зависят от способа квартилей |
| Передать числа в отчёт | таблица пяти чисел и n | метод квартилей и окно данных |
Частые вопросы
Что показывает ящик с усами?
Медиану, первый и третий квартили, межквартильный размах как длину ящика, усы до последних значений внутри границ 1,5·IQR и отдельные точки за ними. По сути это рисунок пятичисловой сводки.
Как найти выбросы по межквартильному размаху?
Посчитайте Q1 и Q3, их разность IQR и границы Q1 − 1,5·IQR и Q3 + 1,5·IQR. Всё, что за границами, — кандидаты. Для канала organic это 2 и 10 событий за 14 дней: за ними 23 пользователя из 1 430.
Почему усы у ящика разной длины?
Усы отражают асимметрию. Если правый ус длиннее левого, у распределения хвост вправо: большие значения встречаются, а маленьких ограничивает ноль.
Чем boxplot отличается от гистограммы?
Гистограмма показывает форму распределения целиком, ящик — пять чисел. Ящик удобнее для сравнения групп, гистограмма — для поиска пиков, нулей и обрывов.
Можно ли удалять выбросы, которые показал boxplot?
Только после проверки строк и с записанным правилом. В продуктовых данных за усами обычно реальные активные пользователи, и их удаление занижает метрику.
Итог
Ящик с усами отвечает на вопрос «где середина и насколько широко» сразу для нескольких групп. Правило 1,5·IQR отбирает строки для проверки, а не для удаления, и меряет каждую группу её собственной линейкой. Перед выводами сверьте способ расчёта квартилей и n, а форму распределения проверьте гистограммой. Запросы из статьи можно повторить в песочнице Симулятора SQL-аналитика на той же базе «Маяк».
Материалы по теме
Размах в статистике: что это, как найти и чем он обманывает
Размах — разность между наибольшим и наименьшим значением ряда. Формула, пример на семи числах, SQL и Python, межквартильный размах и ловушки: выброс, тренд, объём выборки.
Z-оценка (z-score, z-показатель): формула, пример и выбросы
Z-оценка (z-score) показывает, на сколько стандартных отклонений значение отстоит от среднего. Формула, расчёт вручную и в SQL, процентиль, поиск аномалий.
Перцентиль, квантиль и квартиль: что это и как посчитать
Перцентиль — значение, ниже которого лежит заданная доля наблюдений. Чем он отличается от квантиля и квартиля, что значат P50, P90, P99 и как его считать.