Распределение Стьюдента (t-распределение): таблица и степени свободы
Распределение Стьюдента (t-распределение) простыми словами: формула t, степени свободы, таблица критических значений, коэффициент Стьюдента, интервал в Python, Excel и SQL.
Содержание статьи
Распределение Стьюдента (t-распределение) — это распределение величины t = (x̄ − μ) / (s / √n) для n независимых наблюдений из нормального распределения: отклонения выборочного среднего x̄ от истинного μ, измеренного в оценённых стандартных ошибках s / √n, когда разброс s посчитан по той же выборке, а не известен заранее. Оно похоже на нормальное, но хвосты у него тяжелее; форму задаёт число степеней свободы df = n − 1, и при больших df кривая почти совпадает с нормальной. Аналитику оно нужно, когда наблюдений мало — семь дней выручки, тринадцать плательщиков в сегменте — и множитель 1,96 делает доверительный интервал уже, чем следует. Ниже — откуда берётся поправка, таблица критических значений, расчёт на учебной базе симулятора SQL-аналитика и случаи, когда t-распределение не помогает.
Что такое распределение Стьюдента простыми словами
Стандартная ошибка — типичная величина, на которую среднее по выборке отличается от истинного; она равна σ / √n. Если σ известно, у нормальных данных отношение (x̄ − μ) / (σ / √n) распределено нормально, и 95% его значений лежат в пределах ±1,96. На практике σ неизвестно, вместо него подставляют выборочное стандартное отклонение s, а оно само случайно: в одной выборке вышло больше, в другой меньше. Отношение с оценённым знаменателем разбросано шире нормального. Его распределение и называют распределением Стьюдента.
Пример, который можно пересчитать руками. Выручка за семь дней 17–23 августа в учебной базе: 567, 316, 558, 442, 691, 771 и 548 долларов. Среднее — 556,1, выборочное стандартное отклонение — 150,1, стандартная ошибка — 150,1 / √7 = 56,7. Допустим, план — 450 долларов в день, и нужно понять, совместима ли с ним неделя. Подставляем μ = 450: t = (556,1 − 450) / 56,7 = 1,87. Неделя выше плана на 1,87 оценённой стандартной ошибки.
Много это или мало, решает распределение. Если истинный уровень — 450, то по нормальному распределению отклонение такого размера в любую сторону случается в 6,1% случаев, по распределению Стьюдента с шестью степенями свободы — в 11,1%. Первое число — «почти значимо», второе — нет: недооценка почти вдвое. При пороге 5% семи дней мало, чтобы утверждать, что уровень выручки отличается от 450. Можно ли считать дни подряд независимыми — отдельный вопрос, к нему вернёмся ниже.
t = (x̄ − μ) / (s / √n), df = n − 1x̄ — среднее выборки, μ — истинное среднее, s — выборочное стандартное отклонение с делителем n − 1, n — число наблюдений, df — число степеней свободы.
Зачем оно нужно, если есть нормальное распределение
Чего стоит замена σ на s, проще всего увидеть в симуляции. Берём нормальное распределение с известными μ = 100 и σ = 15, достаём 200 000 выборок по n наблюдений и в каждой считаем t по формуле выше — с s вместо σ.
При n = 5 оценка s в 90% выборок лежит между 0,42σ и 1,54σ: знаменатель бывает занижен в два с лишним раза и завышен в полтора. В итоге |t| превышает 1,96 в 12,13% выборок вместо 5%. Интервал «среднее ± 1,96 стандартной ошибки», заявленный как 95-процентный, промахивается в два с лишним раза чаще обещанного. Стоит заменить 1,96 критическим значением Стьюдента — границей, за которую |t| выходит в 5% случаев, — 2,776, и доля промахов возвращается к 5,00%.
При n = 30 оценка s держится между 0,78σ и 1,21σ, и разница почти исчезает: 6,00% для границы 1,96 и 4,99% для 2,045. Распределение Стьюдента раздвигает границы ровно настолько, чтобы покрыть неопределённость в s.
import numpy as np
from scipy import stats

rng = np.random.default_rng(42)
mu, sigma = 100, 15                       # истинные параметры знает только симуляция
for n in (5, 30):
    x = rng.normal(mu, sigma, size=(200_000, n))
    s = x.std(axis=1, ddof=1)             # σ оценена по той же выборке
    t = (x.mean(axis=1) - mu) / (s / np.sqrt(n))
    crit = stats.t.ppf(0.975, df=n - 1)   # критическое значение Стьюдента
    lo, hi = np.percentile(s / sigma, [5, 95])
    print(f"n={n}: s/σ в 90% выборок от {lo:.2f} до {hi:.2f}; "
          f"|t| > 1.96 — {np.mean(np.abs(t) > 1.96):.2%}; "
          f"|t| > {crit:.3f} — {np.mean(np.abs(t) > crit):.2%}")
# n=5: s/σ в 90% выборок от 0.42 до 1.54; |t| > 1.96 — 12.13%; |t| > 2.776 — 5.00%
# n=30: s/σ в 90% выборок от 0.78 до 1.21; |t| > 1.96 — 6.00%; |t| > 2.045 — 4.99%
Как выглядит t-распределение и что такое тяжёлые хвосты
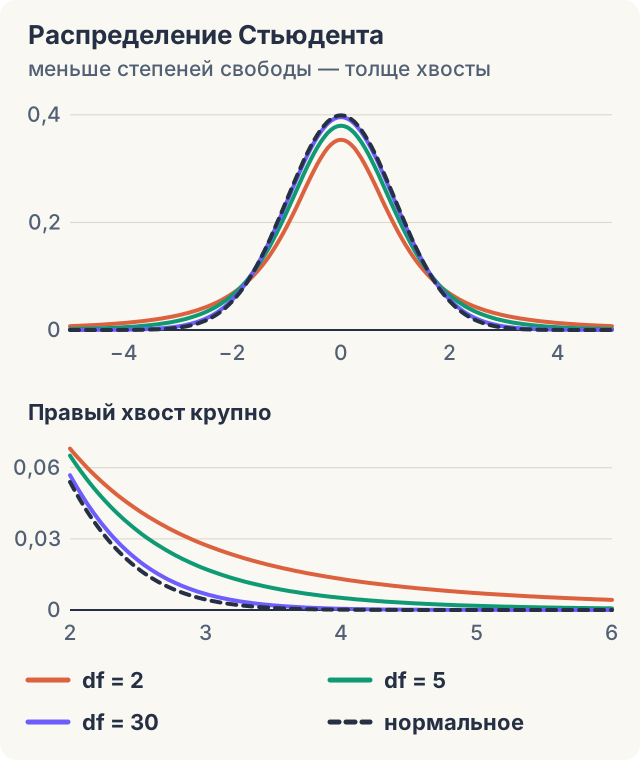
Кривая симметрична, центр в нуле, как у стандартного нормального распределения. Отличается то, как распределена площадь: пик ниже, хвосты толще. При df = 2 высота пика 0,354 против 0,399 у нормального, при df = 5 — 0,380, при df = 30 — 0,396, и на глаз кривые уже сливаются.
Хвосты важнее пика: по ним считают интервалы и p-value — вероятность получить такое же или большее отклонение при верной нулевой гипотезе. За пределами ±3 у нормального распределения лежит 0,27% площади, при df = 30 — 0,54%, при df = 5 — 3,01%, при df = 2 — 9,55%, в 35 раз больше нормального. Поэтому |t| больше 3 по трём наблюдениям встречается почти в каждой десятой выборке, а по тысяче — редкость.
Что такое степени свободы и почему их n − 1
Степени свободы — число независимых отклонений, из которых собрана оценка разброса. Из n отклонений от выборочного среднего свободны n − 1: в сумме они дают ноль. Для t это значит: чем меньше свободных отклонений, тем сильнее s гуляет от выборки к выборке — при df = 4 от 0,42σ до 1,54σ. У недели из семи дней df = 6, у сегмента из 13 человек — 12.
Чем меньше df, тем хуже известен разброс и тем шире распределение. При df = 1, то есть по двум наблюдениям, критическое значение для 95% равно 12,706: интервал получается таким широким, что почти ничего не сообщает.
Когда сравнивают две независимые выборки с общей оценкой дисперсии, на два средних уходят две степени: df = n₁ + n₂ − 2. Если дисперсии групп не считают равными, применяют поправку Уэлча: число степеней свободы вычисляется по отдельной формуле и получается дробным. В примере из статьи о критерии Стьюдента группы из 10 и 12 человек дают 18,06 вместо 20.
Таблица Стьюдента: как найти критическое значение
Критическое значение t — граница, за которую |t| выходит с заданной вероятностью α. Для двустороннего интервала с доверием 95% берут α = 0,05, для 99% — α = 0,01. Таблица посчитана функцией scipy.stats.t.ppf; последняя строка — нормальное распределение.
Пользоваться так: посчитайте df = n − 1, найдите строку, возьмите число из столбца нужного уровня и умножьте на стандартную ошибку — получится полуширина интервала. Если строки с вашим df нет, берите ближайшую с меньшим df: интервал выйдет чуть шире нужного, но не уже. Проверьте шапку: если уровень задан для одного хвоста, столбец «0,05» соответствует доверию 90%.
«Коэффициент Стьюдента» из лабораторных работ — то же критическое значение: погрешность среднего по серии измерений считают как t · s / √n. Так записано и в ГОСТ Р 8.736-2011 о прямых многократных измерениях: доверительные границы случайной погрешности — произведение коэффициента Стьюдента на среднее квадратическое отклонение среднего арифметического, то есть на ту же s / √n (п. 7.5), таблица Д.1 построена по n − 1, а метод относится к результатам с нормальным распределением (п. 7.1). Смотрите, что стоит в первом столбце вашей таблицы, n или n − 1: при пяти измерениях нужна строка df = 4, то есть 2,776.
| Степени свободы | Доверие 95%, α = 0,05 | Доверие 99%, α = 0,01 | Интервал 95% шире, чем с 1,96 |
|---|---|---|---|
| 1 | 12,706 | 63,657 | на 548% |
| 2 | 4,303 | 9,925 | на 120% |
| 5 | 2,571 | 4,032 | на 31,2% |
| 6 | 2,447 | 3,707 | на 24,8% |
| 10 | 2,228 | 3,169 | на 13,7% |
| 12 | 2,179 | 3,055 | на 11,2% |
| 20 | 2,086 | 2,845 | на 6,4% |
| 30 | 2,042 | 2,750 | на 4,2% |
| 60 | 2,000 | 2,660 | на 2,1% |
| 120 | 1,980 | 2,617 | на 1,0% |
| ∞ (нормальное) | 1,960 | 2,576 | — |
Как построить доверительный интервал по t на учебной базе
Интервал для среднего — x̄ ± t · s / √n, где t берётся для df = n − 1. Запрос готовит всё, кроме t, для трёх выборок: дневная выручка за неделю 17–23 августа, выручка на плательщика тарифа team из Армении и выручка на плательщика по всей базе. Критическое значение подставьте из таблицы: в PostgreSQL и DuckDB функции для квантилей распределения Стьюдента (значений, ниже которых лежит заданная доля распределения) нет.
На неделе интервал с множителем 1,96 идёт от 444,9 до 667,4 доллара, а с 2,447 — от 417,3 до 695,0: на 24,8% шире. В сегменте из 13 человек разница 11,2%. Оговорка: в сегменте всего два значения, 39 и 78, так что его среднее — доля оплативших дважды (4 из 13) в других единицах. Интервал Уилсона для неё даёт 43,9–61,5 доллара; t-интервал здесь показывает механику расчёта, а не лучший метод. На 912 плательщиках критическое значение равно 1,963 — на 0,13% больше, чем 1,96, — и интервалы совпадают до десятых: 32,4–34,7.
Деталь переносимости. CAST(x AS numeric) без точности DuckDB понимает как три знака после запятой: 18,734994 превращается в 18,735, и ROUND(..., 2) возвращает 18,74, тогда как PostgreSQL даёт 18,73. Поэтому в запросе точность указана явно.
| Выборка | n | Среднее | С множителем 1,96 | t для df = n − 1 | По Стьюденту |
|---|---|---|---|---|---|
| Выручка за день, 17–23 августа | 7 | 556,1 | 444,9–667,4 | 2,447 | 417,3–695,0 |
| Плательщики: Армения, team | 13 | 51,0 | 40,8–61,2 | 2,179 | 39,7–62,3 |
| Все плательщики | 912 | 33,6 | 32,4–34,7 | 1,963 | 32,4–34,7 |
WITH week AS (
  SELECT paid_at, SUM(amount) AS x
  FROM payments
  WHERE paid_at >= DATE '2026-08-17' AND paid_at < DATE '2026-08-24'
  GROUP BY paid_at
),
payer AS (
  SELECT p.user_id, u.country, MIN(p.plan) AS plan, SUM(p.amount) AS x
  FROM payments p
  JOIN users u ON u.user_id = p.user_id
  GROUP BY p.user_id, u.country
),
samples AS (
  SELECT 1 AS ord, 'выручка за день, 17–23 августа' AS sample, x FROM week
  UNION ALL
  SELECT 2, 'выручка на плательщика: Армения, team', x FROM payer
  WHERE country = 'AM' AND plan = 'team'
  UNION ALL
  SELECT 3, 'выручка на плательщика: все', x FROM payer
)
SELECT
  sample,
  COUNT(*) AS n,
  COUNT(*) - 1 AS df,
  ROUND(AVG(x), 2) AS mean,
  ROUND(CAST(STDDEV_SAMP(x) AS NUMERIC(18, 6)), 2) AS sd,
  ROUND(CAST(STDDEV_SAMP(x) / SQRT(COUNT(*)) AS NUMERIC(18, 6)), 3) AS se
FROM samples
GROUP BY ord, sample
ORDER BY ord;
-- 7 | 6 | 556.14 | 150.13 | 56.744
-- 13 | 12 | 51.00 | 18.73 | 5.196
-- 912 | 911 | 33.60 | 17.74 | 0.587Как посчитать в Python и Excel
В SciPy всё нужное — методы scipy.stats.t: ppf возвращает квантиль, то есть критическое значение, cdf — долю значений ниже t, sf — долю выше, interval — готовые границы. Число степеней свободы идёт вторым аргументом.
Частая ошибка — перепутать хвосты. Для двустороннего интервала 95% в ppf передают 0,975. С 0,95 получится 1,943 вместо 2,447 и интервал 445,9–666,4, фактически 90-процентный.
В Excel та же ловушка зашита в названиях. СТЬЮДЕНТ.ОБР.2Х — двусторонняя, в неё передают α = 0,05. СТЬЮДЕНТ.ОБР — левосторонняя: от 0,975 она вернёт 2,447, а от 0,05 — минус 1,943. ДОВЕРИТ.СТЬЮДЕНТ сразу возвращает полуширину интервала. СТЬЮДЕНТ.РАСП.2Х не принимает отрицательный t и возвращает #ЧИСЛО!; подставляйте ABS(t).
| Что нужно | SciPy | Excel | Результат |
|---|---|---|---|
| Критическое t для 95% | t.ppf(0.975, 6) | СТЬЮДЕНТ.ОБР.2Х(0,05; 6) | 2,447 |
| Доля значений ниже t = 1,87 | t.cdf(1.87, 6) | СТЬЮДЕНТ.РАСП(1,87; 6; ИСТИНА) | 0,945 |
| Площадь двух хвостов за ±1,87 | 2 * t.sf(1.87, 6) | СТЬЮДЕНТ.РАСП.2Х(1,87; 6) | 0,111 |
| Полуширина интервала 95% | t.ppf(0.975, 6) * se | ДОВЕРИТ.СТЬЮДЕНТ(0,05; 150,13; 7) | 138,8 |
import numpy as np
from scipy import stats

week = np.array([567, 316, 558, 442, 691, 771, 548])    # выручка 17–23 августа, $
n, df = len(week), len(week) - 1
mean, s = week.mean(), week.std(ddof=1)
se = s / np.sqrt(n)
print(round(mean, 1), round(s, 1), round(se, 1))          # 556.1 150.1 56.7

print(round(stats.t.ppf(0.975, df), 3))                   # критическое t: 2.447
print(np.round(stats.t.interval(0.95, df, loc=mean, scale=se), 1))   # [417.3 695. ]
print(np.round([mean - 1.96 * se, mean + 1.96 * se], 1))             # [444.9 667.4]

t_stat = (mean - 450) / se
print(round(t_stat, 2), round(stats.t.cdf(t_stat, df), 3))            # 1.87 0.945
print(round(2 * stats.t.sf(t_stat, df), 3), round(2 * stats.norm.sf(t_stat), 3))   # 0.111 0.061
Честен ли t-интервал на выручке: проверка пересборкой выборок
Распределение Стьюдента выведено для независимых наблюдений из нормального распределения. Выручка на плательщика скошена вправо (коэффициент асимметрии 1,77 при нуле у симметричных данных), а дни в отчёте идут подряд на растущем ряду. Цену каждого нарушения можно измерить: считаем фактические данные генеральной совокупностью, много раз достаём из неё выборки с возвращением и смотрим, как часто интервал накрывает её среднее. Эту долю называют покрытием интервала.
Выборки по 13 человек из 912 плательщиков. Интервал с 1,96 накрывает среднее 33,60 в 88,6% случаев, t-интервал — в 90,8%: лучше, но до заявленных 95% не хватает четырёх пунктов. Из 9,2% промахов 8,7 пункта — случаи, когда истинное среднее выше верхней границы. Промахи — это выборки, куда не попал ни один крупный плательщик (78 долларов и больше; таких 48 из 912) и попало мало повторных оплат. В них малы и среднее, и s (корреляция между ними 0,76), поэтому интервал узок именно там, где он занижен. К 94% покрытие подходит только при n = 100.
С днями иначе. Берём все 30 дней августа: оплаты записаны датой, и последний день в них полный. Если бы семь дней набирались независимо (с возвращением) из этих тридцати, t-интервал накрывал бы среднее месяца 526,3 в 94,7% случаев, а интервал с 1,96 — в 89,5%. Дневная выручка почти симметрична (асимметрия 0,23), и здесь поправка работает как обещано.
Но неделя — это семь дней подряд. Из 24 таких окон среднее августа накрыли 19, а интервалы четырёх последних лежат целиком выше него: выручка выросла с 467,9 в день за первые семь дней до 612,3 за последние семь. Это не оценка покрытия: соседние окна делят шесть дней из семи, и интервал с 1,96 промахивается на тех же окнах. Счёт показывает другое: почти все промахи стоят в конце месяца. Неделя описывает уровень самой недели, а не месяца: промах создаёт тренд, и поправка на малую выборку к нему отношения не имеет.
Учебная база симулятора SQL-аналитика, выручка на плательщика; 100 000 выборок с возвращением на каждый размер, numpy, зерно 42.
import numpy as np
from scipy import stats

rng = np.random.default_rng(42)

def coverage(samples, true_mean):
    n = samples.shape[1]
    se = samples.std(axis=1, ddof=1) / np.sqrt(n)
    miss = np.abs(samples.mean(axis=1) - true_mean)
    return np.mean(miss <= 1.96 * se), np.mean(miss <= stats.t.ppf(0.975, n - 1) * se)

# Выручка на плательщика: сумма → число людей, всего 912
dist = {19: 349, 29: 204, 38: 138, 39: 69, 57: 27, 58: 77, 78: 26, 87: 15, 117: 7}
payers = np.repeat(list(dist), list(dist.values())).astype(float)
for n in (7, 13, 30, 100):
    draws = payers[rng.integers(0, payers.size, size=(100_000, n))]
    z, t = coverage(draws, payers.mean())
    print(f"плательщики, n={n}: z {z:.1%}, t {t:.1%}")

# Дневная выручка 1–30 августа, $ (оплаты записаны датой, последний день полный)
aug = np.array([480, 394, 345, 597, 500, 460, 499, 452, 770, 327, 510, 470, 518, 336, 491,
                460, 567, 316, 558, 442, 691, 771, 548, 529, 660, 519, 604, 646, 607, 721.])
z, t = coverage(aug[rng.integers(0, aug.size, size=(100_000, 7))], aug.mean())
print(f"7 случайных дней: z {z:.1%}, t {t:.1%}")
windows = np.lib.stride_tricks.sliding_window_view(aug, 7)
z, t = coverage(windows, aug.mean())
print(f"7 дней подряд: t накрыл {round(t * len(windows))} окон из {len(windows)}")
# плательщики, n=7: z 84.4%, t 88.3%
# плательщики, n=13: z 88.6%, t 90.8%
# плательщики, n=30: z 91.9%, t 92.8%
# плательщики, n=100: z 94.0%, t 94.2%
# 7 случайных дней: z 89.5%, t 94.7%
# 7 дней подряд: t накрыл 19 окон из 24Когда распределение Стьюдента не спасает
Поправка закрывает одну проблему: неизвестное σ при нормальных данных. Остальные остаются.
- Сильная асимметрия на малой выборке. На 13 плательщиках t-интервал накрывает среднее в 90,8% случаев, перцентильный бутстреп (границы — 2,5-й и 97,5-й процентили средних по пересобранным выборкам) на выборках того же размера — примерно в 88%. Формулой это не чинится, нужны данные.
- Выбросы. Регистрации за пять дней 40, 70, 80, 100 и 110 дают интервал от 46 до 114. Замените 110 на 410, и он растянется от −49 до 329: нижняя граница ушла в отрицательные регистрации.
- Зависимые и неоднородные наблюдения. Дни подряд на растущем ряду, десять сессий одного пользователя, события вместо пользователей: независимых наблюдений меньше, чем строк, а df считают по строкам. В таблице
events35 341 строка на 4 613 пользователей — df по строкам завышены почти в восемь раз. - Доли. Конверсия — среднее нулей и единиц, её разброс описывает биномиальное распределение. Для двух активаций из сорока интервал с 1,96 идёт от −1,8% до 11,8%, t-интервал — от −2,1% до 12,1%: отрицательная граница осталась. Интервал Уилсона для тех же данных — от 1,4% до 16,5%.
- Большие выборки. На тысячах наблюдений выбор между t и 1,96 ничего не меняет, а смещение и зависимость остаются.
Откуда название: Госсет, Student и пивоварня Guinness
Распределение описал Уильям Сили Госсет; в Оксфорде он изучал математику и химию. С октября 1899 года он работал пивоваром в компании Guinness в Дублине — так сказано в статье о нём из Dictionary of National Biography, размещённой в архиве MacTutor Сент-Эндрюсского университета. Статья «The Probable Error of a Mean» вышла в журнале Biometrika в марте 1908 года (том 6, выпуск 1, страницы 1–25) под псевдонимом Student.
Псевдоним объясняет Эрих Леман в статье «‘Student’ and Small-Sample Theory» (Statistical Science, 1999): фирма была против обнародования работ, сделанных для неё, и публикация под чужим именем стала уступкой. Там же сказано, что Госсет изучал величину z = (x̄ − μ) / S с делителем n в оценке разброса и привёл таблицу для выборок от 4 до 10 наблюдений, а привычную форму t = z · √(n − 1) ввёл Рональд Фишер в 1925 году.
Частые вопросы
Чем t-распределение отличается от нормального? Хвосты тяжелее, пик ниже, а форма зависит от df. За пределами ±1,96 у нормального 5% площади, у Стьюдента с df = 4 — 12,2%.
Чему равен коэффициент Стьюдента при доверительной вероятности 0,95? Зависит от числа измерений: для пяти (df = 4) — 2,776, для десяти (df = 9) — 2,262, для двадцати (df = 19) — 2,093.
Когда вместо t можно брать 1,96? Когда наблюдений сотни. При df = 30 интервал по t ещё шире на 4,2%, при df = 60 — на 2,1%, при df = 120 — на 1,0%. Проще брать t всегда: на больших выборках оно само становится 1,96.
Распределение Стьюдента и критерий Стьюдента — одно и то же? Нет. Распределение — кривая, по которой переводят t в вероятность. Критерий, или t-тест, — процедура сравнения средних, которая считает t и сверяет его с этой кривой.
Нужна ли нормальность данных? Для точного результата — да. На почти симметричной дневной выручке семи случайно взятых дней хватило для покрытия 94,7% (на днях подряд мешает тренд); на выручке плательщиков с асимметрией 1,77 при 13 наблюдениях вышло 90,8%.
Чему равны среднее и дисперсия t-распределения? Среднее — ноль при df > 1, дисперсия — df / (df − 2) при df > 2: 1,67 для df = 5 и 1,07 для df = 30. При 1 < df ≤ 2 дисперсия бесконечна, а при df = 1 не определено и само среднее.
Что попробовать на учебной базе
SQL-запрос статьи можно повторить в песочнице симулятора SQL-аналитика на этой же базе. Постройте t-интервал для недели 10–16 августа: замените в запросе даты на 2026-08-10 и 2026-08-17. Должны получиться среднее 444,6, s = 79,9, стандартная ошибка 30,2 и интервал от 370,7 до 518,5. Среднее августа 526,3 в него не попадает — это одно из пяти окон, которые промахнулись.
Материалы по теме
Бутстреп в статистике: интервалы для метрик A/B-теста
Как построить процентильный бутстреп по пользователям: разница средней выручки, медиана и ARPPU на учебном A/B-тесте, код Python и ограничения метода.
Центральная предельная теорема простыми словами: зачем она аналитику
Центральная предельная теорема (ЦПТ): почему среднее скошенной метрики распределено почти нормально, как считать стандартную ошибку среднего σ/√n и почему правило «n ≥ 30» не закон. Симуляция на выручке из учебной базы.
CTR: что это, формула и как понять, хороший ли он
CTR — доля показов, после которых кликнули. Формула CTR, примеры расчёта, CTR в рекламе, поиске, рассылках и продукте, почему высокий CTR обманывает.