Сессии в SQL: как нарезать события по паузе в 30 минут
Собираем сессии пользователя в SQL: пауза через LAG, флаг начала, накопительная сумма. Пороги 15, 30 и 60 минут, дубли, край периода и тот же расчёт в pandas.
Содержание статьи
Продакт-менеджер спрашивает, сколько сессий в день у приложения авиакомпании и сколько они длятся. В журнале app_events колонки «сессия» нет: сервер записывает события по одному. Сессию собирают запросом — это события одного клиента подряд, пока пауза между ними не превысит порог. За 20–22 июля по правилу 30 минут выходит 20 635 сессий со средней длительностью 149 секунд; при пороге 60 минут — 20 169 сессий и 216 секунд. Ниже — сам приём и места, где запрос не падает, а возвращает другое число.
Короткий ответ: пауза, флаг начала, накопительная сумма
Сессия пользователя в SQL собирается в три шага. LAG(event_time) в окне по клиенту даёт время предыдущего события. Флаг is_new равен 1, если пауза больше 30 минут или предыдущего события нет. Накопительная сумма флагов в том же окне — номер сессии: он растёт на единицу на каждом начале. Дальше обычный GROUP BY по клиенту и номеру.
Флаг записан через короткую паузу: CASE WHEN пауза <= INTERVAL '30 minutes' THEN 0 ELSE 1 END. У первого события клиента LAG возвращает NULL, сравнение с NULL не истинно, и строка уходит в ELSE — получает 1. Разность двух моментов — интервал, поэтому и порог пишется интервалом. Запрос одинаково выполняется в PostgreSQL и DuckDB.
У клиента 1f327ac0cb49 10 июля три сессии: две утренние по четыре события и вечерняя из десяти, которая закончилась покупкой.
| session_no | started | events | seconds |
|---|---|---|---|
| 1 | 07:36:00 | 4 | 115 |
| 2 | 08:15:12 | 4 | 163 |
| 3 | 18:02:23 | 10 | 1 696 |
WITH ev AS (              -- 1. журнал без дублей доставки
  SELECT DISTINCT client_id, event_time, event_name
  FROM app_events
  WHERE client_id = '1f327ac0cb49'
), marked AS (            -- 2. флаг: пауза больше 30 минут или первое событие
  SELECT client_id, event_time,
    CASE WHEN event_time - LAG(event_time) OVER (PARTITION BY client_id ORDER BY event_time)
              <= INTERVAL '30 minutes' THEN 0 ELSE 1 END AS is_new
  FROM ev
), numbered AS (          -- 3. накопительная сумма флагов = номер сессии
  SELECT client_id, event_time,
    SUM(is_new) OVER (PARTITION BY client_id ORDER BY event_time) AS session_no
  FROM marked
)
SELECT session_no, MIN(event_time) AS started, COUNT(*) AS events,
  EXTRACT(EPOCH FROM MAX(event_time) - MIN(event_time)) AS seconds
FROM numbered
GROUP BY client_id, session_no
ORDER BY session_no;
Как флаг и номер ложатся на события одного клиента
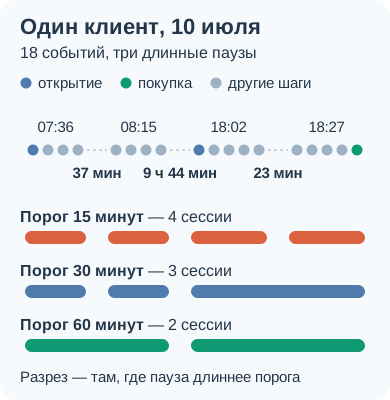
У клиента 18 событий за день. Оставим первое и те, перед которыми пауза была дольше пяти минут. Условие стоит во внешнем запросе: WHERE рядом с оконной функцией срабатывает раньше неё, и LAG увидел бы только отобранные строки — это разобрано в статье о LAG и LEAD.
В 08:15 клиент вернулся через 37 минут и сразу выбрал тариф: флаг 1, сессия 2. В 18:02 — новый заход почти через десять часов. В 18:27 пауза была 23 минуты: флаг 0, номер остался 3. На схеме те же 18 событий при трёх порогах: при 15 минутах сессий четыре, при 30 — три, при 60 — две.
| event_time | event_name | pause_minutes | is_new | session_no |
|---|---|---|---|---|
| 07:36:00 | app_open | NULL | 1 | 1 |
| 08:15:12 | select_fare | 37,3 | 1 | 2 |
| 18:02:23 | app_open | 584,5 | 1 | 3 |
| 18:27:04 | select_fare | 23,3 | 0 | 3 |
WITH ev AS (
  SELECT DISTINCT client_id, event_time, event_name
  FROM app_events
  WHERE client_id = '1f327ac0cb49'
), gaps AS (
  SELECT client_id, event_time, event_name,
    event_time - LAG(event_time) OVER (PARTITION BY client_id ORDER BY event_time) AS gap
  FROM ev
), marked AS (
  SELECT client_id, event_time, event_name, gap,
    CASE WHEN gap <= INTERVAL '30 minutes' THEN 0 ELSE 1 END AS is_new
  FROM gaps
), numbered AS (
  SELECT event_time, event_name, gap, is_new,
    SUM(is_new) OVER (PARTITION BY client_id ORDER BY event_time) AS session_no
  FROM marked
)
SELECT event_time, event_name,
  ROUND(EXTRACT(EPOCH FROM gap) / 60, 1) AS pause_minutes, is_new, session_no
FROM numbered
WHERE is_new = 1 OR gap > INTERVAL '5 minutes'   -- фильтр после окон
ORDER BY event_time;
Сессии за три дня: число, глубина и длительность
Теперь весь поток за 20–22 июля. Глубина сессии — число её событий, длительность — разность последнего и первого; EXTRACT(EPOCH FROM …) переводит интервал в секунды. PARTITION BY client_id нужен в обоих окнах, а в группировке — пара «клиент и номер»: номер сессии уникален только внутри клиента.
События взяты с запасом в сутки с каждой стороны, а период отбирается по началу сессии — зачем, показано в разделе про край периода. Всего 20 635 сессий у 14 057 клиентов, в среднем 5,02 события и 149 секунд. 3 966 сессий (19,2%) состоят из одного события и длятся ноль секунд: открыл и закрыл. Это не ошибка расчёта, но в отчёте стоит сказать, входят ли они в среднюю.
| День | Сессий | Событий в сессии | Длительность, с | Из одного события |
|---|---|---|---|---|
| 20 июля | 6 869 | 5,01 | 151 | 1 296 |
| 21 июля | 6 870 | 5,03 | 146 | 1 328 |
| 22 июля | 6 896 | 5,01 | 149 | 1 342 |
WITH ev AS (              -- события с запасом в сутки по краям периода
  SELECT DISTINCT client_id, event_time, event_name
  FROM app_events
  WHERE event_time >= TIMESTAMP '2026-07-19'
    AND event_time <  TIMESTAMP '2026-07-24'
), marked AS (
  SELECT client_id, event_time,
    CASE WHEN event_time - LAG(event_time) OVER (PARTITION BY client_id ORDER BY event_time)
              <= INTERVAL '30 minutes' THEN 0 ELSE 1 END AS is_new
  FROM ev
), numbered AS (
  SELECT client_id, event_time,
    SUM(is_new) OVER (PARTITION BY client_id ORDER BY event_time) AS session_no
  FROM marked
), sess AS (              -- одна строка — одна сессия
  SELECT client_id, session_no, MIN(event_time) AS started, COUNT(*) AS events,
    EXTRACT(EPOCH FROM MAX(event_time) - MIN(event_time)) AS seconds
  FROM numbered
  GROUP BY client_id, session_no
)
SELECT CAST(started AS DATE) AS day, COUNT(*) AS sessions,
  ROUND(AVG(events), 2) AS avg_events, ROUND(AVG(seconds)) AS avg_seconds,
  COUNT(*) FILTER (WHERE events = 1) AS single_event
FROM sess
WHERE started >= TIMESTAMP '2026-07-20'   -- период — по началу сессии
  AND started <  TIMESTAMP '2026-07-23'
GROUP BY CAST(started AS DATE)
ORDER BY day;
Порог 15, 30 или 60 минут — договорённость, а не закон
Тридцать минут — привычное значение: такой тайм-аут по умолчанию стоит в Google Analytics и в Яндекс Метрике, и в обеих системах его можно изменить. Насколько ответ зависит от порога, показывает один запрос: паузы считаются один раз, затем каждая строка размножается на три порога, и нарезка идёт отдельно внутри каждого.
Число сессий почти не двигается: 20 774, 20 635 и 20 169 — разброс меньше 3%. Средняя длительность чувствительнее: 140, 149 и 216 секунд. При пороге 60 минут внутрь сессий попадают паузы до часа, и средняя вырастает на 45%. Медиана стоит на месте — 72, 72 и 71 секунда: склеенных сессий мало, но каждая добавляет в сумму десятки минут.
Поэтому рядом с метрикой «средняя длительность сессии» пишут порог, а цифры из систем с разными порогами не сравнивают.
| Порог паузы | Сессий | Средняя длительность, с | Медиана, с |
|---|---|---|---|
| 15 минут | 20 774 | 140 | 72 |
| 30 минут | 20 635 | 149 | 72 |
| 60 минут | 20 169 | 216 | 71 |
От 30 к 60 минутам сессий становится меньше на 2,3%, а средняя длительность растёт на 45%.
WITH ev AS (
  SELECT DISTINCT client_id, event_time, event_name
  FROM app_events
  WHERE event_time >= TIMESTAMP '2026-07-19'
    AND event_time <  TIMESTAMP '2026-07-24'
), gaps AS (              -- пауза считается один раз
  SELECT client_id, event_time,
    event_time - LAG(event_time) OVER (PARTITION BY client_id ORDER BY event_time) AS gap
  FROM ev
), thresholds AS (
  SELECT 15 AS threshold_min UNION ALL SELECT 30 UNION ALL SELECT 60
), marked AS (            -- каждая строка — в трёх копиях, по одной на порог
  SELECT t.threshold_min, g.client_id, g.event_time,
    CASE WHEN g.gap <= t.threshold_min * INTERVAL '1 minute' THEN 0 ELSE 1 END AS is_new
  FROM gaps AS g
  CROSS JOIN thresholds AS t
), numbered AS (
  SELECT threshold_min, client_id, event_time,
    SUM(is_new) OVER (PARTITION BY threshold_min, client_id ORDER BY event_time) AS session_no
  FROM marked
), sess AS (
  SELECT threshold_min, client_id, session_no, MIN(event_time) AS started,
    EXTRACT(EPOCH FROM MAX(event_time) - MIN(event_time)) AS seconds
  FROM numbered
  GROUP BY threshold_min, client_id, session_no
)
SELECT threshold_min, COUNT(*) AS sessions, ROUND(AVG(seconds)) AS avg_seconds,
  percentile_cont(0.5) WITHIN GROUP (ORDER BY seconds) AS median_seconds
FROM sess
WHERE started >= TIMESTAMP '2026-07-20'
  AND started <  TIMESTAMP '2026-07-23'
GROUP BY threshold_min
ORDER BY threshold_min;
Пауза дольше получаса внутри визита: одна сессия становится двумя
Посмотрим на сами паузы перед событиями этих трёх дней. Почти все короче пяти минут. От 5 до 30 минут — 273 паузы, и все перед select_fare: человек нашёл рейс, отвлёкся и вернулся выбирать тариф. Так устроена учебная база; в рабочих данных картина размытее, но вопрос тот же.
В диапазоне 30–60 минут 466 пауз. 375 — перед app_open или push_open: это новый заход. Ещё 91 — снова перед select_fare: тот же визит, только человек отвлёкся на 32–56 минут. Правило 30 минут делит его на две сессии: первая обрывается на просмотре предложений, вторая начинается с середины воронки.
Порог 60 минут склеит эти 91 визит обратно, но заодно соединит 375 пар отдельных заходов. Порог 15 минут разрежет ещё 139 визитов. Сессия, которая начинается не с открытия, — повод проверить, не разрезан ли визит.
| Пауза перед событием | Событий | Перед select_fare | Перед открытием |
|---|---|---|---|
| до 1 минуты | 74 306 | 7 550 | 1 820 |
| 1–5 минут | 8 311 | 30 | 0 |
| 5–15 минут | 134 | 134 | 0 |
| 15–30 минут | 139 | 139 | 0 |
| 30–60 минут | 466 | 91 | 375 |
| больше часа или нет предыдущего | 20 169 | 0 | 20 169 |
WITH ev AS (
  SELECT DISTINCT client_id, event_time, event_name
  FROM app_events
  WHERE event_time >= TIMESTAMP '2026-07-19'
    AND event_time <  TIMESTAMP '2026-07-24'
), gaps AS (
  SELECT event_time, event_name,
    event_time - LAG(event_time) OVER (PARTITION BY client_id ORDER BY event_time) AS gap
  FROM ev
)
SELECT
  CASE WHEN gap <= INTERVAL '1 minute'   THEN '1. до 1 минуты'
       WHEN gap <= INTERVAL '5 minutes'  THEN '2. 1–5 минут'
       WHEN gap <= INTERVAL '15 minutes' THEN '3. 5–15 минут'
       WHEN gap <= INTERVAL '30 minutes' THEN '4. 15–30 минут'
       WHEN gap <= INTERVAL '60 minutes' THEN '5. 30–60 минут'
       ELSE '6. больше часа или нет предыдущего' END AS pause_bucket,
  COUNT(*) AS events,
  COUNT(*) FILTER (WHERE event_name = 'select_fare') AS before_select_fare,
  COUNT(*) FILTER (WHERE event_name IN ('app_open', 'push_open')) AS before_open
FROM gaps
WHERE event_time >= TIMESTAMP '2026-07-20'
  AND event_time <  TIMESTAMP '2026-07-23'
GROUP BY 1
ORDER BY 1;
Дубли доставки: сессий столько же, глубина другая
Часть строк app_events — повторная доставка: то же событие с другим event_id и received_at. Пауза перед копией нулевая, новую сессию она не откроет, поэтому без DISTINCT сессий те же 20 635.
Меняется глубина: событий в этих сессиях 104 169 вместо 103 493, а сессий из одного события — 3 926 вместо 3 966. Сорок заходов «открыл и закрыл» выглядят сессиями из двух шагов. SELECT DISTINCT client_id, event_time, event_name убирает копии до нарезки; event_id и received_at в список не входят — ими копия и отличается. Когда повтор может быть настоящим действием, нужен ключ события: это разобрано в статье о дедупликации.
WITH src AS (
  SELECT 'как в журнале' AS variant, client_id, event_time
  FROM app_events
  WHERE event_time >= TIMESTAMP '2026-07-19'
    AND event_time <  TIMESTAMP '2026-07-24'
  UNION ALL
  SELECT 'после DISTINCT', client_id, event_time
  FROM (
    SELECT DISTINCT client_id, event_time, event_name
    FROM app_events
    WHERE event_time >= TIMESTAMP '2026-07-19'
      AND event_time <  TIMESTAMP '2026-07-24'
  ) AS d
), marked AS (
  SELECT variant, client_id, event_time,
    CASE WHEN event_time - LAG(event_time) OVER (PARTITION BY variant, client_id ORDER BY event_time)
              <= INTERVAL '30 minutes' THEN 0 ELSE 1 END AS is_new
  FROM src
), numbered AS (
  SELECT variant, client_id, event_time,
    SUM(is_new) OVER (PARTITION BY variant, client_id ORDER BY event_time) AS session_no
  FROM marked
), sess AS (
  SELECT variant, client_id, session_no, MIN(event_time) AS started, COUNT(*) AS events
  FROM numbered
  GROUP BY variant, client_id, session_no
)
SELECT variant, COUNT(*) AS sessions, SUM(events) AS events,
  COUNT(*) FILTER (WHERE events = 1) AS single_event
FROM sess
WHERE started >= TIMESTAMP '2026-07-20'
  AND started <  TIMESTAMP '2026-07-23'
GROUP BY variant
ORDER BY variant;
Край периода и начало журнала
Естественный порядок — сначала отфильтровать события 20–22 июля, потом нарезать. Он даёт 20 658 сессий, на 23 больше. Эти 23 начались вечером 19 июля и перешли через полночь: фильтр отрезал им начало, и первое событие после полуночи получило флаг новой сессии.
Ошибку выдаёт первое событие. При нарезке с запасом не с открытия начинается 91 сессия — все с select_fare после паузы. После фильтра по периоду таких 114: добавились хвосты, которые стартуют с view_offer, add_passenger, payment_submit и других шагов середины визита. На правом краю зеркальная потеря: 13 сессий начались до полуночи 23 июля и продолжились после, фильтр обрезал бы им длительность и глубину.
Исправление — брать события шире периода и отбирать сессии по началу. Слева хватит запаса в один порог, справа — в самую длинную сессию; сутки покрывают оба. У начала журнала запаса нет: app_events начинается 1 июля, самая первая строка — view_offer в 00:00:00, и семь из восьми клиентов первой минуты появляются сразу с середины визита. Такие сессии исключают из расчёта длительности или помечают как неполные.
WITH ev AS (              -- события ровно за период: начала сессий отрезаны
  SELECT DISTINCT client_id, event_time, event_name
  FROM app_events
  WHERE event_time >= TIMESTAMP '2026-07-20'
    AND event_time <  TIMESTAMP '2026-07-23'
), marked AS (
  SELECT event_name,
    CASE WHEN event_time - LAG(event_time) OVER (PARTITION BY client_id ORDER BY event_time)
              <= INTERVAL '30 minutes' THEN 0 ELSE 1 END AS is_new
  FROM ev
)
SELECT COUNT(*) AS sessions,   -- число сессий — число флагов начала
  COUNT(*) FILTER (WHERE event_name NOT IN ('app_open', 'push_open')) AS not_from_open
FROM marked
WHERE is_new = 1;
Пять записей, которые меняют ответ без ошибки
Ни один из вариантов в таблице не падает: запрос возвращает число, просто другое. Первые две строки считает запрос ниже, остальные — замена одной строки в нарезке за три дня.
Самая коварная запись — EXTRACT(MINUTE FROM пауза) > 30. MINUTE — не длина интервала в минутах, а его минутная часть: у паузы в 2 часа 5 минут она равна 5, и новая сессия не откроется. Сессий выходит 16 317 вместо 20 635. Сравнивайте интервал с интервалом или берите EXTRACT(EPOCH FROM …).
В DuckDB есть ещё date_diff('minute', a, b): она считает пересечённые границы минут, а не прошедшие минуты. Для паузы нашего клиента в 37 минут 17 секунд она вернёт 38; полные минуты даёт date_sub — 37. На учебной базе число сессий от этого не меняется: пауз от 30 до 31 минуты в ней нет. В PostgreSQL этих функций нет.
Сортировка по event_id выглядит безобидно, но это порядок приёма сервером. За три дня 3 782 строки журнала дошли с опозданием больше 30 минут: приложение копило события без сети. Время для сессии — event_time, время на устройстве.
| Запись | Результат | Что произошло |
|---|---|---|
Флаг WHEN пауза > 30 минут THEN 1 ELSE 0, сессии — сумма флагов | 8 523 | Первое событие клиента в окне получает 0: сравнение с NULL не истинно |
EXTRACT(MINUTE FROM пауза) > 30 | 16 317 | Сравнивается минутная часть интервала, а не его длина |
SUM(is_new) OVER (ORDER BY event_time) без PARTITION BY | 86 462 | Номер общий на всех клиентов: чужие начала дробят сессию |
LAG с ORDER BY event_id | 20 537 | 127 пауз отрицательные: события пришли не по порядку |
GROUP BY session_no без client_id | 13 строк | Номера 1–13 повторяются у всех клиентов и слились |
WITH ev AS (
  SELECT DISTINCT client_id, event_time, event_name
  FROM app_events
  WHERE event_time >= TIMESTAMP '2026-07-19'
    AND event_time <  TIMESTAMP '2026-07-24'
), gaps AS (
  SELECT event_time,
    event_time - LAG(event_time) OVER (PARTITION BY client_id ORDER BY event_time) AS gap
  FROM ev
)
SELECT
  COUNT(*) FILTER (WHERE gap IS NULL OR gap > INTERVAL '30 minutes') AS correct,
  COUNT(*) FILTER (WHERE gap > INTERVAL '30 minutes') AS without_first,
  COUNT(*) FILTER (WHERE gap IS NULL OR EXTRACT(MINUTE FROM gap) > 30) AS minute_part
FROM gaps
WHERE event_time >= TIMESTAMP '2026-07-20'
AND event_time < TIMESTAMP '2026-07-23';SELECT
date_diff('minute', TIMESTAMP '2026-07-10 07:37:55', TIMESTAMP '2026-07-10 08:15:12') AS boundaries,
date_sub('minute', TIMESTAMP '2026-07-10 07:37:55', TIMESTAMP '2026-07-10 08:15:12') AS full_minutes;То же в pandas: diff, флаг и cumsum
В ноутбуке приём тот же: groupby('client_id')['event_time'].diff() вместо LAG, сравнение с pd.Timedelta('30min') вместо интервала, cumsum() по клиенту вместо накопительной суммы в окне. Из Parquet читаются три колонки: в app_events 1,5 млн строк и тяжёлая JSON-колонка properties, которая здесь не нужна.
Блок печатает те же 20 635 сессий, 5,02 события и 149 секунд. Вторая строка вывода — ловушка: для первого события клиента diff() возвращает NaT, сравнение NaT > Timedelta даёт False, и без gap.isna() остаётся 8 523 начала сессий — то же число, что у флага без первого события в SQL.
drop_duplicates() сравнивает все прочитанные колонки, поэтому event_id и received_at в columns нет. sort_values стоит до diff: тот считает разность с предыдущей строкой группы в том порядке, в каком строки лежат в таблице.
import pandas as pd

ev = pd.read_parquet('app_events.parquet', columns=['client_id', 'event_time', 'event_name'])
ev['event_time'] = pd.to_datetime(ev['event_time'])
# запас в сутки с каждой стороны периода 20–22 июля
ev = ev.loc[ev.event_time.ge('2026-07-19') & ev.event_time.lt('2026-07-24')]
ev = ev.drop_duplicates().sort_values(['client_id', 'event_time'])

gap = ev.groupby('client_id')['event_time'].diff()
ev['is_new'] = (gap.isna() | (gap > pd.Timedelta('30min'))).astype(int)
ev['session_no'] = ev.groupby('client_id')['is_new'].cumsum()

sess = ev.groupby(['client_id', 'session_no'])['event_time'].agg(started='min', ended='max', events='count')
sess = sess.loc[sess.started.ge('2026-07-20') & sess.started.lt('2026-07-23')]
seconds = (sess.ended - sess.started).dt.total_seconds()
print(len(sess), round(sess.events.mean(), 2), round(seconds.mean()))

# без isna(): сравнение с NaT даёт False, первое событие клиента не открывает сессию
in_period = ev.event_time.ge('2026-07-20') & ev.event_time.lt('2026-07-23')
print(int((gap > pd.Timedelta('30min'))[in_period].sum()))
Источник сессии, первое и последнее касание
Источник записан в событии app_open: properties::json ->> 'source' достаёт его текстом и в PostgreSQL, и в DuckDB. На уровень сессии его поднимают так: в первом шаге значение берут только у нужного события, в GROUP BY — MAX(source). У сессии без app_open получится NULL.
У нашего клиента источники такие: реклама Яндекса, пусто, партнёр — и покупка в третьей сессии. Модель «последнее касание» отдаст покупку партнёру, «первое касание» — Яндексу. Вторая сессия — продолжение первой после паузы, своего источника у неё нет. За три дня таких сессий 91, и в 44 есть покупка: last touch «в лоб» не засчитает её никому.
Порог сессии — часть модели атрибуции. При 60 минутах сессий без источника за эти дни не остаётся, зато в 358 оказывается больше одного app_open, в 203 из них источники разные, и MAX молча выберет последний по алфавиту. Как соединять покупку с касаниями за неделю до неё, разбирает следующий урок того же модуля курса — «Первое и последнее касание». Шаги сессии одной строкой — в статье о пути пользователя.
| session_no | started | source | has_purchase |
|---|---|---|---|
| 1 | 07:36:00 | yandex_ads | 0 |
| 2 | 08:15:12 | NULL | 0 |
| 3 | 18:02:23 | partner | 1 |
WITH ev AS (
  SELECT DISTINCT client_id, event_time, event_name,
    CASE WHEN event_name = 'app_open' THEN properties::json ->> 'source' END AS source
  FROM app_events
  WHERE client_id = '1f327ac0cb49'
), marked AS (
  SELECT client_id, event_time, event_name, source,
    CASE WHEN event_time - LAG(event_time) OVER (PARTITION BY client_id ORDER BY event_time)
              <= INTERVAL '30 minutes' THEN 0 ELSE 1 END AS is_new
  FROM ev
), numbered AS (
  SELECT client_id, event_time, event_name, source,
    SUM(is_new) OVER (PARTITION BY client_id ORDER BY event_time) AS session_no
  FROM marked
)
SELECT session_no, MIN(event_time) AS started, MAX(source) AS source,
  MAX(CASE WHEN event_name = 'purchase' THEN 1 ELSE 0 END) AS has_purchase
FROM numbered
GROUP BY client_id, session_no
ORDER BY session_no;
Частые вопросы
Как посчитать сессии в SQL, если в таблице нет идентификатора сессии? Время предыдущего события через LAG в окне по пользователю, флаг «пауза больше порога или предыдущего события нет», накопительная сумма флагов — номер сессии.
Какой порог сессии выбрать? Тридцать минут — значение по умолчанию в системах веб-аналитики, с ним цифры проще сверять. Если пауз от 15 до 60 минут мало, порог почти не влияет на число сессий, но заметно меняет среднюю длительность.
Сессия из одного события длится ноль секунд — это ошибка? Нет: длительность считается от первого события до последнего. Напишите рядом с метрикой, входят ли такие сессии в среднюю.
Что делать с сессией, которая переходит через полночь? Относить к дню начала. Берите события с запасом по краям периода и отбирайте сессии по началу, иначе хвост вчерашней станет отдельной сессией.
Чем сессии отличаются от серий и островов? Приём один — флаг начала и накопительная сумма; в сериях соседние строки сравнивают по дням, здесь — по времени. Серии разобраны в отдельной статье. В уроке курса — задачи на тот же приём на полном журнале.
Материалы по теме
LAG и LEAD в SQL: предыдущая и следующая строка на примерах
LAG и LEAD в SQL и PostgreSQL на учебной базе: синтаксис с offset и default, паузы между событиями, DAU к вчера и к прошлой неделе, следующий шаг после события, ничьи в ORDER BY, QUALIFY и IGNORE NULLS.
Оконные функции SQL: OVER и PARTITION BY, ROW_NUMBER, LAG и скользящее среднее
Оконные функции SQL на задачах аналитика: первое событие пользователя, сравнение с предыдущим днём, накопительный итог, скользящее среднее и скользящий WAU, NTILE, сессии и перцентили.
Рамка окна в SQL: ROWS BETWEEN, RANGE и GROUPS на примерах
ROWS, RANGE и GROUPS на восьми открытиях приложения: три разных ответа, рамка по умолчанию и граница pandas rolling против SQL RANGE.