Серии и острова в SQL: дни подряд, паузы и периоды сбоя
Задача gaps and islands на учебной базе: ключ серии «дата минус номер строки», паузы через LAG, часы сбоя оплаты и ловушки с измеренными числами. PostgreSQL, DuckDB, pandas.
Содержание статьи
Продакт просит список участников программы лояльности, которые в июле открывали приложение семь дней подряд. Дежурный — часы, когда в iOS ломалась оплата. Это одна и та же задача, в англоязычных текстах её называют gaps and islands: найти в ряду «острова» — непрерывные куски — и промежутки между ними. Обычная группировка здесь не работает: у 5 и 6 июля нет общего значения, по которому их можно сложить в одну строку. Его нужно построить, и в SQL для этого есть два приёма.
Короткий ответ: дни подряд в SQL за четыре шага
Серию дней подряд собирает ключ «дата минус номер строки». Внутри серии и дата, и номер растут на единицу, поэтому их разность не меняется, а после пропуска становится другой. Четыре шага — в списке ниже.
Если серия должна переживать пропуск или нужны сами паузы, вместо номера строки берут LAG, флаг начала серии и накопительную сумму флагов. Запросы написаны для PostgreSQL и без правок выполняются в DuckDB. Данные — учебная база авиакомпании, журнал событий приложения app_events; июль — полуоткрытый интервал с 1 июля до 1 августа.
- Оставьте одну строку на день:
SELECT DISTINCT member_id, CAST(event_time AS DATE) AS day. - Пронумеруйте дни каждого участника:
ROW_NUMBER() OVER (PARTITION BY member_id ORDER BY day). - Вычтите номер из даты:
day - CAST(rn AS INTEGER)— это ключ острова. - Сгруппируйте по участнику и ключу:
MIN(day)— начало серии,MAX(day)— конец,COUNT(*)— длина.
Ключ острова: дата минус номер строки
У участника 3247 в июле десять дней с открытием приложения (событие app_open). Первый запрос ставит рядом день, его номер по порядку и разность — результат в таблице.
Со 2 по 6 июля дата и номер растут вместе, разность всё время равна 1 июля. После пропуска 7–9 июля дата ушла вперёд на четыре дня, а номер — на один, и ключ сменился на 4 июля. Сам ключ — не событие: 1 июля участник приложение не открывал. Нужно от него одно — совпадать у соседних дней.
Оконную функцию нельзя поставить в GROUP BY того же запроса, поэтому ключ считают в CTE, а группируют шагом позже. Второй запрос возвращает три серии: 2–6 июля — пять дней, 10–13 июля — четыре, 18 июля — один.
| День | Номер строки | Ключ острова |
|---|---|---|
| 2 июля | 1 | 1 июля |
| 3 июля | 2 | 1 июля |
| 4 июля | 3 | 1 июля |
| 5 июля | 4 | 1 июля |
| 6 июля | 5 | 1 июля |
| 10 июля | 6 | 4 июля |
| 11 июля | 7 | 4 июля |
| 12 июля | 8 | 4 июля |
| 13 июля | 9 | 4 июля |
| 18 июля | 10 | 8 июля |
WITH days AS (
  -- один день участника — одна строка
  SELECT DISTINCT CAST(event_time AS DATE) AS day
  FROM app_events
  WHERE member_id = 3247 AND event_name = 'app_open'
    AND event_time >= TIMESTAMP '2026-07-01'
    AND event_time <  TIMESTAMP '2026-08-01'
)
SELECT day,
  ROW_NUMBER() OVER (ORDER BY day) AS rn,
  day - CAST(ROW_NUMBER() OVER (ORDER BY day) AS INTEGER) AS island
FROM days
ORDER BY day;WITH days AS (
SELECT DISTINCT CAST(event_time AS DATE) AS day
FROM app_events
WHERE member_id = 3247 AND event_name = 'app_open'
AND event_time >= TIMESTAMP '2026-07-01'
AND event_time < TIMESTAMP '2026-08-01'
), keyed AS (
-- ключ считаем шагом раньше: окно нельзя поставить в GROUP BY
SELECT day,
day - CAST(ROW_NUMBER() OVER (ORDER BY day) AS INTEGER) AS island
FROM days
)
SELECT MIN(day) AS first_day, MAX(day) AS last_day, COUNT(*) AS streak_days
FROM keyed
GROUP BY island
ORDER BY first_day;Самая длинная серия у каждого участника
Для всех участников сразу меняются две вещи: в окне появляется PARTITION BY member_id, а в группировке — сам участник. Одного ключа мало: 1 июля — ключ у каждого, кто начал серию 2 июля.
В июле приложение открывали 23 424 участника, у них набралось 45 784 серии. У 17 909 человек самая длинная серия — один день: двух дней подряд не случилось ни разу. Дальше распределение двугорбое: 3 244 участника с серией в 2–3 дня, 731 — в 4–6 дней и снова больше, 1 107, — в 7–13 дней. Это свойство учебных данных: в них заложена группа с ежедневной привычкой.
Условие member_id IS NOT NULL — не формальность. Без него строки гостей попадают в один раздел окна: 81 097 гостевых устройств сливаются в одного «участника» с серией во все 31 день, и в верхней группе оказывается 48 человек вместо 47.
Число участников по длине их самой длинной серии. Ещё у 17 909 она равна одному дню — этот столбец не показан, иначе остальные не видны.
WITH days AS (
  SELECT DISTINCT member_id, CAST(event_time AS DATE) AS day
  FROM app_events
  WHERE member_id IS NOT NULL AND event_name = 'app_open'
    AND event_time >= TIMESTAMP '2026-07-01'
    AND event_time <  TIMESTAMP '2026-08-01'
), keyed AS (
  -- нумерация своя у каждого участника
  SELECT member_id, day,
    day - CAST(ROW_NUMBER() OVER (
      PARTITION BY member_id ORDER BY day) AS INTEGER) AS island
  FROM days
), streaks AS (
  -- серия = участник + ключ
  SELECT member_id, island, COUNT(*) AS streak_days
  FROM keyed
  GROUP BY member_id, island
), best AS (
  SELECT member_id, MAX(streak_days) AS longest
  FROM streaks
  GROUP BY member_id
)
SELECT CASE WHEN longest >= 28 THEN '28-31'
            WHEN longest >= 14 THEN '14-27'
            WHEN longest >= 7  THEN '7-13'
            WHEN longest >= 4  THEN '4-6'
            WHEN longest >= 2  THEN '2-3'
            ELSE '1' END AS longest_streak,
  COUNT(*) AS members
FROM best
GROUP BY 1
ORDER BY MIN(longest);
То же в pandas: diff по дате и cumsum флага
В ноутбуке естественнее второй приём. groupby('member_id')['day'].diff() даёт число дней с прошлого активного дня, сравнение с единицей — флаг начала серии, cumsum() — её номер. У первого дня участника разность пустая, NaN != 1 истинно, и серия открывается сама. Код печатает то же распределение и те же 45 784 серии.
Ловушка здесь своя. diff() без groupby сравнивает первый день участника с последним днём предыдущего человека в отсортированной таблице. Если между ними ровно сутки, чужие серии склеиваются: последняя строка вывода — 45 173 серии, на 611 меньше. В SQL так же ошибается LAG без PARTITION BY.
И обратное различие: groupby по умолчанию выбрасывает строки с пустым ключом, так что гости в pandas исчезнут молча, а в SQL образуют отдельную группу. Фильтр notna() в коде делает поведение явным.
import pandas as pd

ev = pd.read_parquet('app_events.parquet', columns=['member_id', 'event_time', 'event_name'])
ev['event_time'] = pd.to_datetime(ev['event_time'])
start, end = pd.Timestamp('2026-07-01'), pd.Timestamp('2026-08-01')
opens = ev.loc[ev['member_id'].notna() & ev['event_name'].eq('app_open')
               & ev['event_time'].ge(start) & ev['event_time'].lt(end)]
days = (opens.assign(day=opens['event_time'].dt.normalize())[['member_id', 'day']]
        .drop_duplicates().sort_values(['member_id', 'day']))

# дней с прошлого активного дня; у первого дня участника — NaN
gap = days.groupby('member_id')['day'].diff().dt.days
days['streak_no'] = gap.ne(1).cumsum()  # NaN != 1, первый день открывает серию
streaks = days.groupby(['member_id', 'streak_no']).size()
longest = streaks.groupby(level='member_id').max()
buckets = pd.cut(longest, [0, 1, 3, 6, 13, 27, 31],
                 labels=['1', '2-3', '4-6', '7-13', '14-27', '28-31'])
print(buckets.value_counts(sort=False).to_dict())
print(len(streaks))

# ловушка: diff без groupby сравнивает с днём соседнего участника
glued = days['day'].diff().dt.days.ne(1).cumsum()
print(glued.nunique())
Второй приём: LAG, флаг начала и накопительная сумма
Разность даты и номера находит только дни строго подряд. Когда нужны сами паузы или своё правило разрыва, считают расстояние до прошлого активного дня: day - LAG(day) OVER (...). Единица — день подряд, больше — возвращение после паузы, пусто — первый день участника. Флаг начала равен 1 везде, кроме дней подряд, а накопительная сумма флагов — номер серии.
У участника 3247 флаг срабатывает трижды: 2 июля сравнивать не с чем, 10 июля прошло четыре дня, 18 июля — пять. Номера 1, 2, 3 — те же три серии, что дал первый приём.
На всём июле из 81 001 пары «участник — день» 35 217 — дни подряд, 22 360 — возвращения после паузы, из них 2 118 — после двух недель без приложения и дольше. Строгих серий 45 784, как и раньше. Замените в флаге gap_days = 1 на gap_days <= 3 — пропуск до двух дней перестанет рвать серию, и серий останется 37 789. Какой пропуск считать разрывом, решают с продуктом; в запросе это одно сравнение.
Тот же приём на времени событий режет журнал на сессии; о самой функции — в статье про LAG и LEAD.
WITH days AS (
  SELECT DISTINCT CAST(event_time AS DATE) AS day
  FROM app_events
  WHERE member_id = 3247 AND event_name = 'app_open'
    AND event_time >= TIMESTAMP '2026-07-01'
    AND event_time <  TIMESTAMP '2026-08-01'
), gaps AS (
  -- сколько дней прошло с прошлого активного дня
  SELECT day, day - LAG(day) OVER (ORDER BY day) AS gap_days
  FROM days
), flagged AS (
  -- 1 — здесь начинается серия; у первого дня gap_days пустой
  SELECT day, gap_days,
    CASE WHEN gap_days = 1 THEN 0 ELSE 1 END AS is_new
  FROM gaps
)
SELECT day, gap_days, is_new,
  SUM(is_new) OVER (ORDER BY day) AS streak_no
FROM flagged
ORDER BY day;WITH days AS (
SELECT DISTINCT member_id, CAST(event_time AS DATE) AS day
FROM app_events
WHERE member_id IS NOT NULL AND event_name = 'app_open'
AND event_time >= TIMESTAMP '2026-07-01'
AND event_time < TIMESTAMP '2026-08-01'
), gaps AS (
SELECT member_id, day,
day - LAG(day) OVER (PARTITION BY member_id ORDER BY day) AS gap_days
FROM days
)
SELECT COUNT(*) AS member_days,
COUNT(*) FILTER (WHERE gap_days = 1) AS days_in_row,
COUNT(*) FILTER (WHERE gap_days > 1) AS returns,
COUNT(*) FILTER (WHERE gap_days >= 15) AS returns_after_2_weeks,
SUM(CASE WHEN gap_days = 1 THEN 0 ELSE 1 END) AS strict_streaks,
SUM(CASE WHEN gap_days <= 3 THEN 0 ELSE 1 END) AS soft_streaks
FROM gaps;Острова по условию: часы сбоя оплаты в iOS
Остров не обязан быть серией активных дней. Дежурному нужны часы, когда оплата в iOS ломалась, и порядок действий тот же: ряд по часам, условие в WHERE, ключ среди отобранных часов, группировка. Условие — за час ошибок оплаты не меньше 60% отправок платежа.
Ключ для часов — час минус номер, умноженный на интервал: hour - ROW_NUMBER() OVER (ORDER BY hour) * INTERVAL '1 hour'. Приводить номер к INTEGER здесь не нужно. Первый шаг запроса убирает повторно доставленные события: они отличаются только event_id и received_at — подробнее в статье про дубли событий.
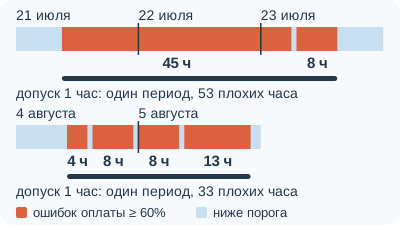
Запрос возвращает шесть островов. Сбоев при этом было два.
| Первый час | Последний час | Часов | Отправок платежа | Ошибок оплаты |
|---|---|---|---|---|
| 21 июля 09:00 | 23 июля 05:00 | 45 | 1 236 | 888 |
| 23 июля 07:00 | 23 июля 14:00 | 8 | 222 | 165 |
| 4 августа 10:00 | 4 августа 13:00 | 4 | 113 | 86 |
| 4 августа 15:00 | 4 августа 22:00 | 8 | 244 | 180 |
| 5 августа 00:00 | 5 августа 07:00 | 8 | 189 | 137 |
| 5 августа 09:00 | 5 августа 21:00 | 13 | 422 | 306 |
WITH ev AS (
  -- дубли доставки отличаются только event_id и received_at
  SELECT DISTINCT client_id, event_time, event_name, properties
  FROM app_events
  WHERE platform = 'ios'
), hourly AS (
  SELECT date_trunc('hour', event_time) AS hour,
    COUNT(*) FILTER (WHERE event_name = 'payment_submit') AS payments,
    COUNT(*) FILTER (WHERE event_name = 'error'
      AND (properties::json ->> 'step') = 'payment_submit') AS payment_errors
  FROM ev
  GROUP BY 1
), bad AS (
  -- WHERE срабатывает до окна: нумеруются только плохие часы
  SELECT hour, payments, payment_errors,
    hour - ROW_NUMBER() OVER (ORDER BY hour) * INTERVAL '1 hour' AS island
  FROM hourly
  WHERE payment_errors >= 0.6 * payments
)
SELECT MIN(hour) AS first_hour, MAX(hour) AS last_hour,
  COUNT(*) AS hours, SUM(payments) AS payments,
  SUM(payment_errors) AS payment_errors
FROM bad
GROUP BY island
ORDER BY first_hour;
Ловушка 1: порог режет один сбой на шесть островов
Острова разделяет по одному часу. 23 июля в 06:00 ошибкой кончились 16 оплат из 27 — это 59,3%. Ещё три таких часа — 4 августа в 14:00 и 23:00, 5 августа в 08:00 — с долей 58,3–58,8%. Сбой не прекращался, доля на час опустилась под порог. При пороге 70% тот же ряд рассыпается на 25 островов.
Исправление — второй приём с допуском: новый период начинается, только если с прошлого плохого часа прошло больше двух часов. Один «хороший» час между плохими разрыва не делает. Получается два периода: 21–23 июля — 53 плохих часа, ошибкой кончились 72,2% оплат, и 4–5 августа — 33 часа и 73,2%.
WITH ev AS (
  SELECT DISTINCT client_id, event_time, event_name, properties
  FROM app_events
  WHERE platform = 'ios'
), hourly AS (
  SELECT date_trunc('hour', event_time) AS hour,
    COUNT(*) FILTER (WHERE event_name = 'payment_submit') AS payments,
    COUNT(*) FILTER (WHERE event_name = 'error'
      AND (properties::json ->> 'step') = 'payment_submit') AS payment_errors
  FROM ev
  GROUP BY 1
), bad AS (
  SELECT hour, payments, payment_errors,
    LAG(hour) OVER (ORDER BY hour) AS prev_hour
  FROM hourly
  WHERE payment_errors >= 0.6 * payments
), flagged AS (
  -- один «хороший» час между плохими период не рвёт
  SELECT hour, payments, payment_errors,
    CASE WHEN hour - prev_hour <= INTERVAL '2 hours' THEN 0 ELSE 1 END AS is_new
  FROM bad
), numbered AS (
  SELECT hour, payments, payment_errors,
    SUM(is_new) OVER (ORDER BY hour) AS period_no
  FROM flagged
)
SELECT period_no,
  CAST(MIN(hour) AS DATE) AS first_day, CAST(MAX(hour) AS DATE) AS last_day,
  COUNT(*) AS bad_hours,
  ROUND(100.0 * SUM(payment_errors) / SUM(payments), 1) AS error_pct
FROM numbered
GROUP BY period_no
ORDER BY period_no;
Ловушка 2: порог по доле при малом знаменателе
В iOS в среднем 21 отправка платежа в час, в самый тихий час — пять. При таком знаменателе обычные отказы карт случайно дают высокую долю: 1 июля в 19:00 — 6 ошибок на 14 оплат, 8 июля в 09:00 — 8 на 15. Запрос прогоняет один и тот же ряд через пять порогов.
При пороге 30% островов 43, и 38 из них — одиночные часы. Зато островов от трёх часов при порогах 30, 40 и 50% ровно два — это и есть сбои. Отсюда отсев: HAVING COUNT(*) >= 3 после группировки по ключу.
Фильтр по объёму на уровне часа — плохая замена. payments >= 20 при пороге 50% выбросит 10 тихих часов из 91 плохого, и вместо трёх островов получится десять: ночные часы внутри настоящего сбоя порвут его.
| Порог | Плохих часов | Островов | Одиночных часов | Островов от 3 часов |
|---|---|---|---|---|
| 30% | 134 | 43 | 38 | 2 |
| 40% | 93 | 5 | 3 | 2 |
| 50% | 91 | 3 | 1 | 2 |
| 60% | 86 | 6 | 0 | 6 |
| 70% | 52 | 25 | 12 | 7 |
WITH ev AS (
  SELECT DISTINCT client_id, event_time, event_name, properties
  FROM app_events
  WHERE platform = 'ios'
), hourly AS (
  SELECT date_trunc('hour', event_time) AS hour,
    COUNT(*) FILTER (WHERE event_name = 'payment_submit') AS payments,
    COUNT(*) FILTER (WHERE event_name = 'error'
      AND (properties::json ->> 'step') = 'payment_submit') AS payment_errors
  FROM ev
  GROUP BY 1
), bad AS (
  -- один и тот же ряд проверяем на пяти порогах сразу
  SELECT t.pct, h.hour,
    h.hour - ROW_NUMBER() OVER (
      PARTITION BY t.pct ORDER BY h.hour) * INTERVAL '1 hour' AS island
  FROM hourly AS h
  CROSS JOIN (VALUES (30), (40), (50), (60), (70)) AS t(pct)
  WHERE 100 * h.payment_errors >= t.pct * h.payments
), islands AS (
  SELECT pct, island, COUNT(*) AS hours
  FROM bad
  GROUP BY pct, island
)
SELECT pct AS threshold_pct,
  SUM(hours) AS bad_hours,
  COUNT(*) AS islands,
  COUNT(*) FILTER (WHERE hours = 1) AS single_hours,
  COUNT(*) FILTER (WHERE hours >= 3) AS islands_3h_plus
FROM islands
GROUP BY pct
ORDER BY pct;
Ловушка 3: повторы дня до ROW_NUMBER
Приём с номером строки требует, чтобы день встречался один раз. Уберите DISTINCT из первого шага — и на вход вместо 81 001 пары «участник — день» пойдут 101 832 открытия: приложение открывают по нескольку раз в день, а 785 строк — повторная доставка.
Два открытия одного дня получают разные номера и разные ключи. Серий становится 58 182 вместо 45 784, самая длинная — 20 дней вместо 31. У участника 3247 выходит пять серий вместо трёх, и одна из них — «со 2 по 13 июля» из четырёх строк: ключ 1 июля случайно совпал у 2, 3, 12 и 13 июля.
Второй приём терпимее, если флаг написан с запасом. При gap_days <= 1 повтор дня с разностью 0 серию не рвёт, и серий по-прежнему 45 784; при gap_days = 1 их 66 615. Длину в этом случае считают как COUNT(DISTINCT day).
Ловушка 4: дата минус BIGINT в PostgreSQL и DuckDB
ROW_NUMBER() возвращает BIGINT, а вычесть из даты оба движка позволяют только INTEGER. Выражение day - ROW_NUMBER() OVER (...) падает и там, и там: PostgreSQL отвечает operator does not exist: date - bigint, DuckDB — No function matches the given name and argument types '-(DATE, BIGINT)'. Отсюда CAST(... AS INTEGER) в запросах выше.
Расходятся движки в другом: разность двух дат в PostgreSQL — INTEGER, в DuckDB — BIGINT. Поэтому day - (last_day - first_day) в PostgreSQL выполняется, а в DuckDB падает той же ошибкой. На сравнения вроде gap_days <= 3 это не влияет.
Обойтись без приведения можно двумя способами, оба работают в обоих движках и дают те же 45 784 серии. Первый — вычитать интервал: day - rn * INTERVAL '1 day', ключ станет меткой времени. Второй — сделать ключ числом: (day - DATE '2026-07-01') - rn.
| Выражение | PostgreSQL | DuckDB |
|---|---|---|
date - integer | date | date |
date - bigint | ошибка | ошибка |
date - date | integer | bigint |
date - (date - date) | date | ошибка |
date - n * INTERVAL '1 day' | timestamp | timestamp |
timestamp - n * INTERVAL '1 hour' | timestamp | timestamp |
Ловушка 5: серии на краях периода
Июльский отчёт режет серии по границам месяца. В 31 июля упираются 2 932 серии, и 1 362 из них — 46,5% — продолжились 1 августа: в июльской таблице они короче, чем были на самом деле.
С левым краем хуже: 1 652 серии начинаются 1 июля, в первый день журнала, и что было раньше, база не знает. Среди серий от недели (их 1 917) края касаются 675 — каждая третья.
Длина обрезанной серии — «не меньше». Считайте серии на всём доступном ряду и только потом отбирайте период, а серии, которые касаются края журнала или среза, помечайте отдельным флагом. Похожий разрыв даёт пустая корзина: если за час или день в данных нет ни одной строки, остров по условию на нём порвётся. Тогда сначала строят ряд дат без пропусков.
Частые вопросы
Как найти дни подряд в SQL? Оставить одну строку на день, пронумеровать дни через ROW_NUMBER(), вычесть номер из даты и сгруппировать по разности. MIN, MAX и COUNT дадут начало, конец и длину серии.
Что такое gaps and islands? Класс задач о непрерывных участках ряда: острова — серии подряд идущих значений, gaps — промежутки между ними. Дни активности, часы сбоя и сессии решаются одним набором приёмов.
Что выбрать: номер строки или LAG? Номер строки короче и подходит для серий строго подряд. LAG с флагом нужен, когда важны длины пауз, когда серия должна переживать пропуск или когда разрыв задаётся условием.
Можно ли обойтись без оконных функций? Да: начало серии — день, у которого нет строки за вчера, это NOT EXISTS по той же таблице. На июльских данных он находит те же 45 784 начала, но конец и длину придётся досчитывать отдельно — соединением таблицы с собой.
Как найти самую длинную серию? Посчитать длины всех серий и взять MAX по участнику. Если нужны и даты этой серии — ROW_NUMBER() по убыванию длины и первая строка.
В уроке курса — задачи на тот же приём, на других участниках и периодах.
Материалы по теме
Self join в SQL: как соединить таблицу саму с собой
Self join на рейсах одного дня: 375 пар отправлений за полчаса, двойной счёт и сравнение с pandas merge и merge_asof на тех же данных.
Сессии в SQL: как нарезать события по паузе в 30 минут
Собираем сессии пользователя в SQL: пауза через LAG, флаг начала, накопительная сумма. Пороги 15, 30 и 60 минут, дубли, край периода и тот же расчёт в pandas.
LAG и LEAD в SQL: предыдущая и следующая строка на примерах
LAG и LEAD в SQL и PostgreSQL на учебной базе: синтаксис с offset и default, паузы между событиями, DAU к вчера и к прошлой неделе, следующий шаг после события, ничьи в ORDER BY, QUALIFY и IGNORE NULLS.