SQL или Python: что учить аналитику первым и где граница между ними
SQL и Python в работе аналитика данных: что учить первым, какие задачи решать запросом, а какие в pandas. Одна задача двумя способами на учебной базе и порядок изучения.
Содержание статьи
Аналитику данных и продуктовому аналитику первым стоит учить SQL: рабочие данные лежат в базе, и чаще всего до них добираются запросом. Python идёт вторым — с того момента, когда вопрос упирается в то, чего запрос не делает или делает неудобно: статистический критерий, график, кривой файл от подрядчика, модель. Исключений два: данные приходят к вам файлами или роль ближе к машинному обучению. Ниже граница между SQL и Python показана на одной задаче: активация и конверсия в оплату по каналам посчитаны запросом и в pandas на учебной базе симулятора SQL-аналитика, числа совпадают.
SQL или Python: что учить первым?
Первым — SQL, если ваши данные лежат в базе или хранилище; так устроены продуктовая и маркетинговая аналитика, отчётность и BI. Первая же задача — «сколько людей из рекламы дошли до оплаты» — начинается с запроса. Пока запроса нет, pandas нечего обрабатывать.
Вторая причина: SQL меньше. Аналитику нужны запросы на чтение — отбор, группировка, соединение таблиц, даты, оконные функции. Python — язык общего назначения, и аналитик берёт из него узкий слой: таблицы, статистику и графики. Отсюда порядок по ролям.
- Аналитик данных, продуктовый, маркетинговый, BI-аналитик: сначала SQL, затем Python.
- Данные приходят файлами — выгрузки из учётной системы, Excel от коллег — и доступа к базе нет: начните с pandas или с DuckDB, который выполняет SQL прямо над файлом.
- Роль ближе к машинному обучению: Python нужен с первого дня, SQL — параллельно, чтобы самому собирать выборку для модели.
Что аналитик делает в SQL, а что в Python?
Правило из двух частей. Пока данные лежат в базе, а ответ — таблица, работает SQL. Python начинается там, где на входе что-то кроме базы или на выходе что-то кроме таблицы: график, оценка неопределённости, модель, файл.
В таблице — тринадцать типовых задач. «Удобнее» значит, что решение короче и в нём труднее ошибиться: соединить таблицы можно и в pandas.
| Задача | Где удобнее | Почему |
|---|---|---|
| Выгрузить строки по условию | SQL | фильтр выполняется в базе, наружу уходят только нужные строки |
| Суммы, счётчики и доли по группам | SQL | GROUP BY считает там, где лежат данные |
| Соединить таблицы | SQL | соединение выполняется в базе, до выгрузки; в pandas то же делает merge |
| Нарастающий итог, ранг, предыдущая строка | SQL | оконные функции; в pandas — cumsum, rank, shift по группам |
| Воронка и когорты | SQL | расчёт идёт по всем событиям, а результат — небольшая таблица |
| Регулярный отчёт | SQL (+ BI) | запрос сохраняют как представление в базе или как вопрос в BI-инструменте |
| Таблица больше оперативной памяти | SQL | pandas держит данные в памяти целиком |
| Почистить «грязный» файл | Python | разные форматы дат и лишние строки шапки правят кодом по шагам |
| Статистический критерий, интервал | Python | критерий — готовая функция scipy; интервал — формула в строку рядом с расчётом |
| График для исследования | Python | matplotlib рисует в ноутбуке рядом с расчётом |
| Перебор вариантов: окна, пороги, пары сегментов | Python | цикл и функция вместо копий запроса |
| Данные из API, «грязные» Excel и JSON | Python | запрос к API и пошаговая чистка — это код; аккуратный файл читает и DuckDB |
| Модель: регрессия, прогноз, классификация | Python | библиотеки для обучения и проверки моделей |
Как посчитать активацию и оплату по каналам в SQL?
Вопрос менеджера: «Какой канал приводит людей, которые создают рабочее пространство и платят?» В учебной базе для ответа нужны три таблицы: users — 4 613 регистраций с каналом, events — 35 341 событие, payments — 1 251 оплата. Активация — событие workspace_created, оплата — хотя бы одна строка в payments.
Окно регистраций — с 1 июля по 9 августа, 2 165 человек. Нижняя граница нужна, потому что платный поиск запущен 1 июля, а остальные каналы работают с июня. Верхняя — потому что первая оплата в этих данных приходит через 3–20 дней после регистрации, а оплаты записаны по 30 августа: в окно попадают только те, у кого эти 20 дней уже прошли. Без верхней границы конверсия платного поиска — 8,47% вместо 10,79%.
Два подзапроса с DISTINCT сводят события и оплаты к одной строке на пользователя. Если присоединить payments напрямую, продления размножат строки: у organic выйдет 834 строки на 780 человек и 253 оплаты на 199 плательщиков. Почему так происходит, разобрано в статье о JOIN без потерь и дублей.
Запрос возвращает четыре строки. Реферальный канал даёт наибольшие доли, платный поиск — наименьшие: 36,55% активации и 10,79% оплаты.
| channel | users | activated | paid | activation_pct | paid_pct |
|---|---|---|---|---|---|
| referral | 449 | 340 | 141 | 75,72 | 31,40 |
| organic | 780 | 512 | 199 | 65,64 | 25,51 |
| partner | 315 | 161 | 67 | 51,11 | 21,27 |
| paid_search | 621 | 227 | 67 | 36,55 | 10,79 |
WITH activated AS (
  SELECT DISTINCT user_id
  FROM events
  WHERE event_name = 'workspace_created'
),
payers AS (
  SELECT DISTINCT user_id
  FROM payments
)
SELECT
  u.channel,
  COUNT(*) AS users,
  COUNT(a.user_id) AS activated,
  COUNT(p.user_id) AS paid,
  ROUND(100.0 * COUNT(a.user_id) / COUNT(*), 2) AS activation_pct,
  ROUND(100.0 * COUNT(p.user_id) / COUNT(*), 2) AS paid_pct
FROM users u
LEFT JOIN activated a ON a.user_id = u.user_id
LEFT JOIN payers p ON p.user_id = u.user_id
WHERE u.signup_date >= DATE '2026-07-01'
  AND u.signup_date < DATE '2026-08-10'
GROUP BY u.channel
ORDER BY paid_pct DESC;
Как та же сводка выглядит в pandas?
В pandas те же шаги называются иначе. Фильтр по дате — логическая маска. «Есть ли у пользователя оплата» — u["paid"] = u["user_id"].isin(payments["user_id"]). Группировка — (100 * u.groupby("channel")[["activated", "paid"]].mean()).round(2); u — копия отфильтрованной таблицы (.copy()). На трёх таблицах учебной базы этот код даёт те же 36,55% и 10,79%.
Но чтобы его выполнить, все три таблицы должны оказаться в памяти ноутбука. Поэтому в работе граница проходит раньше: запрос возвращает четыре строки, pandas продолжает с них. Блок ниже берёт результат SQL, пересчитывает доли — 31,40, 25,51, 21,27 и 10,79% — и добавляет то, чего в запросе не было: половину ширины 95%-го доверительного интервала. У платного поиска это ±2,44 процентного пункта, у партнёрского канала с его 315 регистрациями — ±4,52.
Часть расхождений по синтаксису не заметить, и почти все связаны с пропусками. GROUP BY country в SQL возвращает пять строк: пятая — NULL, 55 пользователей без страны. groupby("country") в pandas пустой ключ молча выбрасывает: групп четыре, в сумме 4 558 человек из 4 613. Строку возвращает параметр dropna=False. Это поведение по умолчанию и в pandas 2.3, на которой выполнен код статьи, и в документации pandas 3.0. Ещё два: merge сопоставляет пустые ключи друг с другом, а JOIN — нет; country != "RU" в pandas оставляет строки с пропуском (1 898), в SQL — отбрасывает (1 843). Подробно — в статье о NULL и COALESCE.
| SQL | pandas |
|---|---|
WHERE channel = 'organic' | df[df["channel"] == "organic"] |
GROUP BY и агрегат | groupby(...).agg(...) |
LEFT JOIN | merge(..., how="left") |
COUNT(DISTINCT user_id) | df["user_id"].nunique() |
ORDER BY amount DESC, payment_id LIMIT 3 | sort_values(["amount", "payment_id"], ascending=[False, True]).head(3) |
CASE WHEN | numpy.where(...) |
SUM(x) OVER (PARTITION BY g) | df.groupby("g")["x"].transform("sum") |
SUM(x) OVER (PARTITION BY g ORDER BY t), LAG(x) OVER (…) | df.sort_values("t").groupby("g")["x"].cumsum(), ….shift() — после сортировки |
import numpy as np
import pandas as pd

# четыре строки, которые вернул SQL-запрос выше
summary = pd.DataFrame({
    'channel':   ['referral', 'organic', 'partner', 'paid_search'],
    'users':     [449, 780, 315, 621],
    'activated': [340, 512, 161, 227],
    'paid':      [141, 199, 67, 67],
})

summary['activation_pct'] = (100 * summary['activated'] / summary['users']).round(2)
share = summary['paid'] / summary['users']
summary['paid_pct'] = (100 * share).round(2)
# половина ширины 95%-го интервала для доли, в процентных пунктах
summary['paid_ci'] = (100 * 1.96 * np.sqrt(share * (1 - share) / summary['users'])).round(2)

print(summary[['channel', 'users', 'activation_pct', 'paid_pct', 'paid_ci']].to_string(index=False))Чего запрос не скажет: различаются ли каналы?
Партнёрский канал конвертирует в оплату 21,27%, органика — 25,51%. Разница 4,24 процентного пункта — отставание канала или шум на 315 регистрациях? Четыре строки сводки на это не отвечают: нужна оценка неопределённости.
Интервал для разницы долей написать в SQL можно, это корень и арифметика. Критерию хи-квадрат нужна функция распределения, а её нет ни в каталоге функций PostgreSQL 14, ни в DuckDB 1.4. В scipy это одна строка.
Результат: хи-квадрат 74,57 при трёх степенях свободы, p = 4,5·10⁻¹⁶ — конверсия в оплату различается между каналами. Платный поиск ниже органики на 14,72 п. п., интервал от −18,64 до −10,81 далеко от нуля. У партнёрского канала интервал от −9,70 до +1,21 накрывает ноль: по этим данным нельзя утверждать, что он хуже органики.
Две оговорки. Хи-квадрат говорит, что различия есть, но не между кем; попарных сравнений у четырёх каналов шесть, и порог для них стоит ужесточить. С поправкой Бонферрони (z = 2,64 вместо 1,96) выводы те же: платный поиск − органика от −19,99 до −9,46, партнёрский − органика от −11,59 до +3,10. А преимущество реферального канала над органикой по оплате (+5,89 п. п.) поправку не проходит: от −1,21 до +12,99. И каналы никто не распределял случайно: разница описывает людей, которые пришли, а не то, что канал с ними сделал.
(p₁ − p₂) ± 1,96 · √( p₁(1 − p₁)/n₁ + p₂(1 − p₂)/n₂ )Платный поиск и органика: p₁ = 67/621, p₂ = 199/780, разница −14,72 п. п., интервал от −18,64 до −10,81.
import numpy as np
from scipy import stats

# канал: (регистраций, оплатили) — из того же SQL-результата
channels = {
    'referral': (449, 141),
    'organic': (780, 199),
    'partner': (315, 67),
    'paid_search': (621, 67),
}

# таблица 4×2: оплатили / не оплатили
table = [[paid, n - paid] for n, paid in channels.values()]
chi2, p_value, dof, _ = stats.chi2_contingency(table)
print(f'хи-квадрат = {chi2:.2f}, степеней свободы {dof}, p = {p_value:.1e}')


def diff_ci(a, b):
    (n_a, x_a), (n_b, x_b) = channels[a], channels[b]
    p_a, p_b = x_a / n_a, x_b / n_b
    se = np.sqrt(p_a * (1 - p_a) / n_a + p_b * (1 - p_b) / n_b)
    d = p_a - p_b
    print(f'{a} − {b}: {100 * d:+.2f} п. п., '
          f'95% от {100 * (d - 1.96 * se):+.2f} до {100 * (d + 1.96 * se):+.2f}')


diff_ci('paid_search', 'organic')
diff_ci('partner', 'organic')Где SQL удобнее, чем Python?
Первое — объём. Частая ошибка новичка, пришедшего из Python: выполнить SELECT * по каждой таблице и считать всё в pandas. Для нашей задачи это 4 613 + 35 341 + 1 251 = 41 205 строк, отправленных из базы в ноутбук, против четырёх строк готовой сводки. Учебную базу pandas переварит. Но он держит таблицу в оперативной памяти, и документация pandas предупреждает, что с данными больше памяти работать трудно, — а таблица событий в живом продукте растёт каждый день.
Второе — одно определение на всех. Запрос — это текст, в котором записано определение метрики: окно регистраций, что считается активацией, как сведены оплаты. Коллега выполнит его и получит те же 10,79%, и результат не зависит от того, чья выгрузка лежит на диске. Ноутбук воспроизводим в той же мере, если начинается с запроса, а не с CSV месячной давности.
Третье — расчёт живёт рядом с данными. Запрос можно сохранить в базе как представление, и следующий отчёт начнётся с него — если у вас есть право создавать объекты; с доступом только на чтение запрос хранят в BI-инструменте или в репозитории. Как это устроено — в статье о VIEW и временных таблицах.
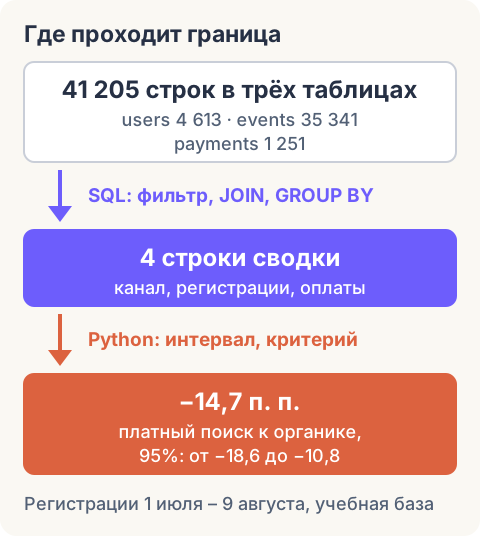
Что быстрее — запрос или pandas — зависит от базы, объёма, индексов и сети. Сравнения «запрос к базе против pandas» мы не делали и чисел не называем: на 41 205 строках оно ничего не скажет о рабочей базе. Замер DuckDB и pandas на файле в 10 млн строк — в статье о DuckDB.
Где без Python не обойтись?
Там, где результат запроса — только начало. Пять таких случаев перечислены под графиком. Сам график в ноутбуке даёт одна строка: summary.plot.bar(x="channel", y=["activation_pct", "paid_pct"]).
Регистрации 1 июля – 9 августа 2026, 2 165 человек. Учебная база симулятора SQL-аналитика.
- Статистика: интервал и критерий из прошлого раздела, дальше — бутстреп, размер выборки, регрессия.
- Перебор: функция
diff_ciсравнила две пары каналов; на все шесть нужен цикл в две строки. Шесть пар с интервалами даст и одно самосоединение сводки в SQL; цикл выигрывает, когда перебор растёт: другие окна, метрики, пороги, поправка на число сравнений. - Графики: столбцы, линии и распределения рядом с расчётом, пока вы ещё ищете, что показать.
- Файлы и API: ответ рекламного кабинета по API, Excel с объединёнными ячейками и шапкой в три строки, CSV с датами в трёх форматах. Аккуратный файл прочитает и SQL — DuckDB делает это запросом; вызвать API и починить кривой файл по шагам удобнее кодом.
- Модели: несколько признаков, проверка на отложенной выборке, прогноз, классификация. Прямую по двум столбцам посчитает и SQL (
regr_slope,regr_intercept) — так сделано в статье о линейной регрессии; дальше нужны библиотеки Python.
Как соединить SQL и Python в одном ноутбуке?
Обычный порядок: запрос агрегирует в базе, ноутбук получает результат. В pandas для этого есть read_sql. По документации функция принимает текст запроса и подключение — SQLAlchemy или ADBC; из обычных DBAPI-подключений поддержан только sqlite3 — и возвращает DataFrame. Значения в запрос передают параметром params, а не склейкой строк.
Второй способ — DuckDB. Он ставится как пакет Python и выполняет SQL над DataFrame, обращаясь к нему по имени переменной. Это удобно, когда данные уже в pandas, а расчёт привычнее записать на SQL. Блок выполнен на pandas 2.3 и DuckDB 1.4; в pandas 3.0 строковые столбцы получили новый тип, и DuckDB 1.4 его не распознаёт («Data type 'str' not recognized») — обновите DuckDB или приведите столбец к прежнему типу: df.astype({"channel": object}). В блоке ниже он считает доли каналов: платный поиск дал 28,68% регистраций окна и 14,14% оплативших. Подробнее о нём — в статье DuckDB для аналитика.
На стыке языков меняется деление. 67 / 621 в PostgreSQL даёт 0: оба числа целые, дробная часть отбрасывается. В DuckDB и в Python то же выражение даёт 0,1079. Поэтому в запросе статьи стоит 100.0 *: с ним результат одинаков в обеих базах.
Встречаются оба языка в ноутбуке Jupyter: в одной ячейке запрос, в следующей pandas, под ними график и вывод.
import duckdb
import pandas as pd

# результат SQL-запроса из начала статьи уже лежит в DataFrame
summary = pd.DataFrame({
    'channel': ['referral', 'organic', 'partner', 'paid_search'],
    'users':   [449, 780, 315, 621],
    'paid':    [141, 199, 67, 67],
})

# DuckDB находит DataFrame по имени переменной и выполняет над ним SQL
shares = duckdb.sql("""
    SELECT channel,
           ROUND(100.0 * users / SUM(users) OVER (), 2) AS users_share,
           ROUND(100.0 * paid / SUM(paid) OVER (), 2)   AS payers_share
    FROM summary
    ORDER BY users_share DESC
""").df()
print(shares.to_string(index=False))
В каком порядке учить SQL и Python?
Маршрут ниже — порядок тем, без сроков: скорость зависит от времени и опыта. Понедельный план по SQL есть в статье «Как выучить SQL с нуля», здесь — как пристыковать к нему Python.
Отложить можно классы и наследование, декораторы, асинхронность, веб-фреймворки, алгоритмические задачи и нейронные сети. Это инструменты разработчика и ML-инженера; аналитик берёт их, когда появляется задача.
- SQL до продуктовых метрик: отбор строк, агрегаты, JOIN с контролем числа строк, CASE и NULL, CTE, даты, оконные функции. Проверка — вы сами считаете воронку и retention.
- Минимум Python: типы, списки и словари, функции, циклы, чтение сообщений об ошибках.
- pandas: чтение CSV и Excel, типы столбцов и даты, фильтр,
groupby,merge, пропуски. Каждую операцию сверяйте с тем, как она пишется в SQL. - Графики в matplotlib: линия, столбцы, распределение.
- Статистика в scipy: доверительный интервал, сравнение долей и средних, хи-квадрат.
- Связка: запрос из ноутбука и расчёт, который перезапускается от первой ячейки до последней.
Как готовиться к собеседованию по SQL и Python?
Состав этапов зависит от команды и роли, поэтому готовьтесь по тексту вакансии: что в ней названо, то и повторяйте первым. К SQL-части готовятся задачами на запрос — соединить таблицы, посчитать по группам, применить окно — с объяснением, почему числу можно верить. К части про Python — задачами на pandas: фильтр, группировка, соединение, даты, пропуски.
Тренировка к обеим частям — решить одну задачу двумя способами и объяснить, почему числа совпали. Или не совпали: пустой ключ в groupby и целочисленное деление — как раз такие случаи.
Частые вопросы
Python или SQL — что выбрать, если времени хватает на одно? SQL, если вы идёте в аналитику данных, продуктовую аналитику или BI: с ним вы проходите путь от вопроса до числа сами. Python без SQL оставляет вас зависимым от того, кто выгрузит данные.
Нужен ли Python аналитику данных? Для первых задач — выгрузок, метрик, отчётов — можно обойтись без него. Он становится нужен, когда появляются эксперименты, файлы из внешних источников, нестандартные графики или расчёты, которые надо повторять.
Хватит ли одного SQL? Там, где результат работы — таблица или дашборд, хватит надолго. Потолок виден в этой статье: запрос вернул 21,27% и 25,51%, но не сказал, различаются ли они.
Что сложнее — SQL или Python? В SQL меньше конструкций: аналитику хватает запросов на чтение; в Python больше синтаксиса и библиотек. Главная трудность у них общая: и запрос, и код на pandas выполняются без ошибки и возвращают правдоподобное неверное число — 253 оплаты вместо 199 плательщиков или сводку без 55 человек.
Зачем учить оба, если код пишет нейросеть? Модель напишет и запрос, и код на pandas, но за число отвечаете вы. Чтобы заметить размноженные строки или потерянный пустой ключ, нужно читать оба языка. Разборы таких ошибок — в статьях о нейросети для SQL и нейросети для Python.
Что попробовать на учебной базе?
Запрос из статьи можно выполнить в песочнице симулятора SQL-аналитика на этой же базе. Замените u.channel на u.device в SELECT и GROUP BY. Должно получиться: desktop — 1 107 регистраций, активация 60,16%, оплата 24,30%; mobile — 1 058 регистраций, 54,25% и 19,38%.
Затем перенесите две строки в Python-блок с diff_ci. Ответ: на мобильных конверсия в оплату ниже на 4,92 п. п., 95%-й интервал от −8,40 до −1,45. Не спешите с выводом об устройстве: платный поиск — 19% десктопных регистраций окна и 38% мобильных. Добавьте u.channel в GROUP BY: внутри каждого канала интервал накрывает ноль, а при общем составе каналов разница сокращается до −2,05 п. п. (от −5,55 до +1,45). Почему так — в статье о парадоксе Симпсона. Python посчитал интервал, но какой разрез сравнивать, решаете вы.
Материалы по теме
DuckDB для аналитика: SQL по CSV и Parquet без сервера
Что такое DuckDB и как выполнять SQL по CSV, Parquet и pandas DataFrame без сервера: примеры в Python, задача от выгрузки до ответа, отличия от PostgreSQL и ограничения.
Собеседование аналитика данных: 30 задач и как решать их вслух
Большой практический гайд по собеседованию аналитика данных: SQL, Python, метрики, статистика, кейсы, дашборды и ответы, которые показывают ход мышления.
SQL VIEW и временные таблицы: где хранить промежуточный расчёт
Что такое представление (VIEW) в SQL, чем от него отличаются временная таблица и материализованное представление, как их создать и что выбрать. Запросы для PostgreSQL и DuckDB.