DuckDB для аналитика: SQL по CSV и Parquet без сервера
Что такое DuckDB и как выполнять SQL по CSV, Parquet и pandas DataFrame без сервера: примеры в Python, задача от выгрузки до ответа, отличия от PostgreSQL и ограничения.
Содержание статьи
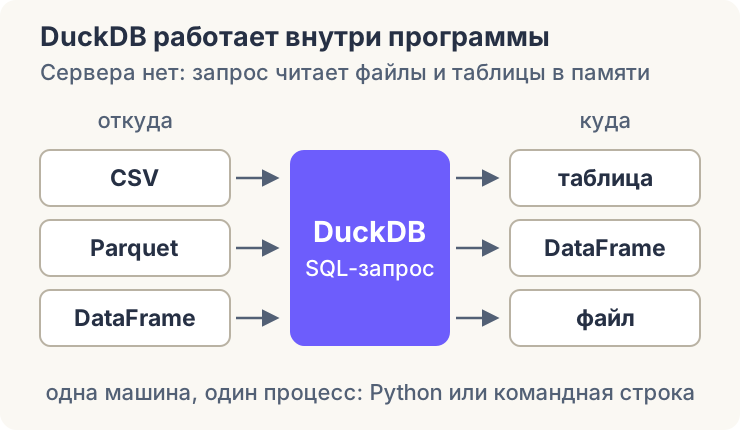
DuckDB — встраиваемая аналитическая СУБД: она работает внутри вашей программы, хранит базу в одном файле или в памяти и не требует сервера. Аналитику она нужна, когда данные лежат файлами или в таблице pandas, а считать удобнее на SQL: запрос SELECT … FROM 'users.csv' выполняется сразу, без загрузки в базу. Ниже — запросы к CSV, Parquet и DataFrame, одна задача от выгрузки до ответа, отличия синтаксиса от PostgreSQL и случаи, когда DuckDB не подходит. Примеры выполнены на учебной базе симулятора SQL-аналитика: Python-блоки — на DuckDB 1.4.1 и pandas 2.3, SQL перепроверен в DuckDB 1.5.4 (движок песочницы курса) и PostgreSQL 14.
Что такое DuckDB и когда он нужен аналитику
Привычная СУБД — отдельная программа-сервер: её ставят, настраивают, к ней подключаются по сети. DuckDB устроен как библиотека. Страница «Why DuckDB» официального сайта перечисляет его свойства: работает целиком внутри процесса-хозяина, не имеет внешних зависимостей, обрабатывает данные по столбцам и пакетами значений, распространяется по лицензии MIT. В Python он ставится командой pip install duckdb.
Отсюда три рабочие ситуации. Вам прислали выгрузку на миллионы строк, и её нужно быстро посчитать. Данные уже лежат в DataFrame, а соединение трёх таблиц с оконной функцией проще написать на SQL. Или нужен разовый расчёт на ноутбуке, ради которого не хочется поднимать PostgreSQL.
Минимальный пример — ниже. В статье файлы получены из учебной базы командой COPY … TO: она пишет таблицу users в CSV, а следующий запрос читает файл. Самой базы у вас на диске нет, а песочница курса файлов не пишет, поэтому блоки с COPY показывают, откуда взялся файл; чтобы повторить приём, подставьте в FROM свою выгрузку. Файлы в примерах лежат в /tmp; на Windows подставьте свой путь.
COPY (SELECT * FROM users ORDER BY user_id)
  TO '/tmp/mayak_users.csv' (HEADER);

SELECT channel, count(*) AS users
FROM '/tmp/mayak_users.csv'
GROUP BY channel
ORDER BY users DESC;

-- organic     | 1747
-- referral    | 1037
-- paid_search | 1015
-- partner     |  814
Как выполнить SQL-запрос к CSV без загрузки в базу
Путь к файлу в FROM — сокращение для функции read_csv. Она сама определяет разделитель, строку заголовков и типы столбцов. По документации (раздел «CSV Auto Detection») типы подбираются по выборке, по умолчанию это 20 480 строк, от строгих к общим: логический, дата и время, BIGINT, DOUBLE, VARCHAR.
Что получилось, показывает DESCRIBE. Дата оплаты распознана как DATE, но два типа изменились: целые INTEGER стали BIGINT, а сумма DECIMAL(10,2) превратилась в DOUBLE. CSV типов не хранит, их каждый раз угадывают заново. Для денег это существенно: DOUBLE хранит дроби приближённо, 0.1 + 0.2 в нём равно 0.30000000000000004.
Тип можно задать явно: read_csv('/tmp/mayak_payments.csv', types = {'amount': 'DECIMAL(10,2)'}). Остальные столбцы по-прежнему определятся сами.
Без Python то же делает командная строка — отдельная программа duckdb. По документации («Command Line Client») запуск без аргументов открывает базу в памяти, duckdb mayak.duckdb — файл базы, duckdb -c "SELECT …" выполняет одну команду и завершается, а флаг -csv переключает вывод в CSV. Запрос к файлу одной строкой терминала: duckdb -csv -c "SELECT channel, count(*) FROM '/tmp/mayak_users.csv' GROUP BY channel".
| Столбец | В базе | Из CSV | Из Parquet |
|---|---|---|---|
| payment_id | INTEGER | BIGINT | INTEGER |
| paid_at | DATE | DATE | DATE |
| amount | DECIMAL(10,2) | DOUBLE | DECIMAL(10,2) |
| plan | VARCHAR | VARCHAR | VARCHAR |
COPY (SELECT * FROM payments ORDER BY payment_id)
  TO '/tmp/mayak_payments.csv' (HEADER);

SELECT column_name, column_type
FROM (DESCRIBE SELECT * FROM read_csv('/tmp/mayak_payments.csv'));
Чем Parquet лучше CSV для аналитического запроса
Parquet — двоичный формат, в котором данные лежат по столбцам, сжаты и подписаны типами. Таблица событий учебной базы, 35 341 строка, занимает 1,4 МБ в CSV и около 0,4 МБ в Parquet, а типы после чтения совпадают с исходными.
Второе отличие — сколько приходится читать. По документации DuckDB («Reading and Writing Parquet Files») из файла берутся только столбцы, нужные запросу, а условие фильтра передаётся в чтение и позволяет пропускать части файла. В CSV ради одного столбца нужно разобрать каждую строку.
Чтобы увидеть разницу, мы сгенерировали 10 млн строк через range(), записали их в оба формата и посчитали число строк и сумму по четырём каналам. Замер сделан на ноутбуке с десятью ядрами и 16 ГБ памяти. DuckDB читал файл всеми ядрами, взят лучший из трёх запусков; pandas 2.3 без pyarrow читает CSV в один поток, запуск один. Строки таблицы сравнивают форматы и способы чтения на одной машине. Это порядок величин: коэффициент «DuckDB против pandas» из них выводить нельзя, на другом железе и других данных соотношение будет иным.
| Чем считали | Файл | Время |
|---|---|---|
| DuckDB | CSV, 407 МБ | около 0,25 с |
| DuckDB | Parquet, 107 МБ | около 0,01 с |
| pandas: read_csv двух столбцов и groupby | CSV, 407 МБ | около 2 с |
COPY (SELECT * FROM events ORDER BY event_id)
  TO '/tmp/mayak_events.parquet' (FORMAT parquet);

SELECT event_name, count(*) AS events
FROM read_parquet('/tmp/mayak_events.parquet')
GROUP BY event_name
ORDER BY events DESC;

-- app_open          | 28693
-- workspace_created |  2750
-- report_created    |  1775
-- invite_sent       |  1135
-- export_completed  |   988
DuckDB в Python: SQL-запрос к pandas DataFrame
В Python DuckDB видит DataFrame как таблицу: достаточно назвать в FROM имя переменной. Копировать данные в базу не нужно, документация называет этот механизм replacement scan. Метод .df() возвращает результат обратно в pandas, поэтому SQL встраивается в середину обычного ноутбука.
Так решается вопрос «как писать SQL в pandas». Соединения, оконные функции и условные агрегаты многим проще читать в SQL; сводные таблицы, графики и запись в Excel остаются за pandas. Переключаться можно на каждом шаге.
duckdb.sql(…) работает с базой в памяти: закрыли ноутбук — таблицы исчезли. Чтобы они пережили сессию, откройте файл: con = duckdb.connect('mayak.duckdb'), дальше con.sql(…).
С pandas 3 нужен DuckDB не старше 1.4.4. Более ранние версии не знают нового строкового типа pandas: на DataFrame с текстовым столбцом DuckDB 1.4.1 отвечает Data type 'str' not recognized. Помогает обновление DuckDB или приведение столбца: payments.astype({'plan': object}).
import duckdb
import pandas as pd

payments = pd.DataFrame({
    'user_id': [1, 1, 2, 3, 3, 3, 4],
    'plan':    ['basic', 'basic', 'pro', 'team', 'team', 'team', 'basic'],
    'amount':  [19, 19, 29, 39, 39, 39, 19],
})

# DataFrame виден запросу по имени переменной
by_plan = duckdb.sql("""
    SELECT plan,
           count(DISTINCT user_id)     AS payers,
           CAST(sum(amount) AS BIGINT) AS revenue  -- без CAST сумма придёт в pandas дробной: 117.0
    FROM payments
    GROUP BY plan
    ORDER BY revenue DESC
""").df()   # .df() возвращает обычный pandas DataFrame

print(by_plan)
#     plan  payers  revenue
# 0   team       1      117
# 1  basic       2       57
# 2    pro       1       29
print(type(by_plan).__name__, int(by_plan.revenue.sum()), int(payments.amount.sum()))
# DataFrame 203 203
Задача целиком: конверсия в оплату по каналам из двух выгрузок
Теперь рабочая задача. Есть две выгрузки, users и payments; нужно узнать, какая доля зарегистрированных из каждого канала заплатила хотя бы раз. Запрос соединяет два файла так же, как соединял бы две таблицы.
Окно регистраций выбрано по данным. Платный поиск в этой базе запущен 1 июля, остальные каналы работают с 1 июня, а первая оплата приходит через 3–20 дней после регистрации. Поэтому берём регистрации с 1 июля по 9 августа: период у каналов общий, и у каждого пользователя до конца выгрузки прошло не меньше 20 дней.
Результат: referral — 31,4% (141 из 449), organic — 25,5%, partner — 21,3%, paid_search — 10,8% (67 из 621). Между крайними каналами 20,6 п. п., 95%-й интервал разницы ±4,9 п. п. Без условия на даты тот же запрос даёт 26,8%, 23,5%, 17,0% и 8,5%: в знаменатель попадают регистрации последних трёх недель, для которых срок первой оплаты ещё не вышел, а у трёх каналов — ещё и июнь, которого у платного поиска нет.
В pandas та же задача — два read_csv, фильтр и groupby; числа совпадают. Чтобы блок выполнялся без учебной базы, он сам пишет две мини-выгрузки с её итогами по каналам: те же 4 613 пользователей и 912 плательщиков в окне и вне его, а даты регистрации и суммы оплат в них условные. Обратите внимание на parse_dates: DuckDB распознал дату сам, pandas без этого параметра оставит её текстом. Последние строки блока показывают обратный ход — SQL по уже отфильтрованному DataFrame.
Учебная база симулятора SQL-аналитика. Без фильтра дат конверсия ниже у каждого канала: в расчёт входят регистрации, для которых срок первой оплаты ещё не истёк.
COPY (SELECT * FROM users ORDER BY user_id)
  TO '/tmp/mayak_users.csv' (HEADER);
COPY (SELECT * FROM payments ORDER BY payment_id)
  TO '/tmp/mayak_payments.csv' (HEADER);

SELECT
  u.channel,
  count(*)                                       AS users,
  count(p.user_id)                               AS payers,
  round(100.0 * count(p.user_id) / count(*), 1)  AS conversion_pct
FROM read_csv('/tmp/mayak_users.csv') AS u
LEFT JOIN (
  SELECT DISTINCT user_id FROM read_csv('/tmp/mayak_payments.csv')
) AS p ON p.user_id = u.user_id
WHERE u.signup_date >= DATE '2026-07-01'
  AND u.signup_date <  DATE '2026-08-10'
GROUP BY u.channel
ORDER BY conversion_pct DESC;

-- referral    | 449 | 141 | 31.4
-- organic     | 780 | 199 | 25.5
-- partner     | 315 |  67 | 21.3
-- paid_search | 621 | 67 | 10.8import duckdb
import pandas as pd
# Мини-выгрузки с итогами учебной базы: регистрации и плательщики
# в окне 1 июля – 9 августа (in_*) и вне его (out_*)
duckdb.sql("""
CREATE OR REPLACE TEMP TABLE totals AS
SELECT * FROM (VALUES
('organic', 780, 199, 967, 211),
('paid_search', 621, 67, 394, 19),
('partner', 315, 67, 499, 71),
('referral', 449, 141, 588, 137)
) AS t(channel, in_users, in_payers, out_users, out_payers);
CREATE OR REPLACE TEMP TABLE gen AS
SELECT row_number() OVER (ORDER BY channel, signup_date, n) AS user_id, *
FROM (
SELECT channel, n, DATE '2026-07-01' + CAST(n % 40 AS INTEGER) AS signup_date,
n < in_payers AS pays
FROM totals, range(in_users) AS r(n)
UNION ALL
SELECT channel, n, DATE '2026-08-10' + CAST(n % 20 AS INTEGER), n < out_payers
FROM totals, range(out_users) AS r(n)
);
COPY (SELECT user_id, channel, signup_date FROM gen ORDER BY user_id)
TO '/tmp/mayak_mini_users.csv' (HEADER);
COPY (SELECT user_id, 19 AS amount FROM gen WHERE pays ORDER BY user_id)
TO '/tmp/mayak_mini_payments.csv' (HEADER);
""")
users = pd.read_csv('/tmp/mayak_mini_users.csv', parse_dates=['signup_date'])
payments = pd.read_csv('/tmp/mayak_mini_payments.csv')
mature = users[(users.signup_date >= '2026-07-01') & (users.signup_date < '2026-08-10')]
paid = mature.user_id.isin(payments.user_id)
out = paid.groupby(mature.channel).agg(users='size', payers='sum')
out['conversion_pct'] = (100 * out.payers / out.users).round(1)
print(out.sort_values('conversion_pct', ascending=False))
# users payers conversion_pct
# channel
# referral 449 141 31.4
# organic 780 199 25.5
# partner 315 67 21.3
# paid_search 621 67 10.8
# тот же DataFrame можно спросить на SQL — число то же
print(duckdb.sql("""
SELECT round(100.0 * count(*) FILTER (WHERE user_id IN (SELECT user_id FROM payments))
/ count(*), 1)
FROM mature
WHERE channel = 'referral'
""").fetchone()[0])
# 31.4Что в DuckDB короче, чем в PostgreSQL: GROUP BY ALL, median, arg_max
DuckDB понимает большую часть синтаксиса PostgreSQL и добавляет сокращения (часть из них собрана в разделе «Friendly SQL» документации). GROUP BY ALL группирует по всем столбцам SELECT, не обёрнутым в агрегат. median(x) считает медиану одной функцией. arg_max(a, b) возвращает a из строки, где b максимально. FILTER (WHERE …) считает агрегат по части строк; он есть и в PostgreSQL.
Запрос ниже сворачивает оплаты в дни и по каждому каналу считает дни с оплатами, медиану выручки в такие дни, лучший день и число дней с выручкой от $200. Это демонстрация синтаксиса, а не сравнение каналов: платный поиск стартовал на месяц позже, дней у него меньше.
В PostgreSQL каждое сокращение раскрывается: группировка — перечислением столбцов, медиана — percentile_cont(0.5) WITHIN GROUP, arg_max — первым элементом array_agg с сортировкой. NULLS LAST в ней нужен из-за пустых значений: arg_max их пропускает, а PostgreSQL при сортировке по убыванию ставит первыми. Второй блок выполнен в обоих движках и вернул одинаковые строки.
Ловушка — равные значения. У referral два дня с выручкой $231: 7 и 19 августа. arg_max(paid_at, revenue) без уточнения возвращает то один, то другой: в документации функция помечена как зависящая от порядка строк. Порядок задаётся внутри агрегата — ORDER BY paid_at закрепляет более ранний день. В PostgreSQL ту же роль играет второй ключ сортировки в array_agg: без него результат не гарантирован.
| channel | pay_days | median_day | best_revenue | best_day | days_over_200 |
|---|---|---|---|---|---|
| organic | 83 | 163 | 492 | 22 августа | 26 |
| paid_search | 46 | 48 | 175 | 28 августа | 0 |
| partner | 74 | 58 | 163 | 29 июля | 0 |
| referral | 81 | 106 | 231 | 7 августа | 5 |
WITH daily AS (
  SELECT u.channel, p.paid_at, sum(p.amount) AS revenue
  FROM payments p
  JOIN users u USING (user_id)
  GROUP BY ALL
)
SELECT
  channel,
  count(*)                                   AS pay_days,
  median(revenue)                            AS median_day,
  max(revenue)                               AS best_revenue,
  arg_max(paid_at, revenue ORDER BY paid_at) AS best_day,
  count(*) FILTER (WHERE revenue >= 200)     AS days_over_200
FROM daily
GROUP BY ALL
ORDER BY channel;WITH daily AS (
SELECT u.channel, p.paid_at, SUM(p.amount) AS revenue
FROM payments p
JOIN users u ON u.user_id = p.user_id
GROUP BY u.channel, p.paid_at
)
SELECT
channel,
COUNT(*) AS pay_days,
percentile_cont(0.5) WITHIN GROUP (ORDER BY revenue) AS median_day,
MAX(revenue) AS best_revenue,
(array_agg(paid_at ORDER BY revenue DESC NULLS LAST, paid_at))[1] AS best_day,
COUNT(*) FILTER (WHERE revenue >= 200) AS days_over_200
FROM daily
GROUP BY channel
ORDER BY channel;QUALIFY и SELECT * EXCLUDE: как убрать лишний подзапрос
QUALIFY фильтрует по результату оконной функции — так же, как HAVING фильтрует по агрегату. Типовая задача «первая оплата каждого пользователя» в стандартном SQL требует подзапроса: внутри посчитать ROW_NUMBER(), снаружи оставить строки с единицей. В PostgreSQL есть ещё DISTINCT ON, но это его собственное расширение, в стандарт оно не входит. В DuckDB условие пишется в том же запросе.
SELECT * EXCLUDE (…) возвращает все столбцы, кроме перечисленных. Это удобно, когда в таблице сорок столбцов, а лишних два. В PostgreSQL нужные столбцы придётся назвать по именам.
Оба блока возвращают одни и те же три строки: пользователи 6, 39 и 214, первая оплата $39 по тарифу team. Таблица собирает соответствия. Средний столбец — стандартная запись, которая работает в обоих движках; правый — что отвечает PostgreSQL 14 на сокращение.
| В DuckDB | Переносимая запись | PostgreSQL 14 на сокращение |
|---|---|---|
| GROUP BY ALL | перечислить столбцы в GROUP BY | синтаксическая ошибка |
| median(x) | percentile_cont(0.5) WITHIN GROUP (ORDER BY x) | ошибка: функции нет |
| arg_max(a, b) | (array_agg(a ORDER BY b DESC NULLS LAST, a))[1] | ошибка: функции нет |
| QUALIFY условие | подзапрос и WHERE снаружи | синтаксическая ошибка |
| SELECT * EXCLUDE (a) | список нужных столбцов | синтаксическая ошибка |
| FILTER (WHERE …) | та же запись | работает |
SELECT * EXCLUDE (payment_id, payment_type)
FROM payments
QUALIFY row_number() OVER (
  PARTITION BY user_id ORDER BY paid_at, payment_id
) = 1
ORDER BY amount DESC, user_id
LIMIT 3;SELECT user_id, paid_at, amount, plan
FROM (
SELECT
p.*,
ROW_NUMBER() OVER (
PARTITION BY user_id ORDER BY paid_at, payment_id
) AS rn
FROM payments p
) AS numbered
WHERE rn = 1
ORDER BY amount DESC, user_id
LIMIT 3;
-- 6 | 2026-06-17 | 39.00 | team
-- 39 | 2026-06-08 | 39.00 | team
-- 214 | 2026-06-27 | 39.00 | teamНа чём спотыкается перенос запроса из DuckDB в PostgreSQL
Запрос, отлаженный в DuckDB, на рабочем PostgreSQL может упасть или, что хуже, молча вернуть другое число. Таблица ниже — выражения, выполненные в обоих движках.
Опаснее всего деление: ошибки нет, а ответ другой. В учебной базе 1 251 платёж от 912 плательщиков, и «платежей на плательщика» получается 1,37 в DuckDB и ровно 1 в PostgreSQL. Вторая тихая разница — деление на ноль: 1 / 0 в DuckDB возвращает бесконечность, а PostgreSQL останавливает запрос ошибкой. Третья — numeric без точности: в DuckDB это DECIMAL(18,3), и 2 / 3.0 превращается в 0,667.
Остальные расхождения заметны сразу, потому что запрос падает. date_diff в PostgreSQL нет. Литерал '5' + 3 PostgreSQL молча считает восьмёркой, DuckDB просит явное приведение; с текстовым столбцом ошибку дают оба движка. Алиас из SELECT в WHERE DuckDB понимает — так он находит 68 первых оплат на третий день после регистрации, — а PostgreSQL отвечает, что столбца нет. Тип результата date_trunc от даты зависит даже от версии: DuckDB 1.4 возвращал DATE, DuckDB 1.5 возвращает TIMESTAMP, PostgreSQL — timestamp with time zone.
| Выражение | DuckDB | PostgreSQL |
|---|---|---|
| 7 / 2 | 3.5 | 3 |
| 7 // 2 | 3 | ошибка: оператора нет |
| 1 / 0 | inf | ошибка: division by zero |
| count(*) / count(DISTINCT user_id) по payments | 1.37 | 1 |
| CAST(2 / 3.0 AS numeric) | 0.667 | 0.66666666666666666667 |
| date_diff('day', d1, d2) | 89 | ошибка: функции нет |
| date_trunc('month', дата) | TIMESTAMP (в 1.4 — DATE) | timestamp with time zone |
| '5' + 3 (литерал) | ошибка: нужен явный CAST | 8 |
| алиас из SELECT в WHERE | работает | ошибка: column does not exist |
SELECT
  7 / 2                                                  AS division,        -- 3.5
  7 // 2                                                 AS int_division,    -- 3
  CAST(2 / 3.0 AS numeric)                               AS numeric_default, -- 0.667
  date_diff('day', DATE '2026-06-01', DATE '2026-08-29') AS days,            -- 89
typeof(date_trunc('month', DATE '2026-06-15')) AS month_type; -- TIMESTAMP (в DuckDB 1.4 — DATE)SELECT
7 / 2 AS division, -- 3
7 / 2.0 AS exact_division, -- 3.5000000000000000
CAST(2 / 3.0 AS numeric) AS numeric_default, -- 0.66666666666666666667
DATE '2026-08-29' - DATE '2026-06-01' AS days, -- 89
pg_typeof(date_trunc('month', DATE '2026-06-15')) AS month_type, -- timestamp with time zone
'5' + 3 AS text_plus_int; -- 8- Делите через
1.0 * a / b: дробный результат получится в обоих движках. - У
numericуказывайте точность:CAST(x AS numeric(18, 6)). - Дни между датами считайте вычитанием
d2 - d1, а кdate_truncдобавляйтеCAST(… AS DATE). - Условие по вычисленному столбцу выносите в подзапрос или CTE и не опирайтесь на алиас в
WHERE.
На каком движке работает учебная база курса
Задания симулятора SQL-аналитика и тренажёров КейсПрактики проверяет DuckDB: запрос ученика выполняется на сервере, проверка принимает один SELECT или WITH. При этом курсы учат SQL, совместимому с PostgreSQL, — тому, что встретится на рабочей базе. Поэтому в главах симулятора и в тренажёрах под вердиктом появляется замечание, если запрос держится на вольностях DuckDB: алиасе в WHERE, QUALIFY, GROUP BY ALL, median, arg_max или делении счётчика на счётчик.
Привычка отсюда простая. Считаете для себя в ноутбуке — пользуйтесь сокращениями. Пишете запрос, который уйдёт в отчёт на PostgreSQL или коллеге, — держитесь переносимой записи из двух таблиц выше.
Когда DuckDB не подходит
DuckDB рассчитан на аналитические запросы: агрегации и соединения по большой части таблицы («Why DuckDB»). Границы применимости документация называет сама.
- Много пишущих процессов. Раздел «Concurrency»: либо один процесс читает и пишет, либо несколько процессов открывают базу только на чтение. Запись из нескольких процессов требует сервера: либо протокол Quack, который превращает DuckDB в клиент-серверную базу и в документации версии 1.5.2 назван бета-версией, либо формат DuckLake с каталогом в PostgreSQL.
- Транзакционная нагрузка. Там же: когда два потока меняют одну строку, второй получает ошибку конфликта. Приложению с потоком коротких вставок и обновлений от многих клиентов нужна серверная СУБД.
- Данные больше одной машины. DuckDB считает на одном компьютере. Запрос, которому не хватило оперативной памяти, сбрасывается на диск (руководство «Tuning Workloads»), но с оговорками:
list(),string_agg()иPIVOTна диск не выгружаются. Данные, которые не помещаются на диск одной машины, — задача для распределённого хранилища.
Частые вопросы
DuckDB заменяет PostgreSQL? Нет, у них разная работа. PostgreSQL — сервер для приложения и общей базы команды, DuckDB — личный вычислитель для файлов и таблиц в памяти. Аналитик часто пользуется обоими: забирает выгрузку из рабочей базы и досчитывает локально.
Что учить новичку — DuckDB или PostgreSQL? Учите переносимый SQL: SELECT, соединения, агрегаты, окна одинаковы в обоих. Сокращения DuckDB — надстройка над ним, а привычку к 1.0 * при делении лучше выработать сразу.
Где DuckDB хранит данные? В памяти процесса либо в одном файле, который вы указали при подключении. Файлы CSV и Parquet он читает на месте и в базу не копирует.
Как выполнить SQL-запрос в Python без сервера базы данных? Установить duckdb и вызвать duckdb.sql(…). Запрос читает DataFrame по имени переменной или файл по пути, а .df() возвращает результат в pandas.
Как сохранить результат запроса? COPY (SELECT …) TO 'result.parquet' (FORMAT parquet) запишет файл, .df() в Python вернёт таблицу pandas.
Что читать дальше
DuckDB убирает расстояние между файлом и запросом: выгрузка, которую раньше приходилось загружать в базу или читать в pandas целиком, становится таблицей в FROM. Платить за это приходится вниманием к диалекту — делению, типам и сокращениям, которых нет в PostgreSQL.
Запросы статьи, кроме блоков с COPY и блока для PostgreSQL, выполняются в песочнице симулятора на той же учебной базе.
Материалы по теме
SQL или Python: что учить аналитику первым и где граница между ними
SQL и Python в работе аналитика данных: что учить первым, какие задачи решать запросом, а какие в pandas. Одна задача двумя способами на учебной базе и порядок изучения.
LATERAL JOIN в SQL: последняя запись, top-N на пользователя и функции в FROM
LATERAL JOIN на реальной учебной базе: последний платёж пользователя со всеми полями, разница между LEFT и CROSS, почему подзапрос с агрегатом никогда не отбрасывает строки, три последних события на человека, индекс, без которого LATERAL читает таблицу на каждой строке, и когда хватит GROUP BY, DISTINCT ON или окна.
Типы данных в SQL и CAST: конверсия равна нулю, сумма не сходится
Типы данных в SQL на учебной базе: INTEGER, DECIMAL, DOUBLE, DATE и TIMESTAMP, целочисленное деление, деньги в DECIMAL, round, текст в число и дату, CAST в WHERE.