Шпаргалка по SQL для аналитика: синтаксис и типовые запросы
Шпаргалка по SQL на одной странице: порядок выполнения запроса, фильтры, GROUP BY, JOIN, CTE, оконные функции, даты, NULL и метрики. Каждый пример выполнен, результат указан.
Содержание статьи
Шпаргалка по SQL — одна страница с тем, что аналитик пишет каждый день: фильтр, группировка, JOIN, CTE, оконные функции, даты, NULL и метрики в виде «задача → конструкция → пример». Запрос пишут в порядке SELECT … FROM … WHERE … GROUP BY … HAVING … ORDER BY … LIMIT, а база выполняет его начиная с FROM, и SELECT оказывается пятым шагом. Каждый пример выполнен на учебной базе симулятора SQL-аналитика в PostgreSQL 14 и DuckDB: числа в таблицах и подписях — результат запуска.
В каком порядке писать запрос и в каком он выполняется
Логический порядок объясняет, какие имена где видны: WHERE не знает алиас из SELECT, а ORDER BY знает. Разбор — в статье SQL с нуля: SELECT, FROM и WHERE.
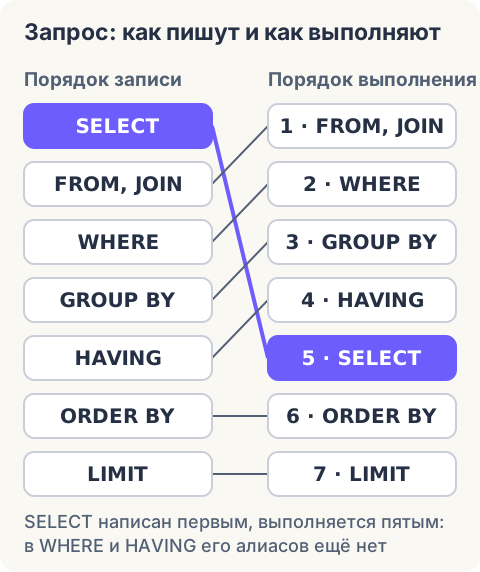
| Шаг | Часть запроса | Что делает | Что из этого следует |
|---|---|---|---|
| 1 | FROM, JOIN | собирает строки из таблиц | строки размножаются здесь, до всех фильтров |
| 2 | WHERE | отбирает строки | агрегатов и алиасов из SELECT ещё нет |
| 3 | GROUP BY | сворачивает строки в группы | дальше доступны ключи группы и агрегаты |
| 4 | HAVING | отбирает группы | условия на COUNT и SUM пишут сюда |
| 5 | SELECT | считает выражения и окна, затем DISTINCT | окно видит уже отобранные и сгруппированные строки |
| 6 | ORDER BY | сортирует результат | алиас из SELECT уже виден; в PostgreSQL — только вне выражений |
| 7 | LIMIT | оставляет первые N строк | без ORDER BY набор строк не определён |
Как выбрать, отфильтровать и отсортировать строки: SELECT, WHERE, ORDER BY
В примерах — таблицы учебной базы: users (4 613 регистраций), events (35 341 событие) и payments (1 251 оплата). Сравнения, AND, OR и скобки — в статье про операторы и логику: там выбор оператора по вопросу и что проверить, здесь — только запись и результат.
Разборы: ORDER BY и LIMIT, DISTINCT, BETWEEN, LIKE и ILIKE, строковые функции.
| Задача | Конструкция | Пример |
|---|---|---|
| Столбцы и алиас | SELECT col AS alias | SELECT user_id, signup_date AS registered FROM users |
| Условие на строки | WHERE … AND … | WHERE channel = 'organic' AND device = 'mobile' — 794 строки |
| Значение из списка | IN (…) | WHERE country IN ('KZ', 'BY') — 1 326 |
| Диапазон, обе границы входят | BETWEEN a AND b | WHERE amount BETWEEN 19 AND 29 — 1 109 оплат |
| Начало строки | LIKE 'pa%' | WHERE channel LIKE 'pa%' — 1 829: paid_search и partner |
| Уникальные значения | SELECT DISTINCT | SELECT DISTINCT channel FROM users — 4 строки |
| Первые N по порядку | ORDER BY … LIMIT n | ORDER BY signup_date DESC, user_id LIMIT 5 |
SELECT user_id, signup_date, country
FROM users
WHERE channel = 'organic'
  AND device = 'mobile'
  AND country IN ('KZ', 'BY')
  AND signup_date >= DATE '2026-08-01'
ORDER BY signup_date DESC, user_id
LIMIT 5;

-- условиям отвечает 81 строка; первые две:
-- 4577 | 2026-08-29 | BY
-- 4582 | 2026-08-29 | KZ
Как посчитать итог и разбить по группам: агрегаты, GROUP BY, HAVING
WHERE отбирает строки до группировки, HAVING — готовые группы. В первом запросе WHERE оставил только продления, а HAVING убрал тариф team, у которого их 40. Второй запрос считает первые оплаты и продления рядом: условие уходит из WHERE внутрь агрегата.
Разборы: агрегация и условные метрики, группировка по нескольким полям, HAVING, CASE WHEN, ROUND.
| Задача | Конструкция | Пример |
|---|---|---|
| Сколько строк | COUNT(*) | SELECT COUNT(*) FROM users — 4 613 |
| Сколько непустых значений | COUNT(col) | COUNT(country) — 4 558 |
| Сколько разных значений | COUNT(DISTINCT col) | COUNT(DISTINCT user_id) в payments — 912 |
| Сумма и среднее | SUM, AVG, MIN, MAX | SUM(amount) — 30 639, AVG(amount) — 24,49 |
| Условие на группу | HAVING | HAVING COUNT(*) >= 100 |
| Счётчик по условию | SUM(CASE …) или FILTER | COUNT(*) FILTER (WHERE payment_type = 'renewal') — 339 |
| Доля по условию | AVG(CASE … THEN 1.0 ELSE 0 END) | продления — 27,1% оплат |
SELECT
  plan,
  COUNT(*)                AS renewals,
  COUNT(DISTINCT user_id) AS payers,
  SUM(amount)             AS revenue
FROM payments
WHERE payment_type = 'renewal'   -- отбор строк
GROUP BY plan
HAVING COUNT(*) >= 100           -- отбор групп
ORDER BY revenue DESC;

-- basic | 192 | 165 | 3648.00
-- pro | 107 | 92 | 3103.00SELECT
plan,
COUNT(*) AS payments,
SUM(CASE WHEN payment_type = 'first' THEN 1 ELSE 0 END) AS first_payments,
COUNT(*) FILTER (WHERE payment_type = 'renewal') AS renewals,
ROUND(100.0 * AVG(CASE WHEN payment_type = 'renewal' THEN 1.0 ELSE 0 END), 1) AS renewal_pct
FROM payments
GROUP BY plan
ORDER BY plan;
-- basic | 706 | 514 | 192 | 27.2
-- pro | 403 | 296 | 107 | 26.6
-- team | 142 | 102 | 40 | 28.2Как соединить таблицы и не размножить строки: JOIN
Перед соединением назовите зерно каждой таблицы: что означает одна строка. users и payments связаны «один ко многим»: строк станет столько, сколько оплат. payments и events по user_id — «многие ко многим»: оплата повторяется на каждое событие пользователя, и 1 251 строка превращается в 11 667.
Лекарство — свести каждую таблицу фактов (много строк на пользователя: оплаты, события) к строке на пользователя и только потом соединять. Разборы: INNER и LEFT JOIN, JOIN без потерь и дублей, FULL и CROSS JOIN, UNION и UNION ALL.
| Задача | Конструкция | Пример |
|---|---|---|
| Только строки с парой | INNER JOIN | users u JOIN payments p ON p.user_id = u.user_id — 1 251 строка |
| Все строки левой таблицы | LEFT JOIN | то же с LEFT JOIN — 4 952 строки |
| Строки без пары | LEFT JOIN … WHERE p.user_id IS NULL | 3 701 пользователь без оплат |
| Фильтр правой таблицы | условие в ON | ON p.user_id = u.user_id AND p.plan = 'pro' — слева все 4 613 |
| Две таблицы фактов | агрегат до соединения | JOIN (SELECT user_id, SUM(amount) AS revenue FROM payments GROUP BY user_id) AS p ON p.user_id = u.user_id — 912 строк |
| Склеить результаты по вертикали | UNION ALL | SELECT user_id FROM payments UNION ALL SELECT user_id FROM subscriptions — 2 163 строки; UNION без ALL оставит 912 |
SELECT
  COUNT(*)      AS joined_rows,
  SUM(p.amount) AS inflated_revenue
FROM payments p
JOIN events e ON e.user_id = p.user_id;

-- 11667 | 284913.00
-- настоящая выручка: SELECT SUM(amount) FROM payments — 30639.00WITH pay AS (
SELECT user_id, SUM(amount) AS revenue
FROM payments
GROUP BY user_id
),
act AS (
SELECT user_id, COUNT(*) AS events
FROM events
GROUP BY user_id
)
SELECT
COUNT(*) AS users,
SUM(pay.revenue) AS revenue,
SUM(act.events) AS events
FROM users u
LEFT JOIN pay ON pay.user_id = u.user_id
LEFT JOIN act ON act.user_id = u.user_id;
-- 4613 | 30639.00 | 35341Когда хватит подзапроса, а когда нужен CTE
Подзапрос удобен для одного значения или списка. Когда шагов два и больше, их выносят в WITH: у шага появляется имя, и его можно выполнить отдельно. В примере первый шаг сводит оплаты к строке на пользователя, второй считает людей с одной, двумя и тремя оплатами.
Разборы: подзапросы: IN, EXISTS и подзапрос в FROM, EXISTS и IN, коррелированный подзапрос, CTE и WITH.
| Задача | Конструкция | Пример |
|---|---|---|
| Сравнить с итогом | скалярный подзапрос | WHERE amount > (SELECT AVG(amount) FROM payments) — 545 оплат |
| Фильтр по другой таблице | IN (SELECT …) | WHERE user_id IN (SELECT user_id FROM payments) — 912 |
| Есть связанная строка | EXISTS | WHERE EXISTS (SELECT 1 FROM payments p WHERE p.user_id = u.user_id) — 912 |
| Нет связанной строки | NOT EXISTS | 3 701; NOT IN вернёт пусто, если в списке есть NULL |
| Таблица из запроса | подзапрос в FROM | FROM (SELECT … GROUP BY user_id) AS t |
| Именованные шаги | WITH name AS (…) | WITH per_user AS (…) SELECT … FROM per_user |
WITH per_user AS (
  SELECT user_id, COUNT(*) AS payments, SUM(amount) AS revenue
  FROM payments
  GROUP BY user_id
)
SELECT
  payments,
  COUNT(*)     AS users,
  SUM(revenue) AS revenue
FROM per_user
GROUP BY payments
ORDER BY payments;

-- 1 | 622 | 15238.00
-- 2 | 241 | 11738.00
-- 3 |  49 |  3663.00
Как получить номер строки, прошлое значение и долю: оконные функции
Оконная функция считает по группе строк, но строки не сворачивает. PARTITION BY задаёт группу, ORDER BY внутри OVER — порядок, пустые скобки OVER () — весь результат.
Во втором запросе условие rn = 1 стоит во внешнем запросе: WHERE выполняется раньше окна. Разборы: оконные функции, PARTITION BY и OVER, LAG и LEAD, RANK и топ-N, строка с максимумом, дубликаты, рамка окна, процент и доля.
| Задача | Конструкция | Пример |
|---|---|---|
| Номер строки в группе | ROW_NUMBER() OVER (PARTITION BY … ORDER BY …) | первая оплата пользователя: rn = 1 |
| Предыдущая строка | LAG(x) OVER (ORDER BY …) | выручка прошлого месяца |
| Накопительный итог | SUM(x) OVER (ORDER BY …) | 3 983 → 14 851 → 30 639 |
| Доля от общего | 100.0 * x / SUM(x) OVER () | 13,0% · 35,5% · 51,5% |
| Доля внутри группы | 100.0 * x / SUM(x) OVER (PARTITION BY g) | mobile внутри organic — 45,4% |
| Скользящее среднее за 7 дней | AVG(x) OVER (ORDER BY d ROWS BETWEEN 6 PRECEDING AND CURRENT ROW) | регистраций в день на 29 августа — 72,0 |
WITH monthly AS (
  SELECT
    CAST(date_trunc('month', paid_at) AS DATE) AS month,
    SUM(amount) AS revenue
  FROM payments
  GROUP BY 1
)
SELECT
  month,
  revenue,
  LAG(revenue) OVER (ORDER BY month) AS prev_month,
  SUM(revenue) OVER (ORDER BY month) AS running_total,
  ROUND(100.0 * revenue / SUM(revenue) OVER (), 1) AS share_pct
FROM monthly
ORDER BY month;

-- 2026-06-01 |  3983.00 |     NULL |  3983.00 | 13.0
-- 2026-07-01 | 10868.00 |  3983.00 | 14851.00 | 35.5
-- 2026-08-01 | 15788.00 | 10868.00 | 30639.00 | 51.5SELECT plan, COUNT(*) AS first_payments
FROM (
SELECT
user_id,
plan,
ROW_NUMBER() OVER (
PARTITION BY user_id
ORDER BY paid_at, payment_id
) AS rn
FROM payments
) AS ranked
WHERE rn = 1
GROUP BY plan
ORDER BY first_payments DESC;
-- basic | 514
-- pro | 296
-- team | 102Как работать с датами: неделя, месяц, разница и период
Период задавайте полуоткрытым интервалом: начало входит, конец нет. BETWEEN включает обе границы, но на метке времени вторая граница — это полночь, и события 29 августа в выборку не попадают: 588 из 16 345.
date_trunc от даты возвращает не дату: в PostgreSQL — метку времени с часовым поясом, в DuckDB с версии 1.5 — TIMESTAMP (до 1.4 включительно — DATE). Поэтому результат приводят к DATE. Разборы: периоды, недели и календарь, функции даты, INTERVAL, ряд дат без пропусков.
| Задача | Конструкция | Пример |
|---|---|---|
| Начало месяца | CAST(date_trunc('month', d) AS DATE) | регистрации по месяцам: 1 042, 1 676, 1 895 |
| Начало недели, понедельник | CAST(date_trunc('week', d) AS DATE) | 29 августа 2026 → 24 августа |
| День из метки времени | CAST(event_time AS DATE) | в events 91 день |
| Разница в днях | d2 - d1 для двух дат | до первой оплаты — от 3 до 20 дней |
| Сдвиг на неделю | d + 7 или d + INTERVAL '7 days' | первое даёт дату, второе — метку времени |
| День недели, понедельник = 1 | EXTRACT(isodow FROM d) | 30 августа 2026 — 7 |
| Месяц целиком | d >= DATE '2026-08-01' AND d < DATE '2026-09-01' | 1 895 регистраций |
SELECT
  COUNT(*) FILTER (
    WHERE event_time BETWEEN TIMESTAMP '2026-08-01' AND TIMESTAMP '2026-08-29'
  ) AS between_rows,
  COUNT(*) FILTER (
    WHERE event_time >= TIMESTAMP '2026-08-01'
      AND event_time <  TIMESTAMP '2026-08-30'
  ) AS half_open_rows
FROM events;

-- 15757 | 16345
Что делать с NULL: IS NULL, COALESCE, NULLIF
NULL означает «значение неизвестно», и сравнение с ним даёт NULL, а в WHERE проходят только строки с истиной. Поэтому country <> 'RU' молча теряет 55 пользователей без страны: 1 843 строки вместо 1 898.
Агрегаты пропуски обходят: COUNT(country) видит 4 558 строк из 4 613. Разборы: NULL и COALESCE, NOT IN и NULL.
| Задача | Конструкция | Пример |
|---|---|---|
| Найти пропуски | IS NULL | WHERE country IS NULL — 55; с = NULL строк 0 |
| Сколько пропусков | COUNT(*) - COUNT(col) | 4 613 − 4 558 = 55 |
| Подставить значение | COALESCE(col, значение) | COALESCE(country, 'unknown') |
| «Не равно» вместе с NULL | IS DISTINCT FROM | country IS DISTINCT FROM 'RU' — 1 898 |
| Деление на возможный ноль | NULLIF(x, 0) | 100.0 * a / NULLIF(b, 0) — NULL вместо ошибки в PostgreSQL и Infinity в DuckDB |
| Пропуски в конце сортировки | NULLS LAST | ORDER BY country DESC NULLS LAST: без него при DESC PostgreSQL ставит NULL первым, DuckDB — последним |
SELECT
  COUNT(*)                  AS users,
  COUNT(country)            AS with_country,
  COUNT(*) - COUNT(country) AS missing,
  COUNT(*) FILTER (WHERE country <> 'RU')               AS not_ru,
  COUNT(*) FILTER (WHERE country IS DISTINCT FROM 'RU') AS not_ru_with_null
FROM users;

-- 4613 | 4558 | 55 | 1843 | 1898
Как записать метрику одной строкой: DAU, конверсия, D7, ARPU, ARPPU
У каждой метрики назовите действие и знаменатель, а потом проверьте, закрыт ли период. События 30 августа обрываются в 12:59, поэтому DAU посчитан по 29 августа: с неполным днём среднее падает с 486,9 до 478,1. В D7 когорта ограничена 22 августа: у более поздних регистраций седьмой день не закрыт или не наступил, и с ними выходит 19,1% вместо 21,4%. Первая оплата приходит через 3–20 дней, так что 19,77% занижены поздними регистрациями: среди зарегистрированных до 9 августа включительно платили 23,57%.
Разборы: продуктовые метрики запросами, DAU, когорты и retention, воронка, ARPU и ARPPU.
| Метрика | Запись | На учебной базе |
|---|---|---|
| DAU | COUNT(DISTINCT user_id) по CAST(event_time AS DATE) | в среднем 486,9 за 1–29 августа |
| Конверсия в оплату | 100.0 * COUNT(DISTINCT p.user_id) / COUNT(DISTINCT u.user_id) | 912 из 4 613 — 19,77% |
| Удержание D7 | 100.0 * COUNT(DISTINCT e.user_id) / COUNT(DISTINCT u.user_id), событие ровно в день signup_date + 7 | когорта по 22 августа: 881 из 4 109 — 21,4% |
| ARPU | SUM(p.amount) / COUNT(DISTINCT u.user_id) | 30 639 / 4 613 = 6,64 |
| ARPPU | SUM(p.amount) / COUNT(DISTINCT p.user_id) | 30 639 / 912 = 33,60 |
| Средний платёж | AVG(amount) | 30 639 / 1 251 = 24,49 |
SELECT
  COUNT(DISTINCT u.user_id) AS users,
  COUNT(DISTINCT p.user_id) AS payers,
  SUM(p.amount)             AS revenue,
  ROUND(100.0 * COUNT(DISTINCT p.user_id) / COUNT(DISTINCT u.user_id), 2) AS conversion_pct,
  ROUND(SUM(p.amount) / COUNT(DISTINCT u.user_id), 2) AS arpu,
  ROUND(SUM(p.amount) / COUNT(DISTINCT p.user_id), 2) AS arppu,
  ROUND(AVG(p.amount), 2)                             AS avg_payment
FROM users u
LEFT JOIN payments p ON p.user_id = u.user_id;

-- 4613 | 912 | 30639.00 | 19.77 | 6.64 | 33.60 | 24.49
-- в DuckDB arppu выводится как 33.6: ROUND от double не дописывает нольWITH daily AS (
SELECT CAST(event_time AS DATE) AS day, COUNT(DISTINCT user_id) AS dau
FROM events
WHERE event_time >= TIMESTAMP '2026-08-01'
AND event_time < TIMESTAMP '2026-08-30'
GROUP BY 1
),
d7 AS (
SELECT
COUNT(DISTINCT u.user_id) AS cohort,
COUNT(DISTINCT e.user_id) AS returned
FROM users u
LEFT JOIN events e
ON e.user_id = u.user_id
AND CAST(e.event_time AS DATE) = u.signup_date + 7
WHERE u.signup_date <= DATE '2026-08-22'
)
SELECT
(SELECT ROUND(AVG(dau), 1) FROM daily) AS avg_dau,
cohort,
returned,
ROUND(100.0 * returned / cohort, 1) AS d7_pct
FROM d7;
-- 486.9 | 4109 | 881 | 21.4Запрос выполнился, а число неверное: что проверить
Сообщение об ошибке хотя бы видно. Опаснее запрос, который выполнился и вернул правдоподобное число. Каждое «неправильное» число в таблице получено запуском на учебной базе. Тексты сообщений PostgreSQL — в статье ошибки в SQL-запросах, деление целых и метки времени — в типах данных и CAST, проверки данных — в чеклисте качества данных.
| Симптом | Причина | Исправление |
|---|---|---|
| Сумма после JOIN — 284 913 вместо 30 639 | две таблицы фактов соединены по user_id | агрегировать каждую до соединения |
| Доля равна 0 | в PostgreSQL 912 / 4613 — деление целых | 100.0 * 912 / 4613 — 19,77 |
| После LEFT JOIN осталось 296 пользователей из 4 613 | условие p.plan = 'pro' стоит в WHERE | перенести условие в ON |
| За период меньше строк: 15 757 вместо 16 345 | BETWEEN по метке времени обрезал последний день | полуоткрытый интервал: >= и < |
| Сегмент «не RU» меньше на 55 | <> не возвращает строки с NULL | IS DISTINCT FROM или OR country IS NULL |
| Последняя точка ряда «упала»: DAU 223 при среднем 486,9 | день не закрыт: события до 12:59 | считать по последний полный день |
Чем отличаются PostgreSQL, DuckDB, MySQL, SQL Server и ClickHouse
В таблице три расхождения с MySQL, SQL Server и ClickHouse по официальной документации: MySQL 8.4 Reference Manual, Microsoft Learn (Transact-SQL), ClickHouse Docs. Проверено 2 октября 2026 года, на живых серверах запросы не запускались.
Под таблицей — различия PostgreSQL 14 и DuckDB, каждое проверено запуском.
| Задача | PostgreSQL и DuckDB | MySQL 8.4 | SQL Server | ClickHouse |
|---|---|---|---|---|
| Первые 5 строк | ORDER BY … LIMIT 5 | ORDER BY … LIMIT 5 | SELECT TOP (5) … ORDER BY … | ORDER BY … LIMIT 5 |
| Склеить строки | a || b, CONCAT(a, b) | CONCAT(a, b); || по умолчанию означает OR | a + b, CONCAT(a, b); || — с версии 2025 | a || b, concat(a, b) |
| Начало месяца | CAST(date_trunc('month', d) AS DATE) | DATE_FORMAT(d, '%Y-%m-01') — строка; DATE_TRUNC в списке функций нет | DATETRUNC(month, d), с версии 2022 | toStartOfMonth(d), date_trunc('month', d) |
912 / 4613в PostgreSQL — 0, в DuckDB — 0,1977. Перед делением целых ставьте1.0 *.- Алиас из
SELECTвWHEREиHAVINGDuckDB принимает, PostgreSQL отвечаетcolumn "n" does not exist. Повторите выражение или вынесите шаг в CTE. ROUND(x, 2)от double precision в PostgreSQL не существует: приведите аргумент кnumeric.SELECT 1 / 0в PostgreSQL — ошибкаdivision by zero, DuckDB возвращает Infinity, и он молча ломает средние.
Частые вопросы
Что повторить по SQL перед собеседованием? Порядок выполнения запроса, разницу WHERE и HAVING, размножение строк в JOIN, ROW_NUMBER для первой записи в группе и поведение NULL. Задачи — в подборке SQL на собеседовании аналитика.
Подойдёт ли шпаргалка для MySQL и SQL Server? Запросы проверены только в PostgreSQL и DuckDB. В MySQL и SQL Server нет FILTER и NULLS LAST, в MySQL вместо IS NOT DISTINCT FROM пишут <=>, в SQL Server IS DISTINCT FROM — с версии 2022, а AVG от целых возвращает целое. Остальное — в таблице диалектов.
Чем COUNT(*) отличается от COUNT(столбец)? Первый считает строки, второй — непустые значения: 4 613 и 4 558 для country. COUNT(DISTINCT столбец) считает разные значения.
Где выполнить эти запросы? В песочнице симулятора: там та же учебная база.
Материалы по теме
SQL-запросы: 40 примеров для аналитика с результатами
Сорок SQL-запросов на одной учебной базе: SELECT и WHERE, COUNT и GROUP BY, JOIN, даты, оконные функции, DAU, retention и A/B-тест. У каждого запроса показан результат.
PARTITION BY и OVER в SQL: окно, группы и отличие от GROUP BY
PARTITION BY и OVER в SQL: окно и отличие от GROUP BY, доля от итога, накопительный итог, рамки ROWS и RANGE, фильтр по оконной функции.
SQL-задачи с решениями: 30 задач для аналитика на данных продукта
Тридцать SQL-задач с ответами и решениями на одной учебной базе: WHERE, GROUP BY, JOIN, даты, когорты и оконные функции. Каждый ответ можно проверить в песочнице.