Как стать аналитиком данных с нуля: навыки, план и первые задачи
Аналитик данных с нуля: что нужно знать на старте, план обучения по этапам с проверкой каждого и три первые рабочие задачи на учебной базе — с запросом, числом и оговоркой.
Содержание статьи
Чтобы стать аналитиком данных с нуля, нужно освоить пять навыков: SQL, расчёт метрик с понятным знаменателем и периодом, основы статистики, Python для того, чего не делает запрос, и умение объяснить число тому, кто принимает по нему решение. Первые четыре учат в этом порядке, пятый тренируют на каждой задаче. План ниже рассчитан на три–шесть месяцев при 4–6 часах практики в неделю; это срок занятий, работу к определённой дате он не обещает. В статье — маршрут целиком. Три первые рабочие задачи начинающего аналитика выполнены на учебной базе: вопрос, запрос, результат, оговорка. За ними — план по этапам с проверкой каждого, портфолио из одного разбора и карта материалов блога: что читать о резюме, откликах и собеседованиях.
Чем аналитик данных отличается от продуктового, BI- и системного аналитика?
Названия ролей в вакансиях плавают, поэтому сравнивать их надёжнее по двум вещам: с какого вопроса начинается работа и что остаётся после неё. Возьмём одну ситуацию. В отчёте о новом рекламном канале доля оплативших в два-три раза ниже, чем в остальных. Четыре роли возьмутся за неё с разных сторон: кто с чего начнёт и что отдаст, показывает таблица.
Первые три роли пользуются одними данными и одним SQL, различается результат. В небольшой компании все три может закрывать один человек. Системный аналитик — соседняя профессия: он описывает, как должна вести себя система, и запросы к данным для него вспомогательный инструмент.
Маршрут этой статьи рассчитан на аналитика данных и служит основой для продуктовой и BI-роли. Десять аналитических ролей сравнивает карта ролей. Неделю продуктового аналитика на той же базе, что и в этой статье, показывает разбор по дням, работу с отчётностью — статья о BI-аналитике.
| Роль | С какого вопроса начинает | Что отдаёт |
|---|---|---|
| Аналитик данных | Верно ли число: кого считали, за какой период, не размножились ли строки | Проверенный расчёт с определениями и оговорками |
| Продуктовый аналитик | Что мешает пришедшим из этого канала дойти до оплаты и что изменить | Рекомендацию команде продукта и проверку её эффекта |
| BI-аналитик | Почему в двух отчётах эта доля разная и как закрепить одно определение | Общий показатель и отчёт, который обновляется без ручного пересчёта |
| Системный аналитик | Как оплата записывается и передаётся между системами | Описание сценария и данных, по которому работает разработка |
Что должен знать аналитик данных на старте и что позже?
Список инструментов из вакансии мало говорит об уровне: «SQL» в ней значит и первый SELECT, и оконные функции. В таблице каждый навык описан через то, что вы умеете сделать. Стартовый уровень — то, что нужно для трёх задач ниже; следующий добирают уже в работе или под конкретную вакансию.
Таблицы — Excel или Google Таблицы — и BI-система отдельной строкой не стоят: в них подают результат и осваивают их по ходу, под вакансию. Порядок строк — порядок изучения. SQL идёт первым, потому что без него нечего считать и не на чем проверять статистику; почему Python идёт после SQL, разобрано в статье «SQL или Python».
По двум навыкам есть отдельные материалы: маршрут по SQL на шесть недель и статистика для аналитика с нуля. Здесь они не пересказаны: дальше — то, как навыки выглядят в работе.
| Навык | Старт: что вы умеете сделать | Следующий уровень | Где в этой статье |
|---|---|---|---|
| SQL | Перевести вопрос в запрос на чтение: фильтр, группировка, соединение таблиц, даты, расчёт по шагам; сверить число строк | Оконные функции, когорты, разбор чужих запросов | Все три задачи |
| Метрики | До расчёта назвать действие, знаменатель и период; не ставить неполный период рядом с полным | Воронки, удержание, выручка на пользователя, дерево метрик | Задачи 1 и 2 |
| Статистика | Отличить разницу от шума: доля, разброс, доверительный интервал для разницы долей | Проверка гипотез, размер выборки, разбор A/B-теста | Задача 2 |
| Python | В pandas — библиотеке Python для таблиц — прочитать данные, сгруппировать, посчитать интервал, построить график | Автоматизация отчёта, очистка файлов, модели | Задача 2 |
| Коммуникация | Уточнить вопрос до запроса; ответить в двух фразах и назвать ограничение | Обсуждать постановку с заказчиком, защищать вывод перед командой | Каждая задача |
Как выглядят первые рабочие задачи начинающего аналитика?
Сложного SQL в них почти нет. Трудность в другом: вопрос недоопределён, а первое полученное число выглядит правдоподобно и при этом отвечает на другой вопрос. Ниже три такие задачи. У каждой есть число «до проверки» и число после неё.
Все три решены на учебной базе симулятора SQL-аналитика. Это подписочный сервис «Маяк»: 4 613 регистраций с 1 июня по 29 августа 2026 года, события в продукте, платежи, подписки. Что лежит в каждой таблице, описано в путеводителе по базе. Данные синтетические: числа ниже показывают способ работы и ничего не говорят о настоящих продуктах. Каждый запрос выполнен в PostgreSQL 14 и в DuckDB с одинаковым результатом.
Задача 1. Сколько у нас пользователей, активных и платящих?
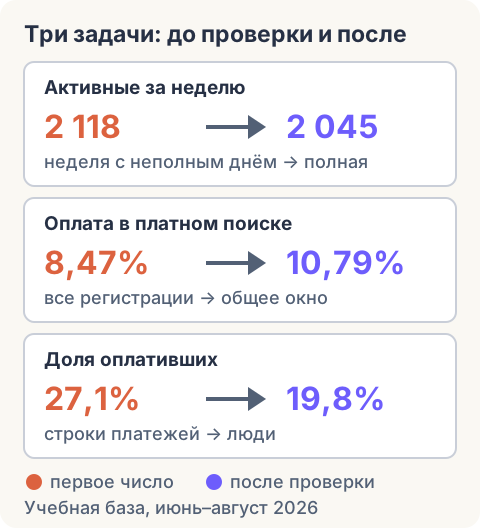
Менеджер просит три числа для презентации. Вопрос звучит как один, но в нём три определения. «Пользователи» — все зарегистрированные. «Активные» — кто и за какой период? «Платящие» — платившие хоть раз или те, у кого подписка действует сейчас? Договоримся так: активный — тот, кто открыл приложение (событие app_open) за последнюю полную календарную неделю, 17–23 августа. Платящих посчитаем обоими способами.
Запрос возвращает одну строку: 4 613 зарегистрированных, 2 045 активных за неделю, 912 плативших хотя бы раз и 515 действующих подписок.
Первая оговорка — период. Самая свежая неделя, 24–30 августа, дала бы 2 118 активных, но события за 30 августа записаны только до 12:59. Рядом с полными неделями это число ставить нельзя: оно посчитано за шесть с половиной дней и до конца недели может только вырасти.
Вторая — слово «платят». 912 и 515 отвечают на разные вопросы, и выбирает между ними заказчик. Ещё у 228 подписок платёж просрочен (past_due), 169 закрыты (churned). По какому правилу выставляется статус, спрашивают у владельца таблицы до того, как нести число: в учебной базе churned связан с активностью, а не с неоплатой — это разобрано в 12 рабочих вопросах аналитика.
Третья — само определение активности. Открытие приложения — слабый признак, для решений о продукте берут ключевое действие; об этом — статья о том, как считать активных пользователей.
Ответ менеджеру: «Зарегистрировано 4 613. За неделю 17–23 августа приложение открывали 2 045 человек. Платили хотя бы раз 912, действующих подписок 515. Текущую неделю не показываю: данные за 30 августа неполные».
SELECT
  (SELECT COUNT(*) FROM users) AS signups,
  (SELECT COUNT(DISTINCT user_id)
   FROM events
   WHERE event_name = 'app_open'
     AND event_time >= TIMESTAMP '2026-08-17'
     AND event_time <  TIMESTAMP '2026-08-24') AS active_week,
  (SELECT COUNT(DISTINCT user_id) FROM payments) AS ever_paid,
  (SELECT COUNT(*)
   FROM subscriptions
   WHERE status = 'active') AS active_subscriptions;

-- 4613 | 2045 | 912 | 515
Задача 2. Какой канал приводит платящих и на каком окне это считать?
Маркетинг спрашивает, из какого канала приходят те, кто платит. Метрика — доля зарегистрированных, у которых есть хотя бы одна оплата. Запрос по всем регистрациям даёт у платного поиска (paid_search) 8,47%, у рекомендаций (referral) 26,81% — разрыв в 3,2 раза.
Сравнивать эти числа нельзя. Платный поиск запущен 1 июля, остальные каналы работают с 1 июня. Первая оплата в этих данных приходит через 3–20 дней после регистрации, а оплаты записаны по 30 августа: у пришедших после 9 августа срок ещё не вышел, и в платном поиске таких 38,8% против примерно 28% в остальных каналах. Общее окно — регистрации с 1 июля по 9 августа, 2 165 человек: все четыре канала уже работали, и у каждого было не меньше 20 дней на оплату.
На общем окне доли выше у всех каналов, у платного поиска — 10,79% вместо 8,47%. Он остаётся последним, но отстаёт от рекомендаций уже в 2,9 раза.
Можно ли верить разнице, запрос не говорит: четыре строки результата переносим в Python. Между партнёрским каналом и платным поиском 10,48 процентного пункта (п. п.). 95%-й доверительный интервал — диапазон значений разницы, совместимых с данными, — от 5,34 до 15,62: ноль в него не попадает. Между органикой и партнёрами 4,24 пункта при интервале от −1,21 до 9,70: расставить эти два канала по местам данные не позволяют.
Доля оплативших — половина ответа: в базе нет расходов на рекламу, а без них не видно, окупается ли канал. Вывод для маркетинга: «На регистрациях 1 июля – 9 августа платный поиск конвертирует в оплату 10,79%, ближайший канал — 21,27%. Для решения о бюджете нужны расходы по каналам». Воронку канала, выручку на пользователя и порог окупаемости на тех же данных разбирает статья об оценке рекламного канала в SQL.
Учебная база. «Все регистрации» — с 1 июня по 29 августа, «общее окно» — с 1 июля по 9 августа.
SELECT u.channel,
       COUNT(DISTINCT u.user_id) AS signups,
       COUNT(DISTINCT p.user_id) AS payers,
       ROUND(CAST(100.0 * COUNT(DISTINCT p.user_id)
                  / COUNT(DISTINCT u.user_id) AS numeric(18, 6)), 2) AS paid_pct
FROM users u
LEFT JOIN payments p ON p.user_id = u.user_id
WHERE u.signup_date >= DATE '2026-07-01'
  AND u.signup_date <  DATE '2026-08-10'
GROUP BY u.channel
ORDER BY paid_pct DESC;

-- referral    | 449 | 141 | 31.40
-- organic     | 780 | 199 | 25.51
-- partner     | 315 |  67 | 21.27
-- paid_search | 621 | 67 | 10.79import numpy as np
import pandas as pd
# четыре строки, которые вернул запрос выше
s = pd.DataFrame({
'channel': ['referral', 'organic', 'partner', 'paid_search'],
'signups': [449, 780, 315, 621],
'payers': [141, 199, 67, 67],
}).set_index('channel')
s['share'] = s['payers'] / s['signups']
s['var'] = s['share'] * (1 - s['share']) / s['signups']
def diff(a, b):
"""Разница долей a − b и границы 95%-го интервала, в процентных пунктах."""
d = s.loc[a, 'share'] - s.loc[b, 'share']
half = 1.96 * np.sqrt(s.loc[a, 'var'] + s.loc[b, 'var'])
return [round(float(100 * v), 2) for v in (d, d - half, d + half)]
print('partner − paid_search:', diff('partner', 'paid_search'))
print('organic − partner:', diff('organic', 'partner'))
# partner − paid_search: [10.48, 5.34, 15.62]
# organic − partner: [4.24, -1.21, 9.7]Задача 3. Как проверить чужое число?
В недельном отчёте коллеги написано: «оплатили 27,1% зарегистрированных». В первой задаче у вас вышло 912 плативших из 4 613 — это 19,8%. Сверка двух чисел начинается с попытки воспроизвести чужое.
27,1% получается, если соединить пользователей с платежами и поделить число строк с платежом на число пользователей: 1 251 на 4 613. Проверочный запрос считает после соединения отдельно строки и отдельно людей.
Строк после соединения 4 952 при 4 613 пользователях. Лишние 339 строк — продления: каждый платёж даёт свою строку, и человек с тремя платежами посчитан трижды. Второй запрос показывает, как платежи распределены по людям: 622 человека платили один раз, 241 — дважды, 49 — трижды. Сверка сходится: 622 + 241 + 49 = 912 человек, 622 + 482 + 147 = 1 251 платёж.
В арифметике у коллеги ошибки нет. 27,1 — это платежей на сто регистраций, 19,8% — доля людей, плативших хотя бы раз; неверна подпись в отчёте. В разрезе по каналам та же подмена превращает 410 плательщиков органики в 566. Коллеге пишут без оценок: какой запрос даёт какое число и какое определение стоит в заголовке.
У вашего числа тоже есть оговорка: 19,8% занижены поздними регистрациями — из второй задачи известно, что у пришедших после 9 августа срок первой оплаты ещё не вышел. Как соединять таблицы, чтобы строки не размножались, показано в статье о JOIN без потерь и дублей; другие ошибки, которых не видно по результату, — в разборе ошибок в SQL-запросах.
SELECT COUNT(*) AS rows_after_join,
       COUNT(DISTINCT u.user_id) AS users,
       COUNT(p.payment_id) AS payment_rows,
       COUNT(DISTINCT p.user_id) AS payers
FROM users u
LEFT JOIN payments p ON p.user_id = u.user_id;

-- 4952 | 4613 | 1251 | 912SELECT n_payments,
COUNT(*) AS payers,
SUM(n_payments) AS payments
FROM (
SELECT user_id, COUNT(*) AS n_payments
FROM payments
GROUP BY user_id
) per_user
GROUP BY n_payments
ORDER BY n_payments;
-- 1 | 622 | 622
-- 2 | 241 | 482
-- 3 | 49 | 147План обучения на 3–6 месяцев: что уметь к концу каждого этапа?
План — последовательность умений. У каждого этапа есть проверка: у первых четырёх — вопрос к учебной базе с известным ответом, у пятого — ваш собственный разбор. Пока ответ не сходится, этап не закончен, сколько бы уроков ни было пройдено.
Сроки — ориентир при 4–6 часах практики в неделю: в сумме от 13 до 26 недель, то есть от трёх до шести месяцев. С опытом в Excel или программировании первые этапы идут быстрее; при двух часах в неделю план растянется как минимум вдвое. Конец плана и выход на работу — разные даты: отбор от вашего календаря не зависит.
Первые три этапа — те же шесть–восемь недель, что и маршрут в статье «Как выучить SQL с нуля»: там у каждой недели свой контрольный запрос. Для четвёртого этапа порядок тем по Python описан в «SQL или Python», расчёт интервала — в статье о доверительном интервале.
Где практиковаться. Этапы 1–2 закрывает тренажёр «SQL с нуля»: девять модулей и 91 задача с проверкой на базе авиаперевозок, первые три модуля открыты без оплаты. Этапы 2–3 — симулятор SQL-аналитика на базе из этой статьи: 18 глав и 54 задания, бесплатны главы 0–2 и глава 6 — первый кейс с метрикой. Курс «Продвинутый SQL» относится к следующему уровню из таблицы навыков: оконные функции, сессии, качество данных, эксперименты. Тот же путь проходят и по книге с открытыми данными, и на других площадках: их разбирает сравнение тренажёров и песочниц.
| Этап | Ориентир | К концу этапа вы умеете | Проверка на учебной базе |
|---|---|---|---|
| 1. Таблицы и первые запросы | 3 недели | Отобрать строки, посчитать по группам, отличить строки от людей | 4 613 регистраций; 1 251 платёж и 912 плательщиков |
| 2. Соединения, даты, расчёт по шагам | 2–3 недели | Соединить таблицы без размножения строк, задать окно дат, разбить запрос на шаги | Доля оплативших в платном поиске на общем окне — 10,79% |
| 3. Метрики | 1–2 недели | Определить активность, конверсию и удержание: действие, знаменатель, период | Активных за 17–23 августа — 2 045; на следующий день вернулись 53,42% зарегистрированных по 28 августа |
| 4. Статистика и Python | 4–10 недель | Посчитать интервал для разницы долей, повторить расчёт в pandas, построить график | Партнёры минус платный поиск: 10,48 п. п., интервал от 5,34 до 15,62 |
| 5. Разбор, резюме, пробные собеседования | 3–8 недель | Оформить один разбор, объяснить его вслух, решить незнакомую задачу без подсказки | Свой вопрос к базе, ответа на который нет в этой статье: запрос, число, оговорка |
Как собрать портфолио из одной учебной базы?
Сертификат сообщает, что курс пройден. Разбор показывает, как вы работаете: какой вопрос поставили, чем проверили число и где остановились. Его можно открыть на собеседовании, и по нему есть о чём спросить. От решённой задачи курса его отличают проверка, которая могла опровергнуть результат, и названное ограничение.
В разборе шесть коротких частей: вопрос, определения, результат, проверки, вывод, ограничения. Вторая задача этой статьи в таком виде занимает полстраницы. Это первый экран README — файла с описанием проекта; под ним лежат запрос и расчёт интервала.
Ответы на вопросы этой статьи опубликованы, поэтому в портфолио идёт вопрос, ответа на который здесь нет, — например, тот же расчёт по странам регистрации, с отдельным решением, что делать с 55 пользователями без страны.
Из одной базы получаются все три типа проекта, которые описывает статья «Аналитик данных без опыта»: метрика — вторая задача, качество данных — третья, решение — разбор A/B-теста из той же базы. Начните с одного и доведите его до записки; остальные собираются по тому же каркасу. Требования к репозиторию и README — в той же статье, а как сдавать похожую работу на отборе — в разборе тестового задания.
Вопрос
  Какой канал привлечения приводит пользователей, которые платят?

Данные и определения
  Учебная база «Маяк» (синтетическая), таблицы users и payments.
  Оплатил — есть хотя бы одна строка в payments.
  Окно — регистрации 1 июля – 9 августа 2026: работали все четыре
  канала, у каждого пользователя было не меньше 20 дней на оплату.

Результат
  referral 31,40% · organic 25,51% · partner 21,27% · paid_search 10,79%
  partner − paid_search: 10,48 п. п., 95%-й интервал от 5,34 до 15,62

Проверки
  По всем регистрациям у paid_search 8,47%: занижено поздними
  регистрациями. Считаю людей: строк платежей 1 251, плательщиков 912.

Вывод
  Платный поиск конвертирует в оплату вдвое хуже ближайшего канала.
  Органику и партнёров эти данные не различают.

Ограничения
  В базе нет расходов: окупаемость канала оценить нельзя.
  Данные учебные: разбор показывает метод, о реальном продукте
  по нему судить нельзя.
Резюме и первые отклики: когда начинать и что писать?
Отклики не обязаны ждать конца плана. Когда в начале пятого этапа оформлен первый разбор, у вас есть запросы, которые вы можете объяснить, и работа, которую можно показать. С этим уже можно идти на первые разговоры, а вопросы на них покажут, что доучивать.
В резюме разбор становится одним пунктом с пометкой «учебный»: «Учебный проект на синтетической базе подписочного сервиса: посчитал долю оплативших по каналам на общем окне регистраций; показал, что расчёт по всем регистрациям занижает новый канал (8,47% против 10,79%); оценил разницу доверительным интервалом. SQL, pandas». В пункте есть действие, метод и проверяемый итог, и нет роста выручки, которого не было. Структура файла и примеры «до и после» для трёх ролей — в статье о резюме аналитика.
Что читать перед откликами. «Аналитик данных без опыта» — где искать первую работу, как читать требования, как использовать опыт из другой профессии и что отвечать на «у вас нет опыта». Статья о стажировках — чем стажировка отличается от стартовой штатной роли и как проходит отбор. Грейды аналитика — чего ждут от начинающего: ограниченной задачи с готовыми определениями и регулярной обратной связью.
Собеседования: к каким этапам готовиться и по каким материалам?
Состав этапов задаёт компания, и узнать его можно только из вакансии или у рекрутера. В таблице — виды проверок, к которым есть смысл готовиться аналитику данных, и материал к каждой; ссылки стоят под таблицей в том же порядке.
Три задачи этой статьи годятся как тренировка технической части. Объясните вслух, почему 27,1 и 19,8% получены из одних данных и чем различаются; почему 8,47% у платного поиска нельзя ставить рядом с другими каналами; что вы спросили бы у менеджера до первого запроса. Хороший признак — объяснение укладывается в минуту и не требует открывать код.
| Проверка | Что вы показываете | Материал блога |
|---|---|---|
| Рассказ о себе | Одну линию: кто вы, какой проект сделали, почему эта роль | «Как рассказать о себе на собеседовании» |
| Вопросы по SQL | Как база считает: NULL, JOIN, порядок выполнения | «Вопросы по SQL на собеседовании» |
| SQL-задача | Запрос и проверку результата вслух | «SQL-задачи с решениями» |
| Вопросы о метриках и кейс | Уточнение вопроса, знаменатель, вывод с оговоркой | «Собеседование аналитика данных: 30 задач» |
| Тестовое задание | Короткую записку и расчёт, который можно повторить | «Тестовое задание аналитика» |
| Поведенческое интервью | Конкретный эпизод: что сделали именно вы | «Метод STAR» |
Частые вопросы о старте в аналитике данных
Можно ли стать аналитиком данных с нуля самостоятельно?
Можно, если есть три вещи: данные, на которых ответ проверяется, план с контрольной точкой на каждом этапе и человек, который прочитает ваш разбор и задаст вопросы. Курс даёт последовательность и проверку; решать задачи за вас не будет ни один формат.
Сколько времени занимает обучение аналитике данных с нуля?
Ориентир — от трёх до шести месяцев при 4–6 часах практики в неделю: к этому сроку задачи из этой статьи решаются без подсказки. Когда после этого появится работа, план не определяет.
Что должен знать аналитик данных, чтобы справиться с первыми задачами?
SQL до соединений и дат; определение метрики — действие, знаменатель, период; долю и доверительный интервал; pandas на уровне группировки; вывод в двух фразах с ограничением.
Нужна ли аналитику данных высшая математика?
Для задач этой статьи хватило арифметики долей и одной формулы интервала. Теория вероятностей и проверка гипотез понадобятся для экспериментов — это следующий уровень из таблицы навыков.
С чего начать, если вы никогда не работали с данными: с Excel, SQL или Python?
С SQL: первые рабочие вопросы — «сколько» и «какая доля» — решаются запросом к базе. Таблицы пригодятся для подачи результата, Python — на четвёртом этапе плана.
Подойдёт ли для портфолио проект на синтетических данных?
Да, если это прямо сказано. Такой проект показывает метод — определения, запрос, проверку, ограничение, — а расчёт на открытой учебной базе может повторить любой проверяющий.
Что сделать сегодня и что читать дальше?
Откройте песочницу симулятора SQL-аналитика: она работает на этой же базе, и запросы статьи выполняются в ней как есть. Начните с первой задачи, затем замените неделю на 10–16 августа — активных должно получиться 1 964. В запросе второй задачи уберите верхнюю границу окна: у платного поиска выйдет 8,47%. Если оба числа сошлись и вы можете объяснить, откуда второе, первый шаг маршрута сделан.
Дальше — по карте: SQL по неделям, двенадцать рабочих вопросов для практики и путь к первому отклику.
Материалы по теме
Аналитик данных без опыта: путь к первой работе
Аналитик данных без опыта — как подойти к первой работе: какие навыки освоить, как собрать два-три честных проекта и портфолио, где искать стартовые вакансии и как пройти отбор.
SQL или Python: что учить аналитику первым и где граница между ними
SQL и Python в работе аналитика данных: что учить первым, какие задачи решать запросом, а какие в pandas. Одна задача двумя способами на учебной базе и порядок изучения.
Тестовое задание аналитика: решение, оформление и границы работы
Как выполнить тестовое задание аналитика: вопросы к условию, структура сдачи и полный учебный пример на базе авиаперевозок с проверенным SQL, числами и запиской.