Блэнд: An Introduction to Medical Statistics
Обзор четвёртого издания книги Мартина Блэнда: согласие измерений, каппа и неопределённость. Три собственных расчёта Python с переносом в продукт.
Содержание статьи
Два прибора выдают почти идеально связанные показания. Можно ли заменить один другим? Корреляция на этот вопрос не отвечает. An Introduction to Medical Statistics Мартина Блэнда помогает выбрать более широкий маршрут: от дизайна исследования к оценке и интерпретации, включая отдельную тему клинических измерений. Ниже — обзор проверенного издания и три наших расчёта, которые переводят эту задачу в понятные числа.
Короткий ответ: что искать у Блэнда
- Рассматриваем четвёртое английское издание 2015 года. Оно подходит для последовательного знакомства со статистическими вопросами медицинских исследований.
- Для практикума выбираем измерения: разности двух приборов, согласие двух экспертов и планирование точности среднего смещения.
- Сильная корреляция, высокий процент совпадений и узкий интервал — разные характеристики. Ни одна не заменяет содержательного допуска на ошибку.
Библиографическая карточка и доступ
Автор — Martin Bland, Мартин Блэнд. Название — An Introduction to Medical Statistics, четвёртое издание, Oxford University Press, 2015, ISBN 9780199589920. Сведения и оглавление проверены в Google Books. Русский перевод этого издания в рамках работы не подтверждён; «Введение в медицинскую статистику» используем лишь как перевод смысла названия.
Оценка основана на издательском описании и доступном оглавлении, а не на постраничном чтении полного учебника. Для раздела о согласии дополнительно использована оригинальная работа Блэнда и Альтмана 1986 года, размещённая на университетской странице автора. Примеры, таблицы и код в этом материале наши, данные придуманы специально для объяснения.
Адресат по описанию книги — читатель медицинской литературы, которому требуется понимать и критически оценивать статистические результаты. Наша оценка необходимой подготовки: дроби, проценты, среднее и способность читать график с двумя осями. Для самостоятельных расчётов пригодятся стандартное отклонение, квадратный корень и представление о случайной выборке.
Как устроено обучение в книге
Начальные главы связывают эксперимент и наблюдательное исследование с описанием данных. Затем появляются вероятность, оценивание и проверки, сравнения и связи переменных. В поздней части оглавления есть несколько факторов, время до события, метаанализ, размер выборки, пропуски и клинические измерения. Этот охват удобен для перехода от чтения результата к проверке его основания.
Наличие специальных тем не означает, что новичку нужно читать всё за один заход. Для первой исследовательской задачи выберите одну ветку и вернитесь к базовым определениям по мере необходимости. Например, сравнение двух измерителей требует понять разность, разброс разностей и допустимую ошибку, прежде чем обсуждать сложную модель калибровки.
В нашем маршруте ключевой вопрос звучит так: что вы собираетесь делать с числом? Для ранжирования участников высокая корреляция может быть полезной характеристикой. Для замены прибора нужно оценить величину расхождений. Для автоматической разметки категорий интересует согласие решений. Различие задач определяет расчёт сильнее, чем название столбца.
Идея 1. Корреляция не измеряет взаимозаменяемость
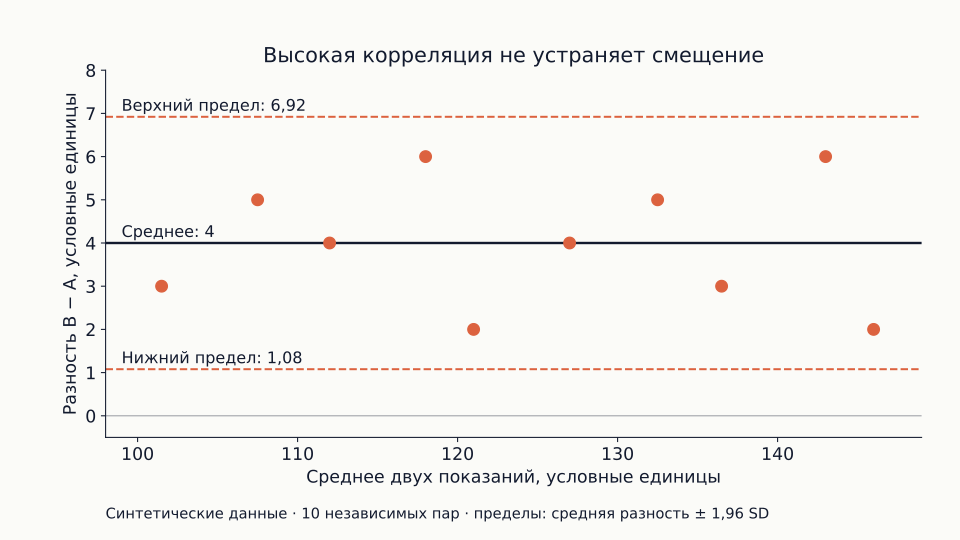
Возьмём десять условных людей. Прибор A выдаёт значения от 100 до 145 с шагом 5 в условных единицах. Прибор B даёт результат выше на величину от 2 до 6. Корреляция Пирсона между рядами равна 0,995140. Но среднее B − A равно 4: второй прибор систематически смещён относительно первого.
Корреляция описывает совместное изменение значений. Если один прибор к каждому показанию добавит константу, порядок и линейная связь сохранятся, а абсолютное совпадение исчезнет. Поэтому почти единичное r не является доказательством, что два способа измерения можно без последствий смешивать в одной истории наблюдений.
Сравнение разностей с их средним уровнем — основа подхода Блэнда — Альтмана. Здесь среднее смещение равно 4, а оценённые пределы согласия по формуле «средняя разность ± 1,96 стандартного отклонения разностей» равны 1,078205 и 6,921795. Это приближённое описание диапазона индивидуальных расхождений при подходящих предпосылках.
| Расчёт | Значение | Вопрос |
|---|---|---|
| Корреляция | 0,995140 | Насколько линейно связаны ряды? |
| Среднее B − A | 4 | Каково среднее смещение? |
| Пределы согласия | 1,078205…6,921795 | Каков приближённый разброс индивидуальных разностей? |
| 95% интервал среднего смещения | 2,933609…5,066391 | Насколько точно оценено среднее? |
Python: смещение, пределы и интервал
Каждый пример можно запускать отдельно: все входные значения заданы внутри блока, внешние файлы не нужны. Для расчётов этой статьи установите пакеты командой python -m pip install numpy scipy. Код проверен с Python 3.12; точные версии библиотек и результаты сохранены в отчёте подготовки материала. При изменении данных заново проверьте допущения, а не только успешное выполнение команды.
Код также считает 95% t-интервал для среднего смещения: от 2,933609 до 5,066391. Он отвечает на вопрос о неопределённости средней разности. Пределы согласия отвечают на другой вопрос — о разбросе разностей отдельных измерений. Сравнивать их ширину как две конкурирующие оценки одной величины нельзя.
Для учебной проверки заранее зададим допуск ±2 условные единицы. В него попали только два наблюдения из десяти. Ни этот допуск, ни единицы не имеют клинического значения: они придуманы для примера. В реальном проекте допустимое расхождение определяют из последствий измерительной ошибки до того, как увидят красивый график.
Десять наблюдений слишком мало для уверенной валидации прибора. Сами пределы согласия тоже оценены с ошибкой, которую здесь отдельно не рассчитываем. Приближённая формула предполагает независимые пары, разумно стабильный разброс и подходящее распределение разностей. Для повторов у одного человека или растущего с уровнем разброса требуется другой план анализа.
import numpy as np
from scipy.stats import pearsonr, t
# Условные показания двух приборов у десяти разных людей.
a = np.arange(100., 150., 5.)
d = np.array([3., 5., 4., 6., 2., 4., 5., 3., 6., 2.])
b = a + d
bias = d.mean()
sd = d.std(ddof=1)
loa = bias + np.array([-1, 1]) * 1.96 * sd
bias_ci = bias + np.array([-1, 1]) * t.ppf(.975, len(d)-1)*sd/np.sqrt(len(d))
print("correlation", round(pearsonr(a, b).statistic, 6))
print("bias", bias, "limits", np.round(loa, 6))
print("bias_ci95", np.round(bias_ci, 6))
print("within_plus_minus_2", int((np.abs(d)<=2).sum()), "of", len(d))
Как читать график разностей
По горизонтали обычно откладывают среднее двух измерений пары, по вертикали — их разность с заранее выбранным знаком. Если знак поменять, смещение и пределы отразятся относительно нуля. Это не изменение данных, но без подписи читатель легко решит, что завышает уже другой прибор.
Ищите зависимость разности от уровня. Наклон может указывать на пропорциональное расхождение, а веер — на меняющийся разброс. Тогда единый абсолютный допуск может описывать низкие и высокие значения по-разному. Иногда содержательно уместны отношения или логарифмы, но преобразование выбирают по смыслу ошибки, а не для украшения картинки.
В продукте такие пары возникают при сравнении двух SDK, систем атрибуции или счётчиков времени. Если один счётчик постоянно добавляет задержку, он может прекрасно коррелировать со старым. Перед миграцией оцените расхождения на сопоставимых событиях и сегментах. Пропуски, разные часовые пояса и неодинаковые правила сессии способны создать проблему ещё до статистики.
Идея 2. Одинаковый процент согласия даёт разную каппу
Теперь два условных эксперта независимо присваивают метку «да» или «нет» одним и тем же объектам. В первой таблице они согласны в 90 случаях из 100, причём оба примерно поровну используют две категории. Наблюдаемое согласие равно 0,9, ожидаемое по произведению маргинальных долей — 0,5. Каппа Коэна равна 0,8.
Во второй, отдельной синтетической выборке согласие тоже 90%, но каждый эксперт значительно чаще ставит «да». Ожидаемое по маргинальным долям согласие теперь 0,82, а каппа равна 0,444444. Это следствие определения показателя: он учитывает не только диагональ таблицы, но и частоты категорий у каждого эксперта.
| Набор | Оба да | A да / B нет | A нет / B да | Оба нет |
|---|---|---|---|---|
| Сбалансированный | 45 | 5 | 5 | 45 |
| Преобладает «да» | 85 | 5 | 5 | 5 |
Python: две таблицы согласия
Не следует объявлять второй набор автоматически «плохим» лишь по меньшей каппе. Сначала посмотрите, какие категории редки, где лежат разногласия и каковы их последствия. Универсальные словесные шкалы вроде «умеренное» и «отличное» скрывают эти детали. Показатель полезнее сообщать вместе с таблицей частот и процентом совпадений.
Каппа в этом примере не оценивает диагностическую точность. У нас нет эталона истинного состояния, только две разметки. Эксперты могут соглашаться и одновременно ошибаться. Если есть отдельный надёжный эталон, появляются другие вопросы и показатели: чувствительность, специфичность и матрица ошибок относительно этого эталона.
Для аналитика аналог — проверка разметки обращений или причин отмены заказа. До расчёта нужно дать экспертам одинаковые определения категорий, сопоставить объекты по ключу и решить, как обрабатывается «не могу определить». Удаление спорных объектов способно искусственно повысить согласие, поэтому их число и правило исключения должны быть видны.
Если категории упорядочены, обычная каппа не различает близкие и далёкие ошибки. Можно рассматривать взвешенные варианты, но веса тоже являются содержательным решением. Для независимого повторения результата одного слова «каппа» недостаточно: нужны версия показателя, таблица и правила работы с отсутствующими ответами.
import numpy as np
# Строки — эксперт A (да/нет), столбцы — эксперт B (да/нет).
# Две разные синтетические выборки, не один и тот же набор людей.
for table in [np.array([[45, 5], [5, 45]]), np.array([[85, 5], [5, 5]])]:
    n = table.sum()
    observed = np.trace(table)/n
    expected = (table.sum(axis=0) * table.sum(axis=1)).sum()/n**2
    kappa = (observed-expected)/(1-expected)
    print("agreement", observed, "chance", round(expected, 3), "kappa", round(kappa, 6))
Идея 3. Размер выборки можно планировать под точность
Допустим, цель отдельного исследования — оценить среднее смещение двух приборов с заданной полушириной интервала. Из внешних предварительных данных условно принимаем стандартное отклонение разностей равным 2. Для нормальной аппроксимации 95% интервала целевая полуширина 1 требует примерно 16 независимых пар, а 0,5 — примерно 62.
Это самостоятельная планировочная задача, не продолжение десяти наблюдений выше. Мы намеренно задаём стандартное отклонение извне, чтобы не выдавать нестабильную оценку маленького примера за надёжную основу нового исследования. Полуширина вдвое меньше требует примерно вчетверо большего объёма, потому что стандартная ошибка уменьшается как корень из n.
Python: предварительный расчёт точности
Полученные 16 и 62 — округлённые вверх ориентиры по нормальной аппроксимации. При небольшом n замена нормального квантиля на t-квантиль увеличит требуемый объём. Также придётся учитывать непригодные пары, пропуски, диапазон значений и неопределённость исходного SD. Здесь нет расчёта мощности для обнаружения ненулевого смещения.
Тем более это не размер выборки для точной оценки самих пределов согласия. Если решение о замене прибора зависит от индивидуальных расхождений, планирование только среднего смещения может привести к неверной цели. Сначала назовите параметр, которому нужен узкий интервал, затем выбирайте формулу или моделирование.
При сравнении продуктовых счётчиков тот же принцип помогает договориться о приёмке. Можно оценивать среднее расхождение времени, долю событий за пределами допуска или хвост распределения ошибок. Это разные показатели с разными требованиями к данным. Большой объём не компенсирует отсутствие редких, но критичных типов устройств в выборке.
from math import ceil, sqrt
from scipy.stats import norm
# План точности среднего смещения; SD разностей задана внешними данными.
sd = 2.0
z = norm.ppf(.975)
for half_width in [1., .5]:
    n = ceil((z*sd/half_width)**2)
    print("target_half_width", half_width, "n_approx", n,
          "planned_half_width", round(z*sd/sqrt(n), 6))
Сильные стороны и ограничения книги
По подтверждённому оглавлению книга соединяет базовые процедуры с вопросами, которые возникают при чтении реальных исследований: пропусками, измерениями, оценкой объёма. Для аналитика это ценно как перечень вопросов к проекту. Мы не утверждаем, что все современные варианты методов или вычислительные нюансы полностью закрываются выбранным изданием.
Книга 2015 года не должна заменять актуальную документацию SciPy или инструментов разметки. Код, показанный здесь, написан отдельно. Перед переносом на рабочие данные проверьте, что пары сопоставлены, знак разности фиксирован, единицы одинаковы, а каждый объект действительно независим от остальных. Эти проверки важнее совпадения последнего десятичного знака.
Отдельный предел обзора — отсутствие оценки упражнений полного учебника. Мы можем обосновать выбор по охвату и показать полезность темы на собственных данных, но не обещать, что стиль всех глав подойдёт каждому. Доступный фрагмент и одна самостоятельно разобранная задача помогут выбрать точнее, чем рейтинг «лучшая книга».
С чем читать и как проверить себя
Для самого первого русскоязычного входа можно выбрать Банержи. Для связи анализа с планом исследования — Альтмана. Для оформления результата с интервалами и ясными знаменателями — Ланга и Сесик. Статья о корреляции поможет отдельно закрепить, почему связь двух числовых рядов не равна их согласию.
Проверьте себя без запуска кода. Если к каждому показанию B добавить одну и ту же величину, что произойдёт с корреляцией, смещением и пределами согласия? Корреляция сохранится, средняя разность и оба предела сдвинутся на добавленную величину. Такой мысленный эксперимент полезен перед любым спором о том, какую метрику качества использовать.
Для следующего упражнения составьте собственную таблицу разметки и заранее назовите цену каждого вида разногласия. Рассчитайте процент согласия, затем каппу, а потом попробуйте написать решение без словесной шкалы качества. Если из текста неясно, какие ошибки приемлемы, статистический коэффициент ещё не превращён в критерий приёмки.
Следующий шаг
Выберите один реальный процесс измерения и опишите единицу пары, диапазон применения и допуск. Только после этого собирайте данные и рассчитывайте показатель. Ссылки ниже ведут к соседним темам, но рабочая запись о том, какое решение вы принимаете, остаётся главным результатом этого занятия.
Материал образовательный. Все медицинские примеры синтетические и не задают клинических допусков; рекомендации по диагностике и лечению здесь не рассматриваются.
Материалы по теме
Статьи Гржибовского: маршрут по медицинской статистике
Как читать статистические практикумы Гржибовского и соавторов в «Экологии человека»: проверенные публикации, ограничения и собственные расчёты Python.
Кирквуд и Стерн: Essential Medical Statistics
Обзор Essential Medical Statistics: частоты на человеко-время, стандартизация и кластерные данные. Проверенная библиография и расчёты Python.
Альтман: Practical Statistics for Medical Research
Обзор книги Дугласа Альтмана: план анализа, повторные измерения и несколько проверок. Собственные медицинские и продуктовые примеры в Python.